伴菜と美月のAI教室 — 30 Minutes AI
1. AIは何を覚えているの?
休日の午後。伴菜と美月は、ノートパソコンに並んだ猫と犬の写真を眺めていた。
美月:「ハンナ、3分版では、猫と犬の写真を使ってAIが学習するって教えてもらったよね」
伴菜:「そうね。今日は、AIが学習するとき、コンピューターの中で何が起きているのか、もう少し詳しく見てみようか」
美月:「AIって、猫の写真をたくさん覚えているの?」
伴菜:「写真をそのまま丸暗記するのが目的ではないの。猫と犬を見分けるのに役立つパターンを、モデルの中の数値に反映させていくのよ」
美月:「モデルの中の数値?」
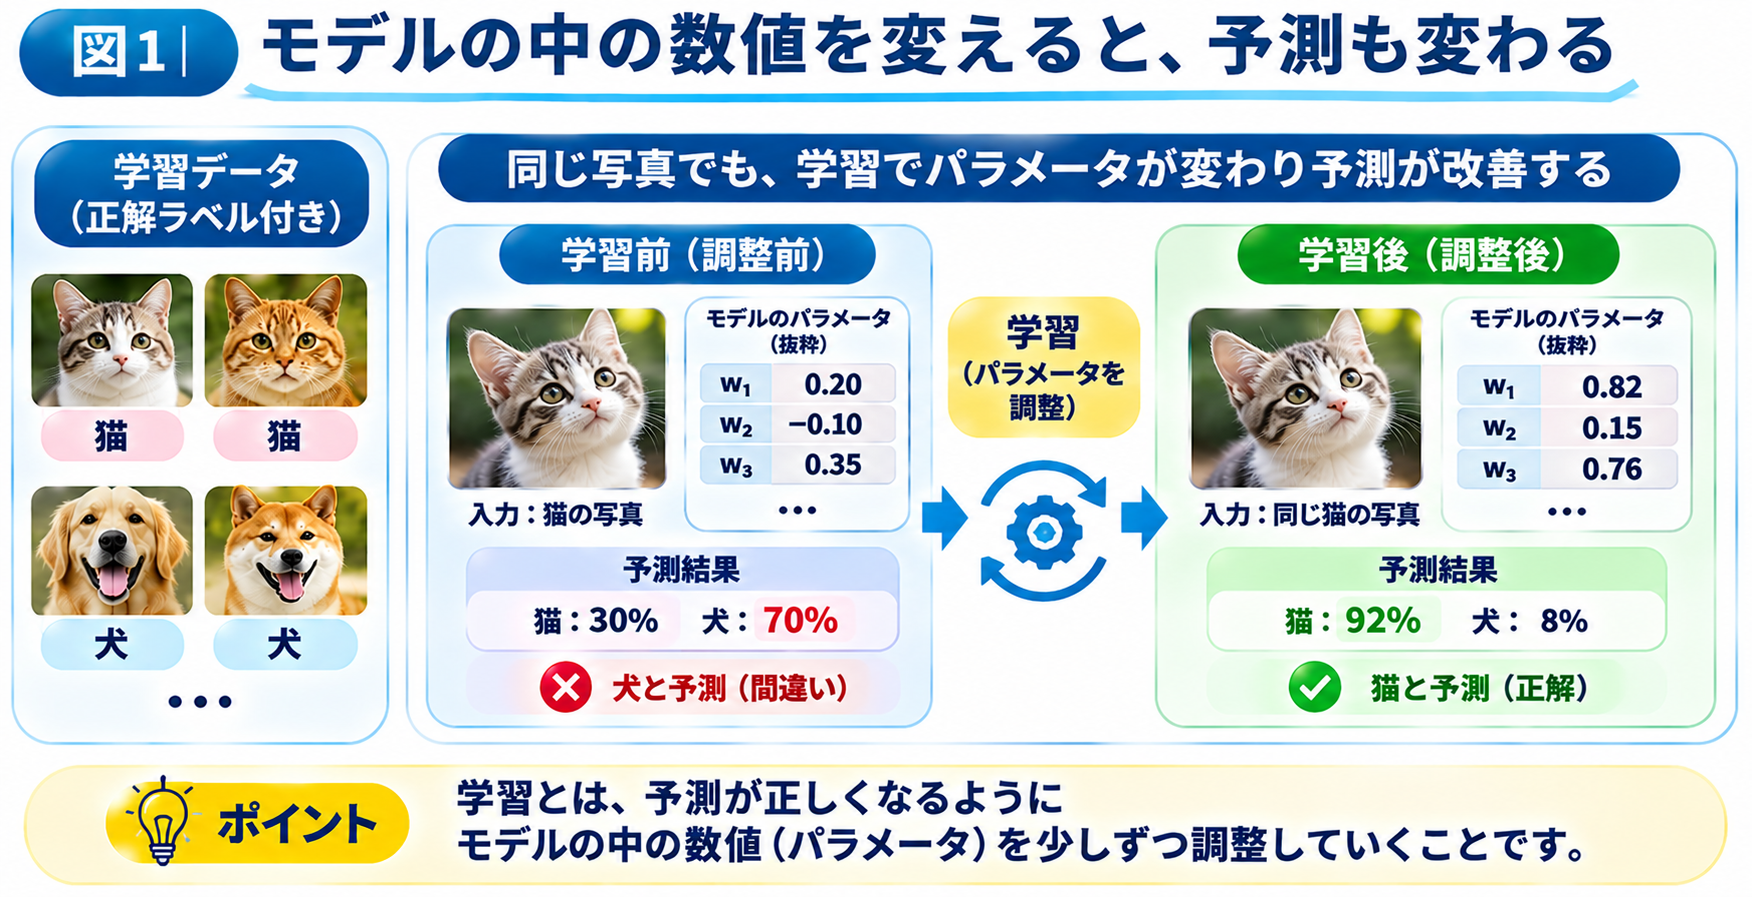
伴菜:「例えば、写真のどんな情報が判断に役立つか、その情報をどのくらい重視するかに関係する数値ね。こうした学習によって調整される数値を『パラメータ』というの」
美月:「じゃあ、AIが勉強するっていうのは、その数値を変えていくことなの?」
伴菜:「多くの機械学習ではそうよ。学習データを使ってパラメータを調整し、目的に合った予測ができるモデルを作るの」
美月:「なるほど。写真を全部覚えるんじゃなくて、見分けるための仕組みを作っているんだね!」
伴菜:「そういうこと。ただし、学習の仕方が悪いと、写真を覚え込みすぎたような状態になることもあるの。それは後で説明するね」
2. 学習データは、どうやって用意するの?
美月:「じゃあ、猫と犬の写真をたくさん集めれば、すぐに学習できるの?」
伴菜:「写真を集めるだけでは不十分なの。どんなデータを使うかがとても大切よ」
美月:「写真なら何でもいいわけじゃないの?」
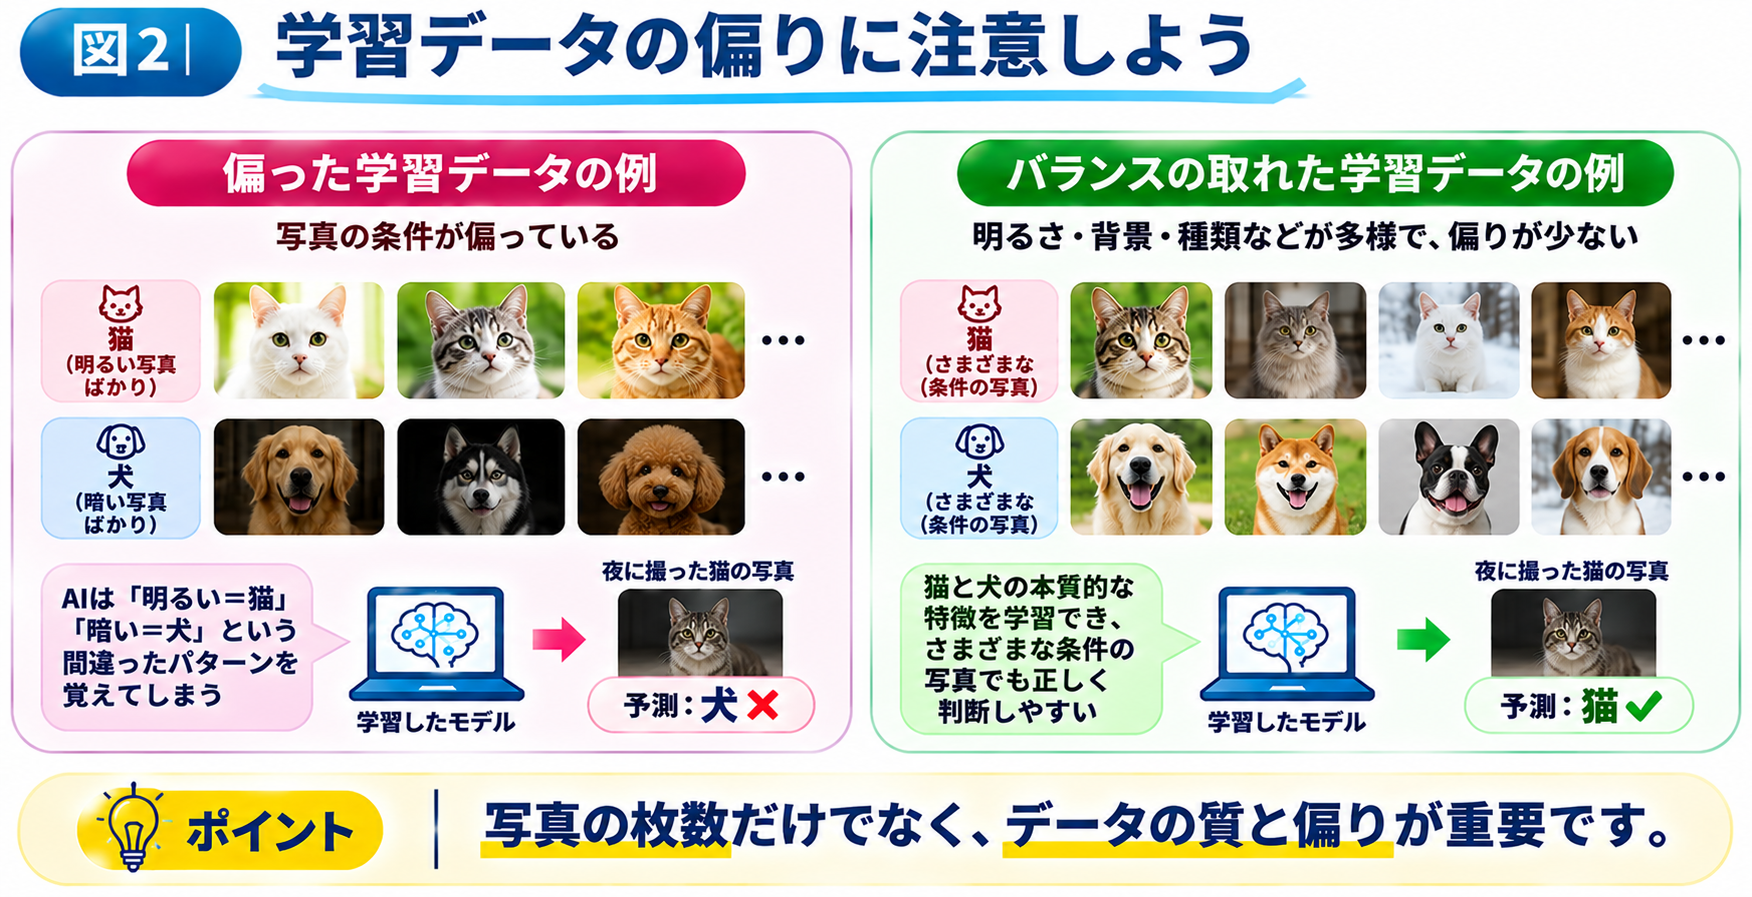
伴菜:「例えば、猫の写真が昼間の明るい場所で撮ったものばかりで、犬の写真が夜の暗い場所で撮ったものばかりだったら、どうなると思う?」
美月:「うーん。明るい写真なら猫、暗い写真なら犬って覚えちゃうかも!」
伴菜:「そうなの。猫と犬の違いではなく、写真の明るさを手がかりにしてしまう可能性があるわ」
美月:「それじゃ、夜に撮った猫を犬と間違えちゃうね」
伴菜:「そうね。だから、猫も犬も、いろいろな色、大きさ、角度、背景、明るさの写真を用意することが大切なの」
美月:「正解の『猫』『犬』も付けるんだよね?」
伴菜:「そのとおり。今回のような教師あり学習では、写真と正解ラベルを組み合わせるの。ラベルが間違っていたら、それも学習に悪い影響を与える可能性があるわ」
美月:「写真の枚数だけじゃなくて、内容と正解の正しさも重要なんだね!」
伴菜:「大正解。データの量だけを増やしても、必ず性能が上がるわけではないのよ」
3. AIはどうやって間違いを直すの?
美月:「データの準備ができたら、いよいよ学習だね!」
伴菜:「そうね。猫の写真をモデルに入力してみましょう」
美月:「あれ? 猫なのに、犬の可能性が80%って出てる!」
伴菜:「まだ十分に学習していないモデルなら、そんな予測をすることもあるわ」
美月:「でも、正解は猫だよね。どうやって直すの?」
伴菜:「まず、モデルの予測と正解がどれくらい違うかを数値で表すの。その違いを評価するための計算を『損失関数(Loss Function)』というのよ」
美月:「損失って、何かをなくしちゃったの?」
伴菜:「ここでは、お金や物を失う意味じゃないの。予測がどれくらいうまくいっていないかを表す数値だと思ってね」
美月:「じゃあ、その数値が小さくなればいいんだ!」
伴菜:「基本的にはそう。そこで、損失が小さくなる方向にパラメータを調整するの」
美月:「どの数値を変えればいいか、どうやって分かるの?」
伴菜:「代表的な方法が『勾配降下法(Gradient Descent)』よ。損失が小さくなる方向を計算して、パラメータを少しずつ動かしていくの」
美月:「難しそう……」
伴菜:「山を下りるところを想像してみて。今いる場所から、下り坂の方向を調べて少し進む。それを繰り返すイメージよ」
美月:「ああ! いきなり正解の場所に飛ぶんじゃなくて、少しずつ良くしていくんだ!」
伴菜:「そういうこと。ただし、必ず一番良い答えにたどり着けるわけではないし、進む幅の決め方も重要なのよ」
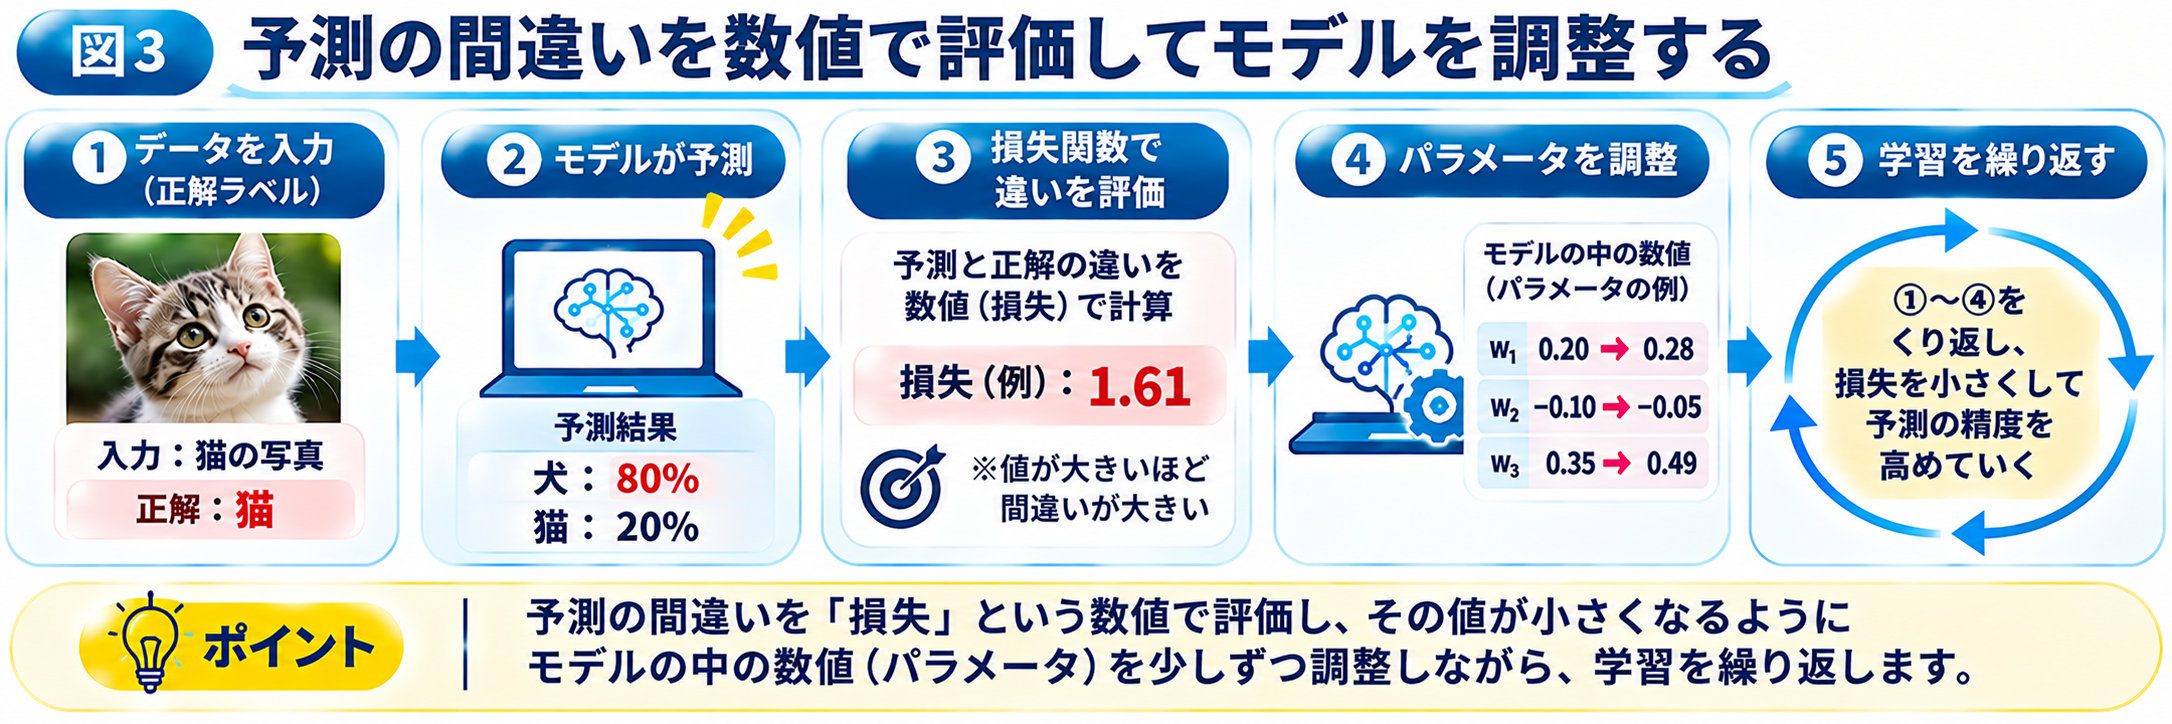
※「犬80%」は説明用の架空の予測値です。実際の学習方法や損失関数はモデルによって異なります。
4. 学習を繰り返せば、必ず賢くなるの?
美月:「じゃあ、何回も学習を繰り返せば、どんどん正確になるんだね!」
伴菜:「必ずしもそうとは限らないの。ここで『過学習(Overfitting)』という問題が出てくるわ」
美月:「過学習? 勉強しすぎってこと?」
伴菜:「そういうイメージね。例えば、美月が問題集の答えを全部覚えたとするでしょう?」
美月:「同じ問題なら満点だよ!」
伴菜:「でも、数字や文章を少し変えた問題が出たら?」
美月:「解き方を理解していなかったら、間違えるかも……」
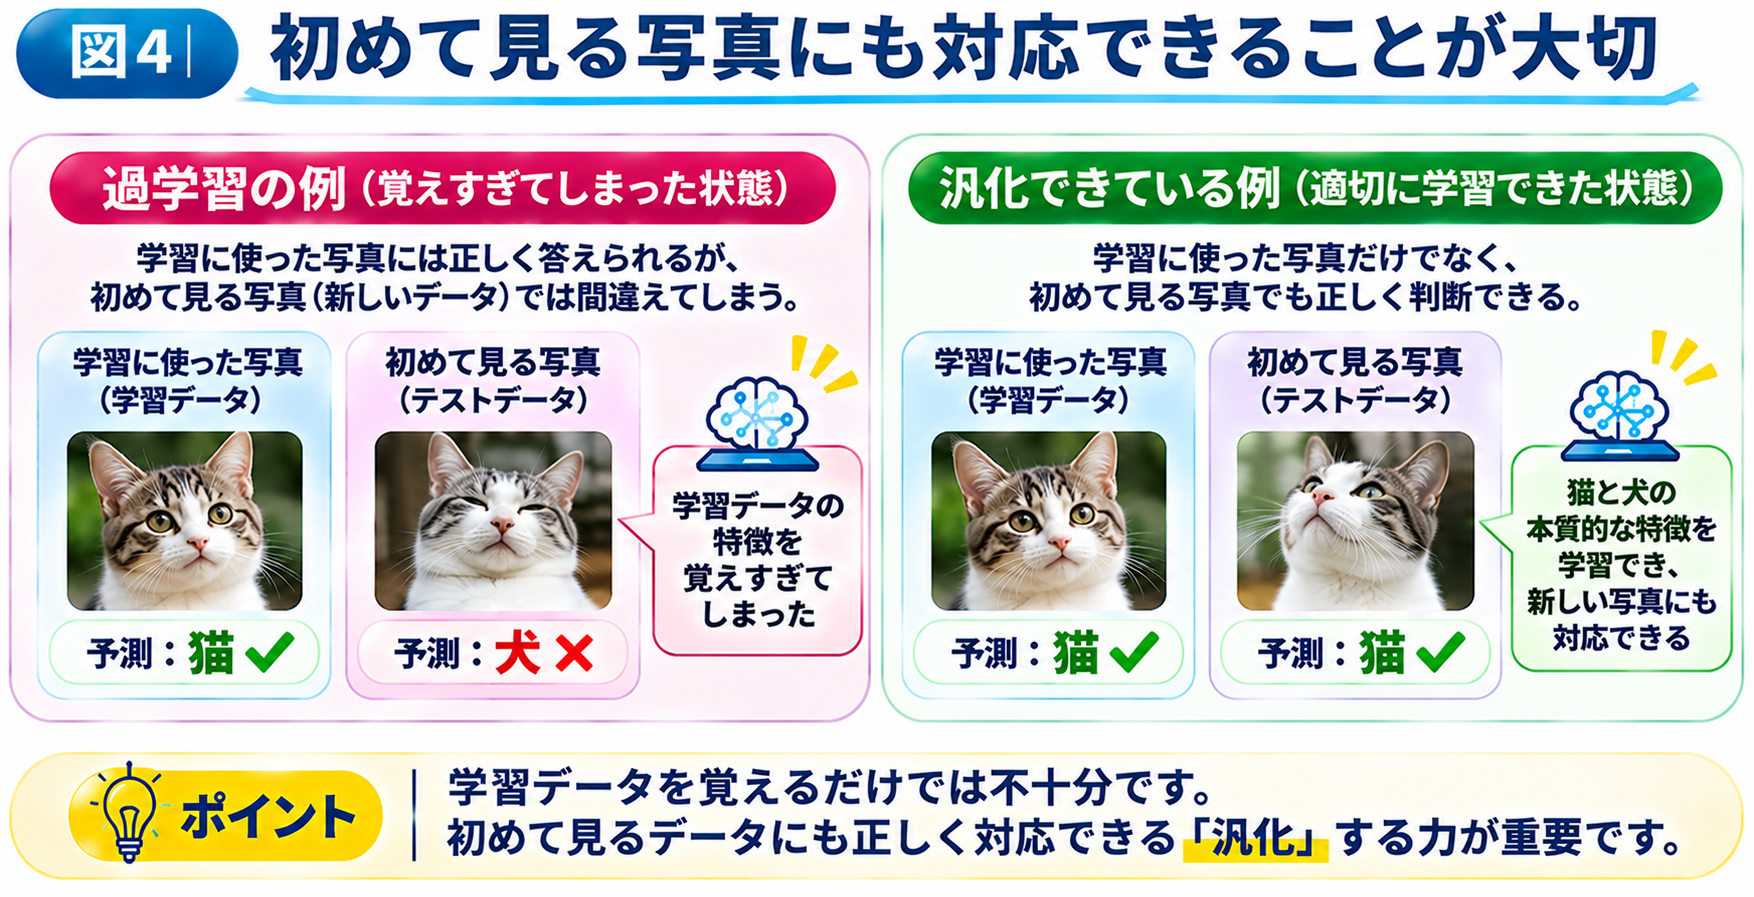
伴菜:「AIも似ているの。学習に使った写真には非常によく対応できても、新しい写真では間違いが多いことがあるのよ」
美月:「それが過学習なんだ!」
伴菜:「そう。だから、学習に使ったデータでの成績だけを見て、成功したとは判断できないの」
美月:「じゃあ、初めて見る写真でもテストする必要があるんだね」
伴菜:「そのとおり。大切なのは、学習したデータ以外にも対応できること。この性質を『汎化(Generalization)』というのよ」
5. 学習用・検証用・テスト用って何が違うの?
美月:「ハンナ、初めて見る写真で試すのは分かったけど、いつ試せばいいの?」
伴菜:「いい質問ね。機械学習では、データを目的別に分けて使うことが多いの」
美月:「どう分けるの?」
伴菜:「代表的なのが『学習用』『検証用』『テスト用』の3つよ」
美月:「全部テストみたいな名前だね(笑)」
伴菜:「まず、学習用データはモデルのパラメータを学習するために使うの」
美月:「これはいつもの練習問題だね!」
伴菜:「そう。次に検証用データは、学習方法やモデルの設定を選ぶときに使うの」
美月:「模擬試験みたいなもの?」
伴菜:「近いわね。例えば、どのモデルを採用するか、どの時点で学習を止めるかを判断する材料にするの」
美月:「じゃあ、テスト用は本番の試験?」
伴菜:「そう考えると分かりやすいわ。モデルの選択や調整が終わったあとに、最終的な性能を確認するためのデータなの」
美月:「テストの問題を先に見ながら練習したら、ずるいもんね!」
伴菜:「そのとおり。テスト用データの結果を何度も見てモデルを調整すると、公平な評価ができなくなる可能性があるのよ」
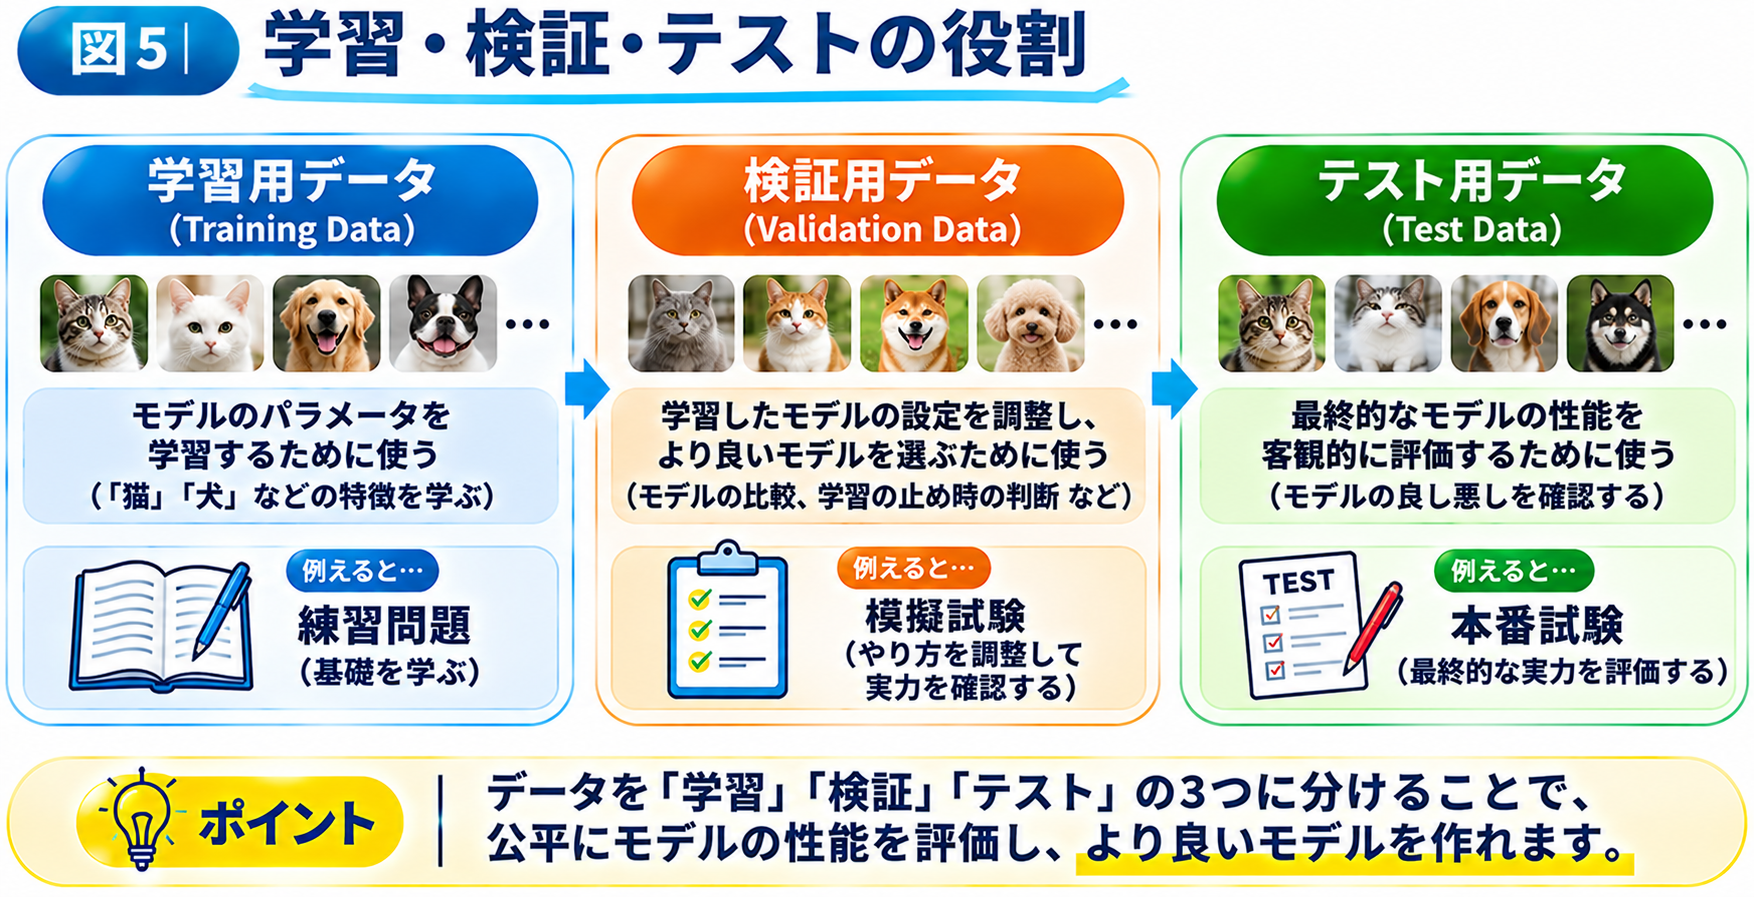
※3分割は代表的な方法です。データが少ない場合などには交差検証など別の評価方法も使われます。また、データの分け方では同じ対象からの類似画像が別グループに混ざることなどにも注意が必要です。
6. 正答率が高ければ、良いAIなの?
美月:「よし! テスト用の写真でも正しく判定できたら、AIの完成だね!」
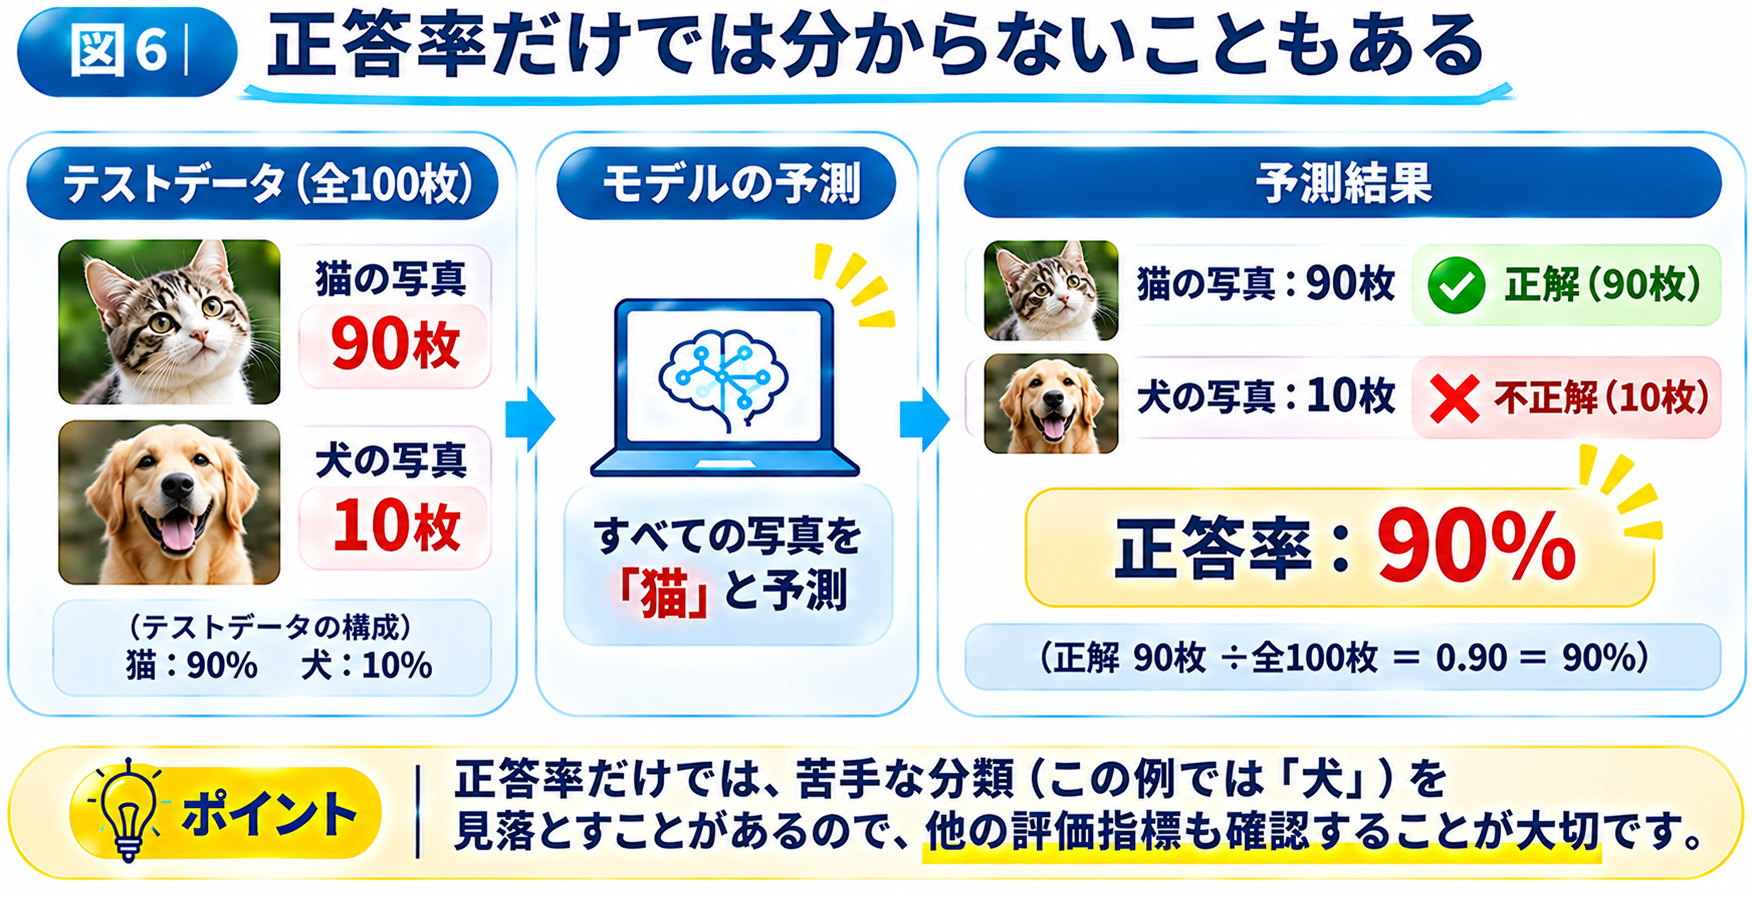
伴菜:「性能を数字で確認することも大切よ。例えば、100枚の写真のうち90枚を正しく分類できたら、正答率は90%ね」
美月:「90%なら、かなり良さそう!」
伴菜:「そうね。でも、数字だけでは分からないこともあるの」
美月:「えっ、90%なのに?」
伴菜:「例えば、100枚のうち90枚が猫で、10枚が犬だったとするでしょう。全部『猫』と答えるだけでも、正答率は90%になってしまうの」
美月:「あっ! 犬は一匹も当てられていないのに!」
伴菜:「そう。だから、正答率だけでなく、猫と犬をそれぞれどのくらい正しく見分けられたかも確認する必要があるの」
美月:「なるほど。数字が高いからって、すぐに良いモデルだとは言えないんだね」
伴菜:「そのとおり。何を正しく判断したいのかによって、適切な評価方法も変わるのよ」
7. 今日のまとめ
伴菜:「さて、美月。今日はAIの学習をかなり詳しく見てきたけど、どうだった?」
美月:「最初は、猫と犬の写真をたくさん見せればいいと思ってたけど、それだけじゃないんだね」
伴菜:「どんなことが大切だった?」
美月:「まず、偏りの少ない学習データを用意すること。次に、予測と正解を比べて、モデルの数値を調整すること!」
伴菜:「うんうん。それから?」
美月:「学習した写真だけを覚えてもダメ。初めて見る写真で正しく判断できるか確かめる!」
伴菜:「大正解。じゃあ、正答率が90%だったら?」
美月:「すぐに安心しちゃダメ! 猫と犬のどちらもちゃんと見分けられているか確認する!」
伴菜:「完璧ね」
美月:「なんだか、AIを作る人って、先生みたいだね。教材を準備して、教えて、テストして……」
伴菜:「そうね。でも、AIは人間の生徒とは違うから、何を学んだのか、どんな間違いをするのかを数字でも確かめる必要があるのよ」
美月:「よーし! 私もAIに負けないように勉強する!」
伴菜:「その意気よ。でも、まずは今日の復習クイズからね!」
もっと知りたい! AI用語集
美月:「ハンナ、今日は知らない言葉がいっぱい出てきたね!」
伴菜:「難しい言葉は、AI用語集で一つずつ確認してみてね」
今回の関連用語:
- 機械学習(Machine Learning)
- 学習データ(Training Data)
- 教師あり学習(Supervised Learning)
- モデル(Model)
- パラメータ(Parameter)
- 損失関数(Loss Function)
- 勾配降下法(Gradient Descent)
- 過学習(Overfitting)
- 汎化(Generalization)
理解度チェック(30 Minutes AI 第2話)
伴菜と美月のAI教室へようこそ!
30 Minutes AI 第2話「AIはどうやって勉強するの?」の理解度チェックです。
全5問のクイズで、学習データ、モデルの調整、過学習、データの分割、性能評価について振り返ってみましょう。
基本から復習したい人へ
ここまでで、AIが学習データからどのように学ぶのか、予測の間違いを減らす仕組み、過学習、そして学習結果の評価方法まで詳しく学んだよ。
「ちょっと難しかったな」「もう一度、学習の基本的な流れを整理したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!
次回予告
第3話|教師あり学習と教師なし学習って何が違うの?
美月:「ハンナ、今日の猫と犬の写真には、全部正解が付いていたよね?」
伴菜:「そうね。でも、AIには正解を教えずにデータの特徴を見つける学習方法もあるのよ」
美月:「えっ! 正解がなくても勉強できるの?」
伴菜:「次回は、その違いを詳しく見てみましょう!」
「30 mins AI 第2話|AIはどうやって勉強するの?」への1件の返信
[…] → 30 Minutes AI 第2話へ […]