伴菜と美月のAI教室|学習時間:約30分(解説・図解・理解度チェックを含む)
はじめに
前回の3 Minutes AIでは、教師あり学習と教師なし学習の基本的な違いを学んだね。
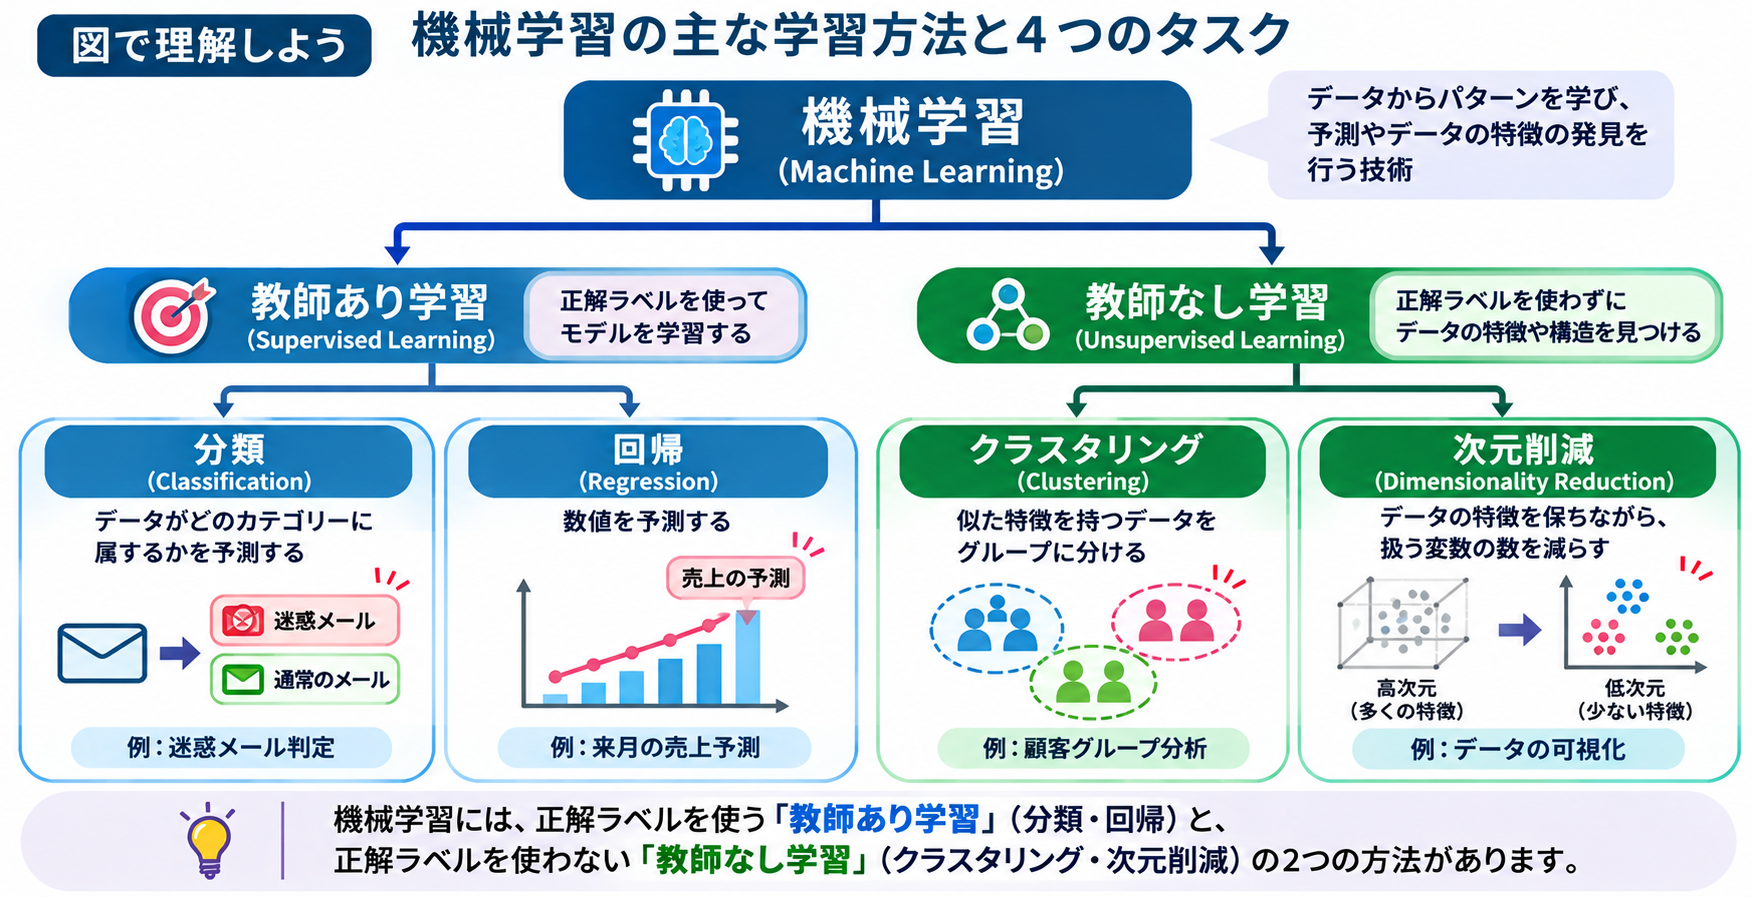
教師あり学習は、正解となる情報を使ってモデルを学習させる方法。
教師なし学習は、正解ラベルを使わずに、データの中にある特徴やパターンを見つける方法。
でも、実際にAIを使おうとすると、こんな疑問が出てくるよね。
「売上を予測したいときは、どちらを使えばいいの?」
「顧客をグループに分けたいときは?」
「分類とクラスタリングは、どちらもグループ分けなのに何が違うの?」
今回は、伴菜と美月と一緒に、4つの代表的な機械学習のタスクを詳しく見ていこう!
1. 教師あり学習と教師なし学習をおさらい
美月:「ハンナ、教師あり学習と教師なし学習の違いは分かったつもりなんだけど、実際にはどうやって使い分けるの?」
伴菜:「まず考えるのは、何を知りたいのか、そして学習に使えるデータに正解が付いているかどうかよ」
美月:「正解が付いていれば教師あり学習で、付いていなければ教師なし学習?」
伴菜:「基本的にはそう考えていいわ。ただし、正解ラベルがないから必ず教師なし学習というわけではないの。目的によっては、人間がラベルを付けたり、別の学習方法を選んだりすることもあるのよ」
美月:「なるほど。データだけじゃなくて、何をしたいのかも大事なんだね」
伴菜:「そのとおり。例えば、将来の売上を予測するのと、似た顧客を探すのでは、解決したい問題が違うでしょう?」
4つの代表的なタスク
| 学習方法 | タスク | 主な目的 | 具体例 |
|---|---|---|---|
| 教師あり学習 | 分類 | カテゴリーを予測する | 迷惑メール判定 |
| 教師あり学習 | 回帰 | 数値を予測する | 売上予測 |
| 教師なし学習 | クラスタリング | 似たデータをまとめる | 顧客グループ分析 |
| 教師なし学習 | 次元削減 | データの変数を減らす | データの可視化 |
2. 分類(Classification)とは?
美月:「まずは分類から教えて。猫と犬を見分けるのも分類なんだよね?」
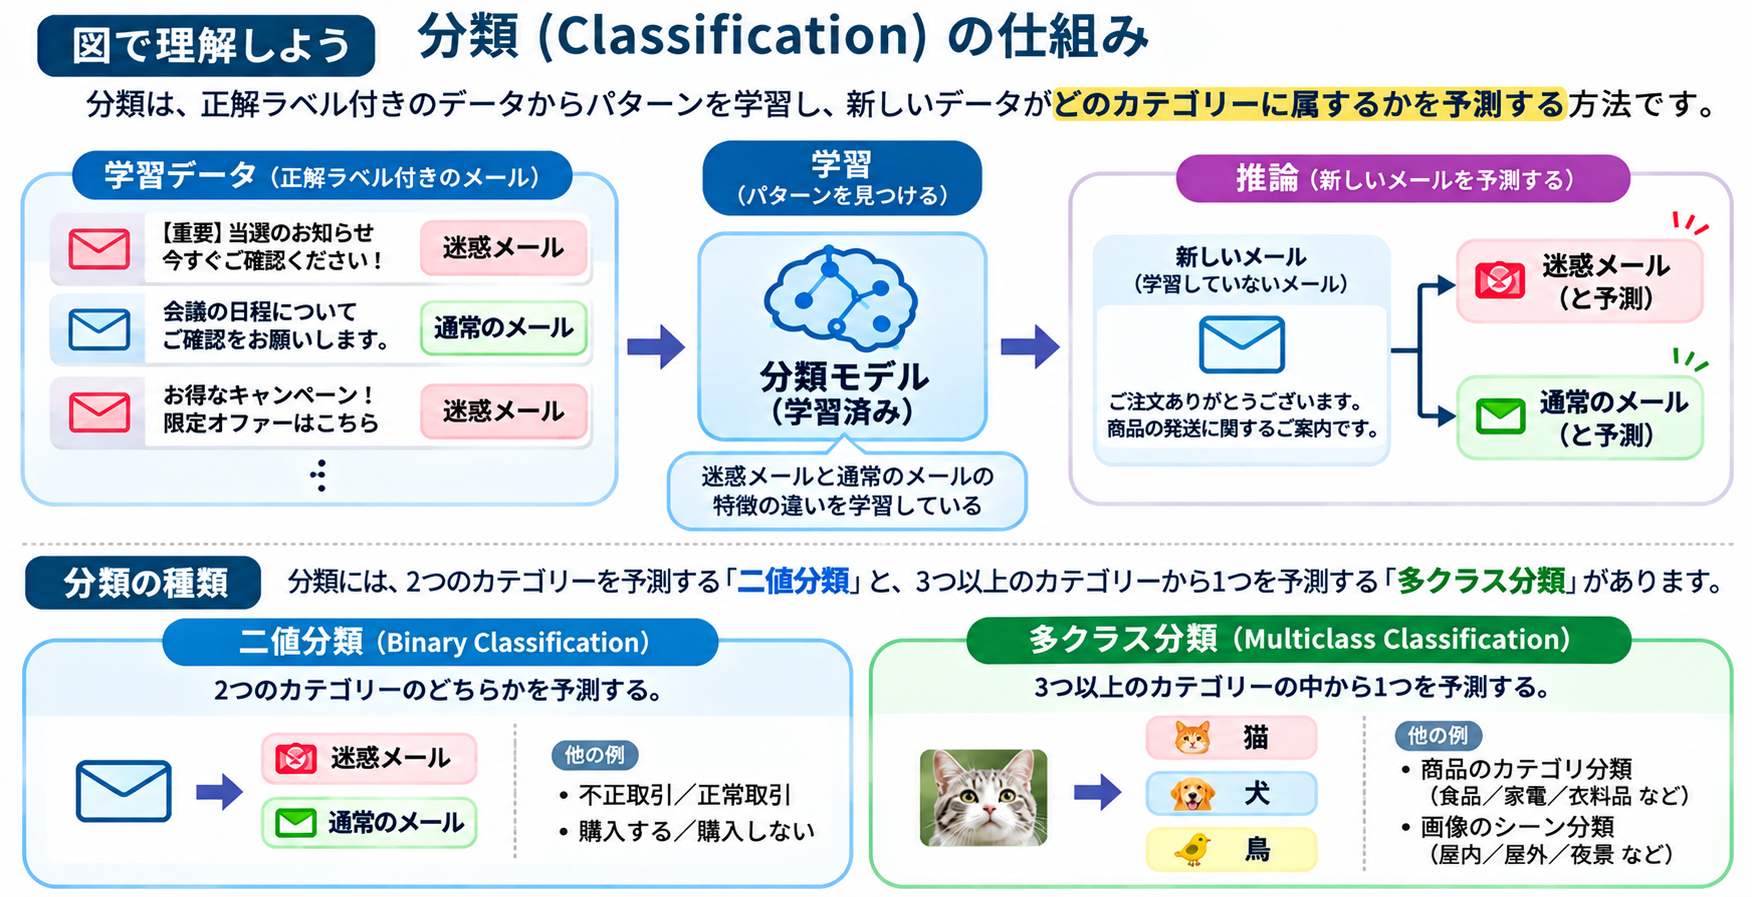
伴菜:「そうよ。分類は、入力されたデータが、あらかじめ決められたカテゴリーのどれに属するかを予測する方法なの」
美月:「例えば、メールが迷惑メールかどうかを判断するのも?」
伴菜:「そのとおり。過去のメールと正解ラベルを使って学習したモデルが、新しいメールを判定するのよ」
美月:「でも、迷惑メールっぽい普通のメールもあるよね?」
伴菜:「もちろん。だからモデルは間違えることもあるの。予測結果がどれくらい正しいかを評価することが大切なのよ」
分類の仕組み
美月:「ハンナ、分類って、実際にはどうやって正しいカテゴリーを判断しているの?」
伴菜:「例えば、迷惑メールを判定するAIを考えてみましょう。まず、過去のメールをたくさん用意して、それぞれに『迷惑メール』か『通常のメール』という正解ラベルを付けるのよ」
美月:「メールの内容と正解をセットにして教えるんだね!」
伴菜:「そうよ。AIはメールの文章や送信者などの情報と、正解ラベルの関係を学習するの。そして、新しいメールが届いたときに、学習したパターンを使って、どちらのカテゴリーに属するかを予測するのよ」
美月:「じゃあ、初めて見るメールでも、学習した特徴を使って判断できるんだ!」
伴菜:「そのとおり。ただし、学習したことのないパターンが出てきたり、迷惑メールの手口が変わったりすると、予測を間違えることもあるわ。だから、学習したモデルが新しいデータにも対応できるかを確認することが大切なのよ」
二値分類と多クラス分類
美月:「ところで、分類って、いつも2つのカテゴリーから選ぶの?」
伴菜:「いいえ。分類するカテゴリーの数によって、いくつかの種類があるのよ」
美月:「どんな種類があるの?」
伴菜:「まず、2つのカテゴリーのどちらかを予測する方法を、**二値分類(Binary Classification)**というの。例えば、メールを『迷惑メール』と『通常のメール』に分けたり、取引を『不正取引』と『正常取引』に分けたりする場合ね」
美月:「なるほど。じゃあ、猫と犬と鳥の3種類を見分ける場合は?」
伴菜:「それは、**多クラス分類(Multiclass Classification)**ね。3つ以上のカテゴリーの中から、1つを予測する方法なのよ」
美月:「じゃあ、1枚の写真に猫と犬が両方写っていたら、どうなるの?」
伴菜:「そこに気付くのは大事ね。1つのデータに複数のラベルを付けたい場合には、**マルチラベル分類(Multilabel Classification)**という方法があるのよ」
美月:「つまり、猫と犬が両方写っている写真なら、『猫』と『犬』の両方を予測できるんだね!」
伴菜:「そうよ。整理すると、二値分類は2つから1つ、多クラス分類は3つ以上から1つ、マルチラベル分類は複数のラベルを同時に予測できる方法なの」
美月:「同じ分類でも、予測したい答えの種類によって方法が違うんだね!」
分類モデルはどう評価する?
美月:「ハンナ、分類モデルがちゃんと学習できたかどうかは、どうやって確認するの?」
伴菜:「いい質問ね。学習に使っていない評価用のデータを使って、モデルの予測と実際の正解を比較するのよ」
美月:「何問中、何問正解したかを調べる感じ?」
伴菜:「そうね。それが**正解率(Accuracy)**よ。例えば、100件のメールのうち90件を正しく判定できたら、正解率は90%になるわ」
美月:「90%なら、かなり優秀なんじゃない?」
伴菜:「そう思うでしょう? でも、正解率だけでは分からないこともあるのよ」
美月:「えっ、どういうこと?」
伴菜:「例えば、100件のメールのうち95件が通常のメールで、迷惑メールが5件だったとするでしょう? もしAIが全部を『通常のメール』と判定しても、正解率は95%になるの」
美月:「ええっ! 迷惑メールを1件も見つけていないのに95%なの?」
伴菜:「そうなの。だから、どんな間違いをしているのかも確認する必要があるのよ」
美月:「じゃあ、ほかにはどんな評価方法があるの?」
伴菜:「代表的なのが、**適合率(Precision)と再現率(Recall)**よ。迷惑メールを検出する場合で説明するわね」
伴菜:「適合率は、AIが『迷惑メール』と判定したメールのうち、実際に迷惑メールだった割合なの」
美月:「つまり、迷惑メールだと言ったときに、どれくらい当たっているかってこと?」
伴菜:「そのとおり。適合率が低いと、大切なメールまで迷惑メールと判定してしまう可能性が高くなるわ」
美月:「それは困るね。大事な連絡を見逃しちゃうかもしれない!」
伴菜:「一方、再現率は、実際に迷惑メールだったもののうち、AIがどれくらい見つけられたかを表すのよ」
美月:「再現率が低いと、迷惑メールをたくさん見逃してしまうんだね」
伴菜:「そうよ。そして、適合率と再現率の両方を考慮する代表的な指標が、**F1スコア(F1 Score)**なの。これは2つの値の調和平均で計算するのよ」
美月:「なるほど! 正解率だけじゃなくて、間違い方も大切なんだね」
伴菜:「そのとおり。重要なメールを迷惑メールに振り分ける間違いと、迷惑メールを見逃す間違いでは、影響が違うでしょう? だから、AIを何に使うのかによって、重視する評価指標も変わるのよ」
美月:「AIの評価って、単に正解が多ければいいというわけじゃないんだね!」
3. 回帰(Regression)とは?
美月:「じゃあ、回帰って何なの? 分類とは違うの?」
伴菜:「分類がカテゴリーを予測するのに対して、回帰は数値を予測する方法なのよ」
美月:「数値って、例えばテストの点数とか?」
伴菜:「そうね。ほかにも、住宅価格や将来の売上金額、電力消費量などを予測するときに使われるの」
美月:「売上を予測できるなら、お店の経営にも役立ちそう!」
伴菜:「そうよ。ただし、予測はあくまで予測なの。過去のデータにない大きな変化が起きると、予測が外れることもあるわ」
回帰の仕組み
美月:「ハンナ、分類は『迷惑メールかどうか』みたいにカテゴリーを予測するんだよね。じゃあ、回帰はどうやって数値を予測するの?」
伴菜:「例えば、お店の来月の売上を予測するとしましょう。過去の売上金額や来店客数、広告費、曜日などのデータを使って、売上に関係するパターンを学習するのよ」
美月:「広告費が多い月は売上も増えるとか、週末はお客さんが多いとか、そういう関係を見つけるんだね!」
伴菜:「そうよ。そして、学習したモデルに新しい条件を入力すると、売上金額を予測できるの。例えば『来月の売上は450万円』というように、数値で結果が出るのよ」
美月:「なるほど! 分類なら『売上が高い・低い』だけど、回帰なら『450万円』みたいに具体的な金額を予測するんだ!」
伴菜:「そのとおり。分類はカテゴリーを予測し、回帰は数値を予測する。これが大きな違いなのよ」
線形回帰(Linear Regression)
美月:「でも、AIはどうやって売上金額を計算するの?」
伴菜:「回帰にはいろいろな方法があるけれど、代表的なのが**線形回帰(Linear Regression)**よ」
美月:「線形って、直線のこと?」
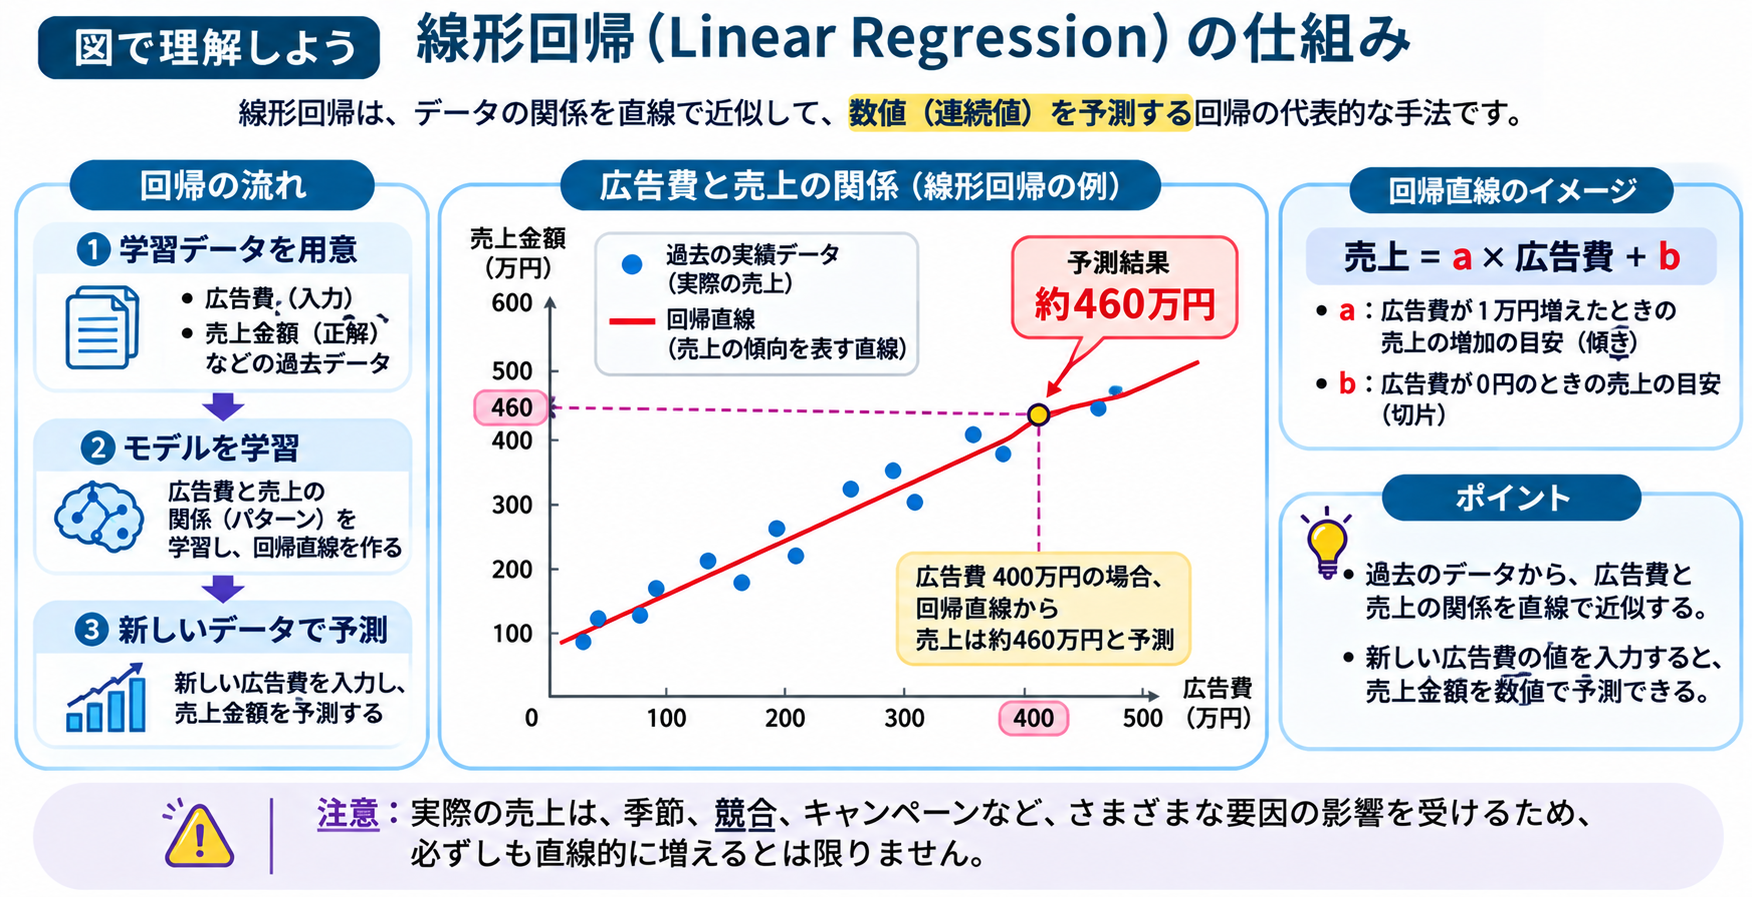
伴菜:「そうよ。例えば、横軸に広告費、縦軸に売上金額を取って、過去の実績を点で描いてみるの。もし広告費が増えるほど売上も増える傾向があれば、点の並びを直線で近似できることがあるわ」
美月:「点がたくさんあって、その真ん中あたりを直線が通るイメージかな?」
伴菜:「そうね。ただし、適当に直線を引くわけではないの。一般的な線形回帰では、実際の値と直線による予測値の差を二乗して合計し、その値ができるだけ小さくなるように直線を求めるのよ。これを**最小二乗法(Least Squares Method)**というの」
美月:「なるほど! できるだけ実際のデータに合う直線を計算するんだね」
伴菜:「そのとおり。そして、新しい広告費をその直線に当てはめると、売上金額を予測できるのよ」
美月:「例えば、広告費が400万円だったら、売上が460万円になると予測するような感じ?」
伴菜:「そうよ。図の例ではそういう予測になっているわ。ただし、これは説明のための仮のデータなの。実際の売上は季節や競合、キャンペーンなど、いろいろな要因の影響を受けるから、広告費だけで正確に予測できるとは限らないのよ」
美月:「そうだよね。広告を増やせば必ず売上が増えるわけじゃないもんね」
伴菜:「そのとおり。それに、線形回帰で関係が見つかったとしても、広告費が売上増加の原因だと証明できたわけではないことにも注意が必要よ」
回帰モデルはどう評価する?
美月:「ハンナ、回帰モデルが予測した売上金額が正しいかどうかは、どうやって評価するの?」
伴菜:「分類では正解率などを使ったけれど、回帰では予測値と実際の値がどれくらい違うかを調べるのよ」
美月:「例えば、450万円と予測したのに、実際は400万円だったら、50万円外れたってこと?」
伴菜:「そうよ。その差を予測誤差というの。回帰モデルでは、こうした誤差を複数のデータで調べて評価するのよ」
美月:「どんな評価方法があるの?」
伴菜:「代表的なのは、MAE、MSE、RMSEの3つね。順番に説明するわ」
MAE(平均絶対誤差)
伴菜:「まず、**MAE(Mean Absolute Error:平均絶対誤差)**は、予測がどれくらい外れたかを、誤差の絶対値で平均したものなの」
美月:「絶対値って、マイナスを気にせず、差の大きさだけを見るんだよね?」
伴菜:「そうよ。例えば、3か月分の売上予測で、実際との差がプラス10万円、マイナス20万円、プラス30万円だったとするでしょう?」
美月:「差の大きさは10万円、20万円、30万円だから、平均すると20万円だね!」
伴菜:「正解! この場合、MAEは20万円になるの。予測が平均してどのくらい外れているかを、元の売上と同じ単位で理解しやすい指標なのよ」
MSE(平均二乗誤差)
美月:「じゃあ、MSEは何が違うの?」
伴菜:「**MSE(Mean Squared Error:平均二乗誤差)**は、予測誤差をそれぞれ二乗してから平均するのよ」
美月:「二乗するってことは、10万円の誤差なら100、20万円なら400、30万円なら900になるんだね?」
伴菜:「そうよ。今回の例なら、100、400、900を平均して、約466.7になるわ。単位は万円の二乗になるのよ」
美月:「でも、どうしてわざわざ二乗するの?」
伴菜:「大きな誤差を、より強く評価に反映させるためよ。例えば、10万円の誤差と30万円の誤差では、二乗すると100と900になるでしょう? 大きく外れた予測の影響が強くなるの」
美月:「なるほど! 大きな予測ミスを特に問題にしたいときに役立つんだね」
RMSE(二乗平均平方根誤差)
美月:「じゃあ、RMSEは?」
伴菜:「**RMSE(Root Mean Squared Error:二乗平均平方根誤差)**は、MSEの平方根を取ったものなの」
美月:「平方根を取ると、どうなるの?」
伴菜:「MSEは誤差を二乗しているから、元の売上金額とは単位が違ってしまうでしょう? 平方根を取ると、元の単位に戻せるのよ」
美月:「じゃあ、今回のMSEが約466.7なら、RMSEは?」
伴菜:「約21.6万円になるわ。MAEと同じように金額で理解できるけれど、大きな誤差の影響をより強く受けるという特徴があるのよ」
美月:「なるほど! MAEは誤差の大きさを平均して、MSEは二乗して大きな誤差を重く扱う。RMSEはその平方根を取って、元の単位で表すんだね!」
伴菜:「完璧よ。ただし、どの指標が最適かは、予測の目的や大きな誤差をどれくらい重視するかによって変わるの。評価指標は、目的に合わせて選ぶことが大切なのよ」
4. クラスタリング(Clustering)とは?
美月:「教師なし学習のクラスタリングって、分類と似ているよね?」
伴菜:「そう見えるわよね。でも、分類は正解ラベルを使って決められたカテゴリーを予測するのに対して、クラスタリングはデータの特徴からグループを見つけるのよ」
美月:「例えば、どんなことに使えるの?」
伴菜:「ネットショップの顧客を、購入履歴や購入頻度などからグループに分けることができるわ」
美月:「よく買い物する人と、たまに買う人を分ける感じ?」
伴菜:「そうね。ただし、どんなグループができるかは、使うデータや分析方法によって変わるのよ」
クラスタリングの仕組み
美月:「ハンナ、クラスタリングって、似ているデータをグループに分けるんだよね。でも、何を基準に似ているって判断するの?」
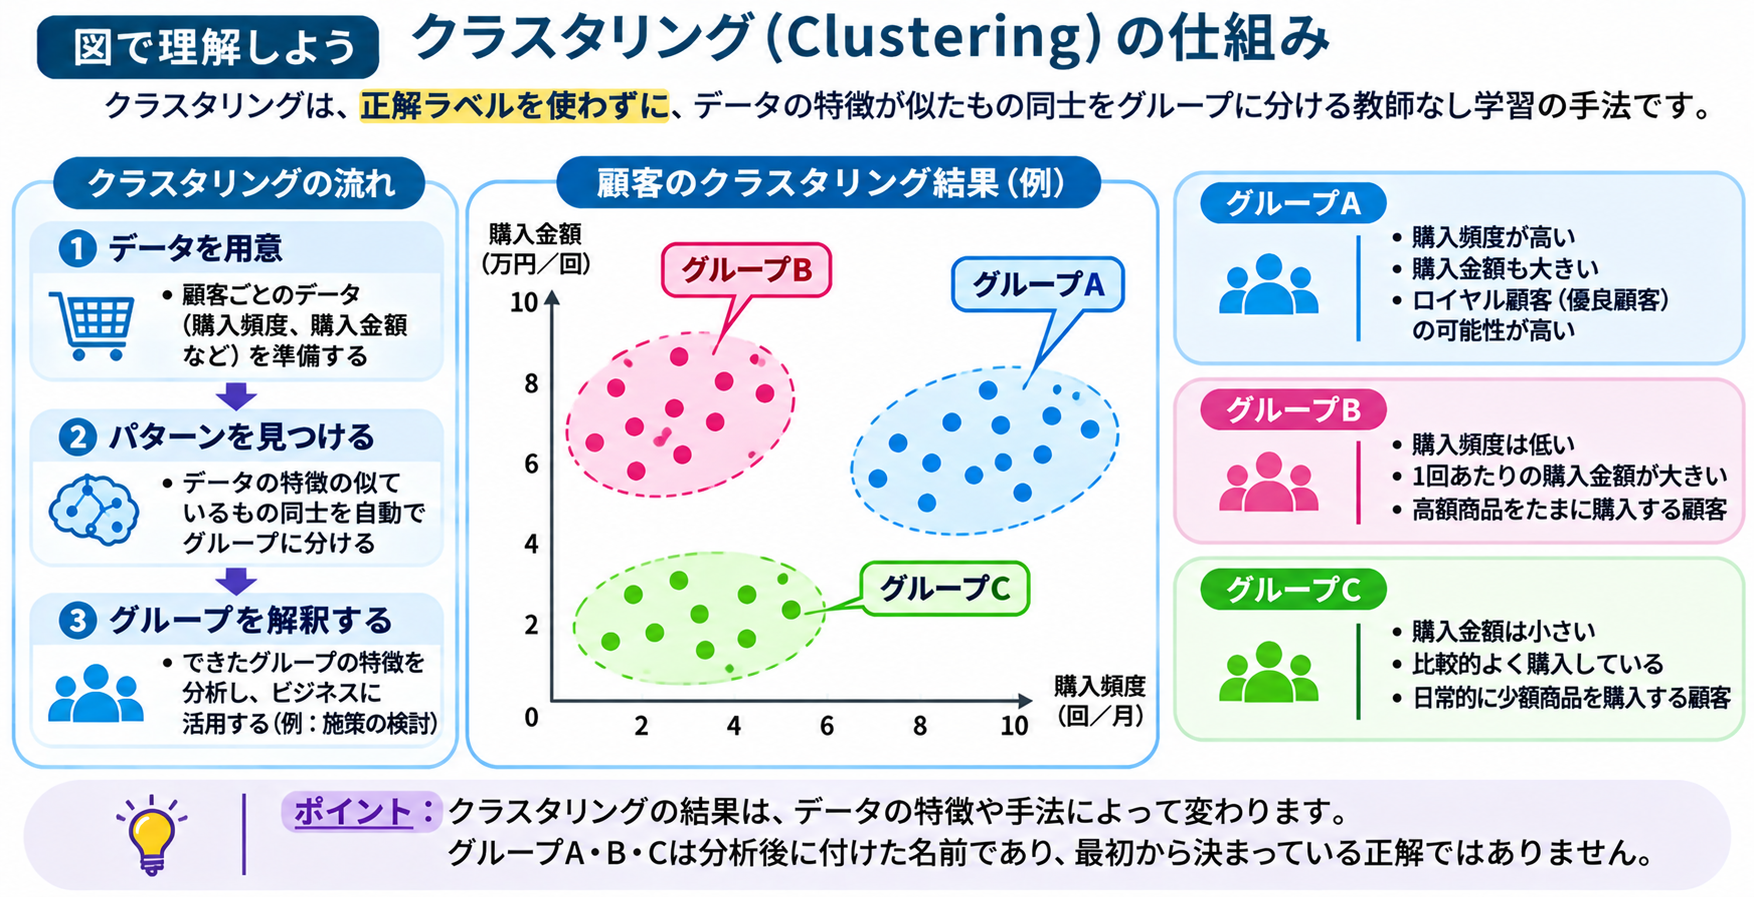
伴菜:「例えば、ネットショップの顧客を分析する場合を考えてみましょう。顧客ごとに、購入金額や購入頻度、どんな商品を買っているかといったデータがあるでしょう?」
美月:「うん。毎週買い物する人もいれば、たまに高い商品を買う人もいるよね」
伴菜:「そうね。クラスタリングでは、そうした特徴を数値として表して、似た特徴を持つ顧客同士をグループにまとめるのよ」
美月:「例えば、どんなグループができるの?」
伴菜:「分析の結果として、こんなグループが見つかるかもしれないわ」
- グループA: 購入頻度が高く、購入金額も大きい顧客
- グループB: 購入頻度は低いけれど、一度の購入金額が大きい顧客
- グループC: 少額の商品を定期的に購入する顧客
美月:「なるほど! お客さんの買い物の仕方によって、グループができるんだね!」
伴菜:「そのとおり。でも、ここで大切なのは、最初から『この人はグループA』という正解を教えているわけではないことなの」
美月:「じゃあ、AIがグループを作ってから、人間がその特徴を調べるの?」
伴菜:「そうよ。例えば、あるグループには購入頻度の高い顧客が多いと分かったら、人間が『リピーター層』と名前を付けることもできるわ」
美月:「つまり、グループの名前はAIが最初から知っているわけじゃないんだね」
伴菜:「そのとおり。クラスタリングは、データの中にある似た特徴やまとまりを見つける方法なの。どんなグループができるかは、使うデータや分析方法によって変わるのよ」
美月:「分類は決められたカテゴリーを予測するけど、クラスタリングはデータからグループを見つけるんだね!」
伴菜:「そうよ。その違いが分かれば、分類とクラスタリングを混同しなくなるわね」
K-means(K平均法)
美月:「ハンナ、クラスタリングって、どうやって似たデータをグループに分けているの?」
伴菜:「いろいろな方法があるけれど、代表的なのが**K-means(K平均法)**という手法なのよ」
美月:「K-means? なんだか数学っぽい名前だね」
伴菜:「ふふっ、そうね。でも、基本的な考え方はそれほど難しくないわ。K-meansは、データをあらかじめ指定した数のグループに分ける方法なの」
美月:「じゃあ、3つのグループに分けたいなら、最初に『3』って指定するの?」
伴菜:「そのとおり。このグループの数を表すのが『K』なのよ。K=3なら、3つのクラスターを作ることを目指すの」
美月:「でも、どのお客さんをどのグループに入れるかは、どうやって決めるの?」
伴菜:「まず、3つのクラスターの中心となる点を初期設定するの。そして、それぞれの顧客データを、最も近い中心のグループに割り当てるのよ」
美月:「近い中心って、どういうこと?」
伴菜:「例えば、横軸を購入頻度、縦軸を購入金額としたグラフを考えてみて。購入頻度も購入金額も似ている顧客なら、グラフ上でも近い位置に並びやすいでしょう?」
美月:「ああ、なるほど! グラフの点同士の距離で考えるんだね!」
伴菜:「そうよ。一般的なK-meansでは、特徴を数値で表して、その距離を使ってグループを決めるの」
美月:「それで、最初に近い中心を選んだら終わり?」
伴菜:「いいえ。各グループに割り当てられたデータの平均位置を計算して、中心を更新するの。そして、もう一度、各データを最も近い中心に割り当て直すのよ」
美月:「中心を動かして、またグループ分けするんだ!」
伴菜:「そうなの。この処理を繰り返して、グループの割り当てや中心がほとんど変わらなくなったら終了するのよ」
美月:「なるほど! 最初にグループの数を決めて、近い中心に集めて、中心を調整する。それを繰り返すんだね!」
伴菜:「そのとおり。ただし、K-meansには注意点もあるのよ」
美月:「どんな注意点?」
伴菜:「例えば、購入頻度が月1〜10回、購入金額が1,000〜100,000円だったら、数値の大きさがずいぶん違うでしょう?」
美月:「確かに、購入金額の数字の方がずっと大きいね」
伴菜:「そのまま距離を計算すると、購入金額の違いが強く影響することがあるの。だから、必要に応じてデータを標準化するなど、前処理が重要になるのよ」
美月:「なるほど。数字の大きさが違うだけで、グループ分けの結果も変わるんだね」
伴菜:「そうよ。それに、最初に指定するKの値や中心の初期位置によっても結果が変わることがあるわ」
美月:「じゃあ、K=3にすれば、必ず意味のある3つのグループが見つかるわけじゃないんだね」
伴菜:「そのとおり。K-meansは指定された数のクラスターに分けるけれど、それがビジネス上意味のあるグループとは限らないの。だから、分析結果を人間が確認して、役立つ分類になっているかを評価することが大切なのよ」
美月:「クラスタリングって、AIにグループを作ってもらうだけじゃなくて、その結果をどう解釈するかも重要なんだね!」
伴菜:「そうよ。AIが見つけたパターンを、実際の課題解決につなげることが大切なの」
5. 次元削減(Dimensionality Reduction)とは?
美月:「ハンナ、次元削減って名前が難しそう。次元って何なの?」
伴菜:「ここでいう次元は、データを表す特徴や変数の数だと考えると分かりやすいわ」
美月:「例えば、顧客の年齢、購入金額、購入頻度があったら3次元?」
伴菜:「そうよ。その3つの特徴で顧客を表しているなら、3次元のデータと考えられるの」
美月:「じゃあ、次元削減は、その数を減らすってこと?」
伴菜:「そのとおり。ただ単に情報を捨てるのではなく、重要な特徴や構造をできるだけ残しながら、少ない変数で表現することを目指すのよ」
なぜ次元削減が必要なの?
美月:「ハンナ、次元削減っていう言葉が出てきたけど、そもそも『次元』って何なの?」
伴菜:「機械学習では、データを表す特徴の数を『次元』と呼ぶことが多いのよ。例えば、顧客を年齢、購入金額、購入頻度の3つの特徴で表すなら、3次元のデータになるわ」
美月:「なるほど! 特徴が3つなら3次元、10個なら10次元なんだね!」
伴菜:「そうよ。実際のデータには、数十、数百、場合によっては数千以上の特徴が含まれることもあるの」
美月:「そんなにたくさん? 例えば、どんなデータ?」
伴菜:「画像データが分かりやすいわね。例えば、100×100ピクセルの白黒画像なら、各ピクセルの明るさを1つの数値で表すと、10,000個の数値になるのよ」
美月:「ええっ! 小さな画像1枚でも10,000次元になるんだ!」
伴菜:「そうなの。特徴が多いと、処理によっては計算量が増えたり、データ同士の関係を人間が理解しにくくなったりすることがあるのよ」
美月:「確かに、3次元ならグラフにできるけど、10,000次元なんて想像もできないね」
伴菜:「そこで役立つのが、**次元削減(Dimensionality Reduction)**なの。元のデータが持つ情報をできるだけ残しながら、より少ない特徴で表現することを目指すのよ」
美月:「つまり、複雑なデータを、できるだけ分かりやすい形にするんだね!」
伴菜:「そうね。ただし、次元を減らせば必ず性能が良くなるわけではないの。何のために次元削減をするのかが大切なのよ」
PCA(主成分分析)
美月:「じゃあ、実際にはどうやって次元を減らすの?」
伴菜:「代表的な方法に、**PCA(Principal Component Analysis:主成分分析)**という手法があるのよ」
美月:「PCAって、特徴が10個あったら、そのうち重要そうな5個を選んで残すの?」
伴菜:「そう考えたくなるわよね。でも、PCAは単純に元の特徴を選んで残す方法ではないの。元の特徴を組み合わせて、新しい軸を作るのよ」
美月:「新しい軸? どういうこと?」
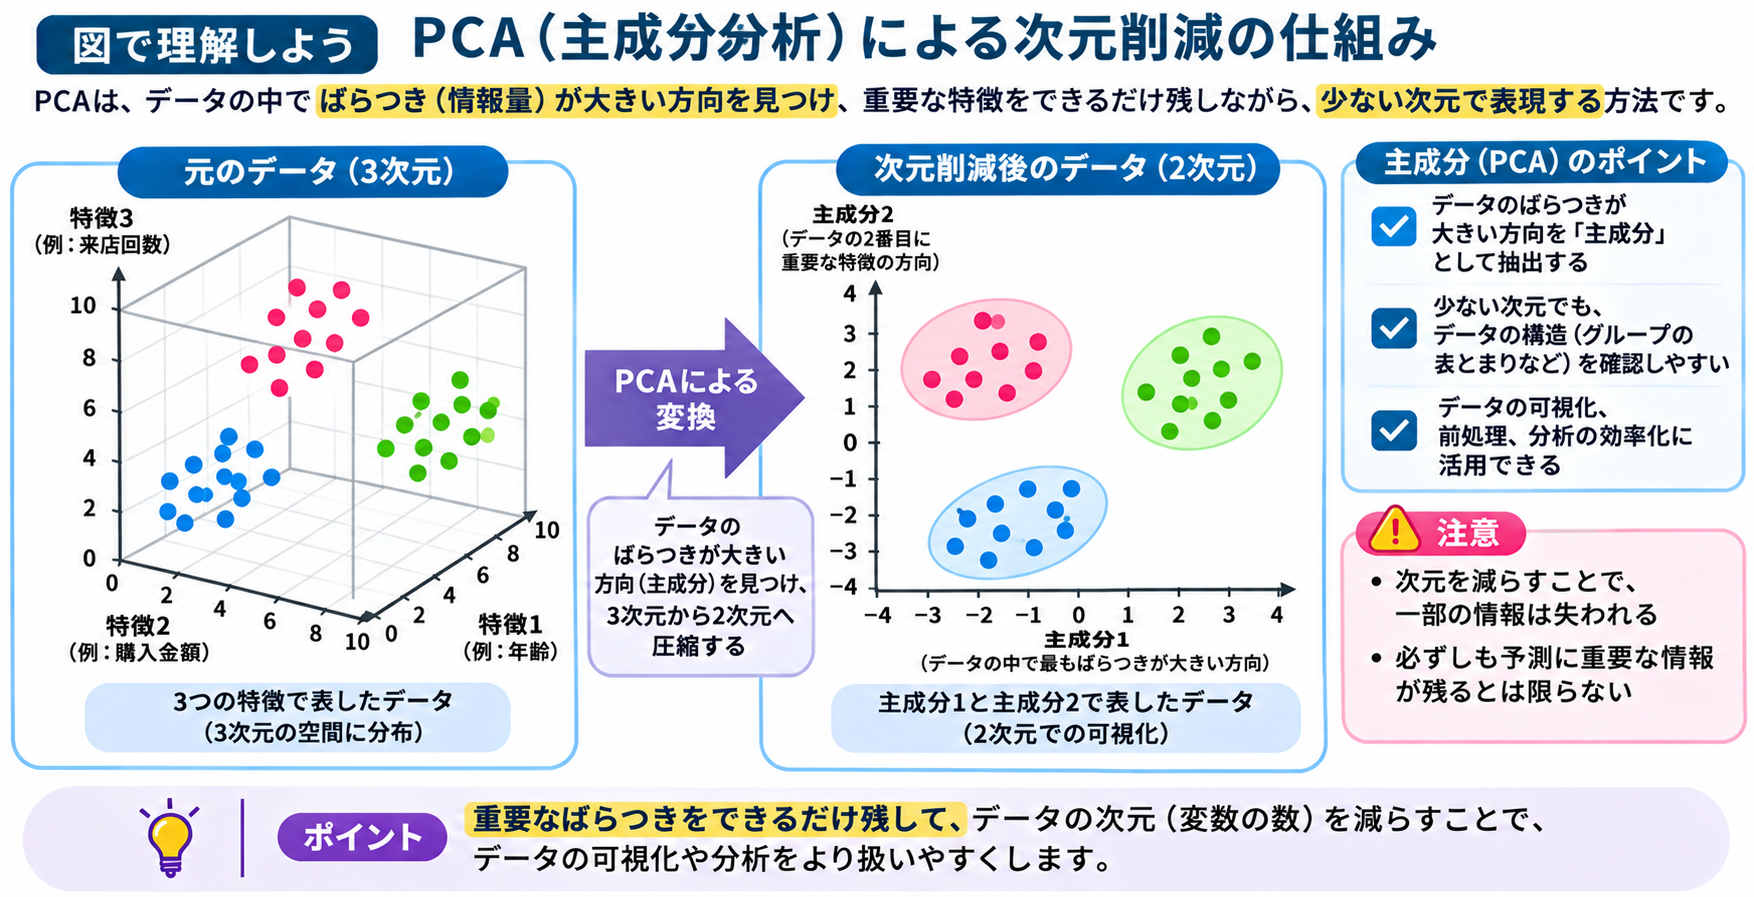
伴菜:「例えば、顧客の『年齢』『購入金額』『購入頻度』を使った3次元のデータを考えてみましょう。データを点で表すと、点がいろいろな方向に広がっているでしょう?」
美月:「うん。お客さんによって年齢も買い物の仕方も違うもんね」
伴菜:「PCAでは、その点の集まりが最も大きくばらついている方向を探すの。そして、その方向を新しい軸にするのよ。これを**第1主成分(Principal Component 1)**というの」
美月:「ばらつきが大きい方向って、点が一番広く散らばっている方向のこと?」
伴菜:「そのとおり。次に、第1主成分と直交する方向の中から、残っているばらつきが最も大きい方向を探すの。それが**第2主成分(Principal Component 2)**よ」
美月:「なるほど! 元の年齢や購入金額の軸とは違う、新しい軸を作るんだね!」
伴菜:「そうよ。PCAの主成分は、元の特徴を重み付きで組み合わせたものなの。だから、第1主成分も第2主成分も、複数の特徴の情報を含んでいることがあるのよ」
美月:「じゃあ、3次元のデータを第1主成分と第2主成分の2つだけで表せば、2次元にできるんだ!」
伴菜:「そのとおり。元の3次元データを、2つの主成分で表すことで、平面の散布図として確認できるようになるのよ」
美月:「それなら、データのまとまりや特徴も見つけやすくなりそう!」
伴菜:「そうね。特に、たくさんの特徴を持つデータを可視化するときに役立つことがあるわ」
美月:「でも、3次元を2次元にしたら、何か情報がなくなっちゃうんじゃない?」
伴菜:「いいところに気付いたわね。実際、次元を減らすことで、一部の情報が失われることがあるの。PCAは、残す主成分でデータのばらつきをできるだけ多く表現しようとする方法なのよ」
美月:「じゃあ、ばらつきが大きい情報を残せば、AIの予測にも役立つんだね!」
伴菜:「必ずしもそうとは限らないの。ここは大切なポイントよ」
美月:「えっ、どうして?」
伴菜:「PCAが重視するのは、データの分散、つまりばらつきの大きさなの。でも、ばらつきが大きい特徴が、必ずしも予測したい答えに重要とは限らないでしょう?」
美月:「ああ、なるほど。データの違いが大きいことと、予測に役立つことは別なんだね」
伴菜:「そのとおり。例えば、ある特徴のばらつきは小さくても、迷惑メールかどうかを判断するうえで重要な情報かもしれないわ。PCAでその情報を十分に残せなければ、予測性能が下がる可能性もあるのよ」
美月:「だから、次元を減らした後も、ちゃんとモデルを評価する必要があるんだね!」
伴菜:「そうよ。それに、PCAは特徴の尺度にも影響されるから、必要に応じて標準化などの前処理を行うことも重要なの」
美月:「なるほど! PCAは、重要そうな特徴を適当に削るんじゃなくて、データのばらつきをできるだけ残せる新しい軸を作る方法なんだね!」
伴菜:「そのとおり。『重要なばらつきをできるだけ残しながら、次元を減らす』。これがPCAを理解するうえでの基本なのよ」
6. どの学習方法を選べばいいの?
美月:「4つの方法が分かってきたけど、実際に使うときはどうやって選ぶの?」
伴菜:「まずは、何を知りたいのかをはっきりさせることね。カテゴリーを予測したいのか、数値を予測したいのか、それともデータの特徴を発見したいのか」
美月:「目的によって選ぶ方法が違うんだね」
伴菜:「そうよ。それに、利用できるデータや正解ラベルの有無、必要な精度、説明のしやすさなども考える必要があるの」
目的別の使い分け
| やりたいこと | 代表的なタスク |
|---|---|
| メールが迷惑メールか判断したい | 分類 |
| 来月の売上金額を予測したい | 回帰 |
| 似た購買傾向の顧客を探したい | クラスタリング |
| 多数の特徴を少ない変数で表したい | 次元削減 |
| 画像が猫か犬かを予測したい | 分類 |
| 大量の顧客データを2次元で可視化したい | 次元削減 |
AIを使わない方がよい場合もある
美月:「ハンナ、ここまでいろいろな機械学習の方法を教えてもらったけど、AIって本当に便利だね! だったら、何でもAIに任せればいいんじゃない?」
伴菜:「ふふっ、そう思うわよね。でも、実はAIを使わない方がいい場合もあるのよ」
美月:「えっ、そうなの? どんな場合?」
伴菜:「例えば、お店で商品の税込価格を計算するとしましょう。税抜価格が1,000円で、税率が10%なら、税込価格はいくらになる?」
美月:「1,100円だよね。そんなの簡単だよ!」
伴菜:「そうでしょう? こういう計算は、税率や端数処理のルールが決まっていれば、普通のプログラムで正確に処理できるの。わざわざ機械学習モデルを作る必要はないわ」
美月:「でも、AIでも計算できるんじゃないの?」
伴菜:「もちろん、計算を支援できるAIもあるわ。でも、機械学習はデータからパターンを学習して予測する技術でしょう? 決まった計算式で答えを求められる処理なら、その式をそのままプログラムにした方が、結果を検証しやすく、動作も予測しやすいのよ」
美月:「なるほど。答えの出し方が決まっているなら、AIに予測させる必要はないんだね!」
伴菜:「そのとおり。一方で、『来月の売上はいくらになるか』『この取引は不正の可能性があるか』といった問題は、単純な計算ルールだけでは判断しにくい場合があるでしょう?」
美月:「うん。いろいろな条件が関係するし、必ず正解できるわけでもないよね」
伴菜:「そういうときには、過去のデータからパターンを学習する機械学習が役立つことがあるのよ」
美月:「つまり、AIが使えるかどうかだけじゃなくて、本当にAIが必要なのかを考えることが大切なんだね!」
伴菜:「そのとおり。AIを使うこと自体が目的になってはいけないの。解決したい問題に合わせて、機械学習、通常のプログラム、あるいはその組み合わせから適切な方法を選ぶことが大切なのよ」
美月:「分かった! AIは何でも解決する魔法じゃなくて、目的に合わせて使う道具なんだね!」
伴菜:「そうよ。どんなに優れた技術でも、使いどころを間違えたら十分な効果は得られないもの。『何を解決したいのか』を最初に考えることが、AIを上手に活用する第一歩なのよ」
7. まとめ
美月:「今日はたくさん覚えたね! 分類はカテゴリーを予測して、回帰は数値を予測する。クラスタリングは似たデータをまとめて、次元削減は特徴の数を減らすんだよね!」
伴菜:「そのとおり。しかも、それぞれ得意なことが違うの。だから、AIを使うときには、まず何を解決したいのかを考えることが大切なのよ」
美月:「なるほど! AIって、何でも同じ方法で学習するわけじゃないんだね」
伴菜:「そうよ。これから学ぶ技術も、今日の4つのタスクと結び付けて考えると理解しやすくなるわ」
理解度チェック
ここまで理解できたかな?
今回は5問の4択問題に挑戦してみよう!
基本から復習したい人へ
ここまでで、教師あり学習と教師なし学習の違いから、分類・回帰・クラスタリング・次元削減の仕組み、さらにモデルの評価方法まで詳しく学んだよ。
「ちょっと難しかったな」「分類とクラスタリングの違いをもう一度確認したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!
次回予告
第4話「分類と回帰の仕組みをもっと詳しく知ろう!」
同じ教師あり学習でも、カテゴリーを予測する分類と、数値を予測する回帰では、モデルの出力や評価方法が違う。
次回は、分類の正解率・適合率・再現率・F1スコア、回帰の予測誤差などを、具体例と図解を使って詳しく学んでいこう!