伴菜と美月のAI教室 — 3 Minutes AI
強化学習って何? — ごほうびを手がかりに賢くなるAI
こんにちは! 伴菜です。
前回は、教師あり学習と教師なし学習の違いについて勉強したね。
今回は、もう一つの代表的な機械学習の方法、**強化学習(Reinforcement Learning)**を紹介するよ。
「強化」って、なんだか難しそう?
でも大丈夫。ゲームを例に考えると、とっても分かりやすいんだ。
1. AIがゲームを練習する?
美月: 「ねえ、ハンナ。AIって、ゲームが上手になることもできるんだよね?」
伴菜: 「うん。例えば、AIにレースゲームを練習させることもできるよ」
美月: 「でも、誰が運転の仕方を教えるの? 最初から正解の操作を全部教えてあげるの?」
伴菜: 「必ずしもそうじゃないんだ。AI自身にいろいろな操作を試させて、その結果を使って学習させる方法があるの。それが強化学習だよ」
美月: 「自分で試して覚えるの? なんだか人間みたい!」
伴菜: 「そうだね。ただし、人間と同じように考えているという意味ではないよ。AIは、どんな行動が良い結果につながるかを、数値で評価しながら学習するんだ」
2. ごほうびを使って学習する
伴菜: 「例えば、レースゲームでこんなルールを決めたとするね」
- コースに沿って進めたら、プラスの点数
- コースから外れたら、マイナスの点数
- ゴールできたら、大きなプラスの点数
美月: 「あっ! いいことをしたらごほうびがもらえるんだ!」
伴菜: 「そのとおり。この点数を**報酬(Reward)**と呼ぶの」
美月: 「じゃあ、AIは点数が高くなるように運転するんだね」
伴菜: 「うん。でも大切なのは、目の前の点数だけじゃないこと。強化学習では、将来も含めて、できるだけ多くの報酬を得られるような行動を学ぶんだよ」
美月: 「なるほど! 目の前のごほうびを取りに行ってコースアウトしたら、結局損しちゃうもんね」
伴菜: 「そういうこと!」
3. 強化学習の仕組み
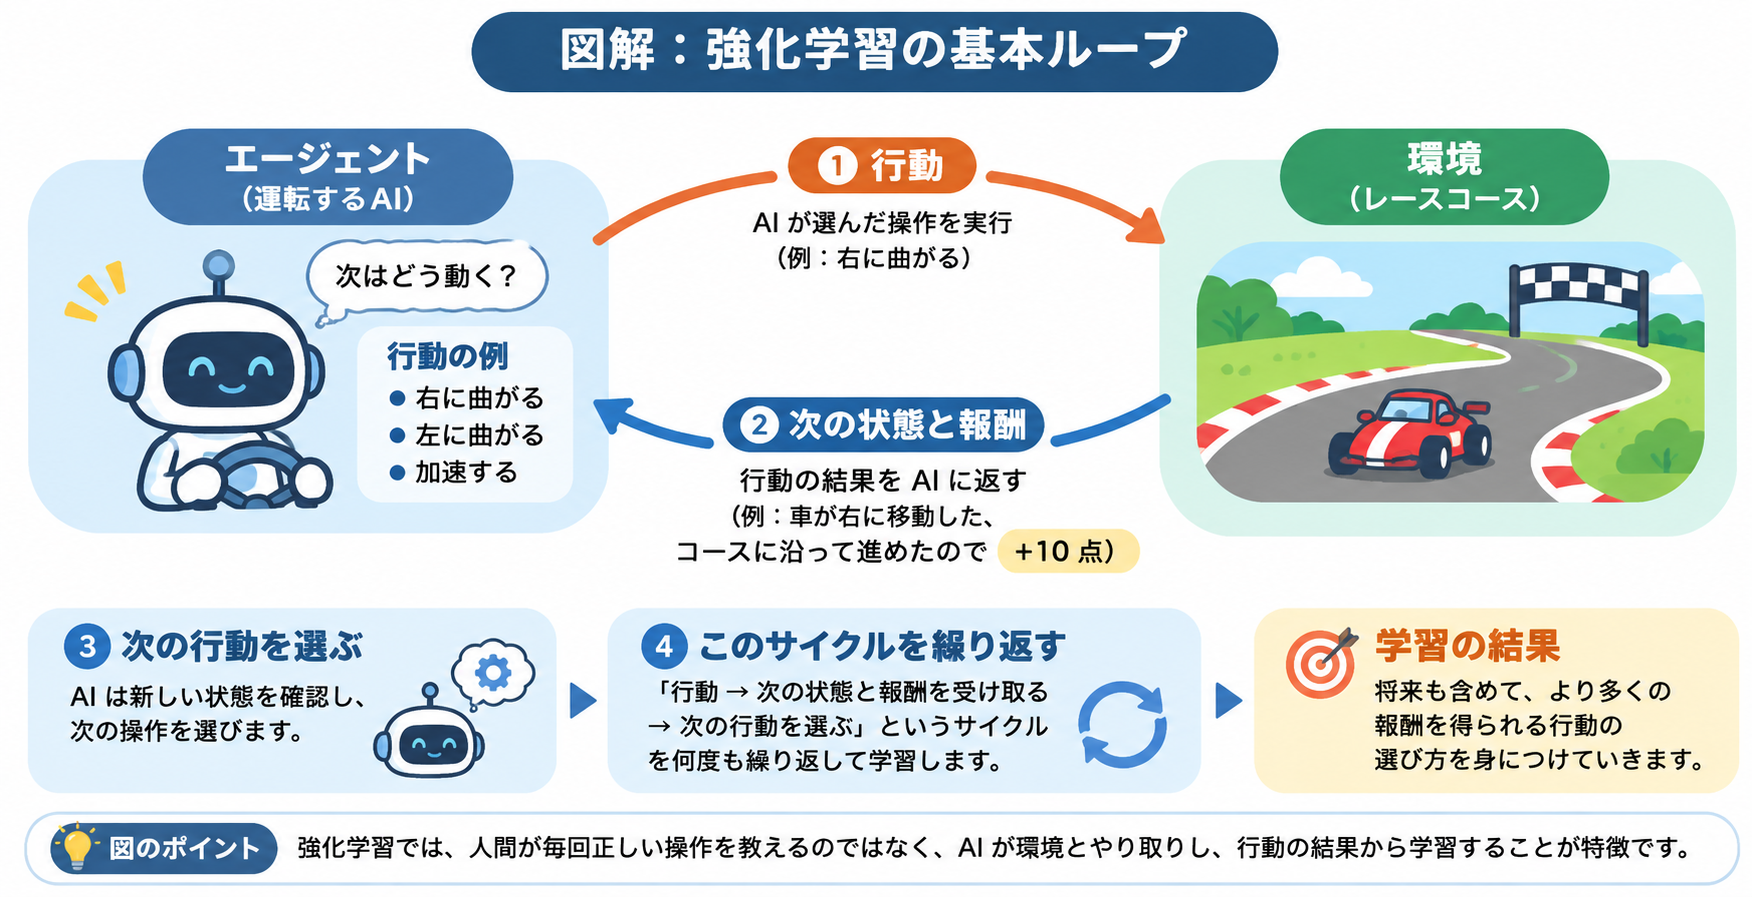
伴菜: 「強化学習には、まず覚えてほしい3つの言葉があるよ」
| 用語 | 意味 | レースゲームの例 |
| エージェント | 行動を選ぶ学習主体 | 運転するAI |
| 環境 | 行動する対象や世界 | レースコース |
| 報酬 | 行動の結果に対する評価 | 走行結果に応じた点数 |
美月: 「エージェントが運転して、環境から報酬をもらうんだね!」
伴菜: 「うん。もう少し正確にいうと、AIは今の状況を見て行動を選び、その結果として新しい状況と報酬を受け取るの。この繰り返しで、より良い行動を選べるように学習していくんだよ」
美月: 「最初は失敗ばかりでも、練習を重ねると上達する可能性があるってことね!」
伴菜: 「そう。ただし、練習すれば必ず上手になるわけではないよ。報酬の決め方や学習方法が適切でないと、期待した行動を学べないこともあるんだ」
4. 教師あり学習とは何が違うの?
美月: 「でもさ、前に勉強した教師あり学習と、どう違うの?」
伴菜: 「いい質問だね! 教師あり学習では、基本的に正解ラベルが付いたデータを使うんだったよね」
美月: 「うん。犬の画像には『犬』、猫の画像には『猫』って正解を付けておくんだよね」
伴菜: 「そう! 一方、強化学習では、行動のたびに正しい操作を教えるのではなく、行動の結果から得られる報酬を手がかりにするんだ」
美月: 「つまり、正解を教えてもらう勉強と、自分で試して結果から学ぶ勉強の違いなんだね!」
伴菜: 「その理解でいいよ!」
5. 強化学習はどこで使われているの?
美月: 「ゲーム以外にも使えるの?」
伴菜: 「もちろん! 例えば、ロボットの動作制御や、設備の運転を効率化する研究などでも使われているよ」
美月: 「AIが自分で行動を選ぶような場面に向いているんだね」
伴菜: 「そうだね。そして生成AIの学習にも、強化学習の考え方が使われることがあるんだよ」
美月: 「えっ! ChatGPTみたいなAIにも関係あるの?」
伴菜: 「うん。でも、それはもう少し先で詳しく勉強しようね!」
今日のまとめ
伴菜: 「今日は強化学習について勉強したね。大切なポイントは3つ!」
- 強化学習は、行動とその結果を繰り返しながら学ぶ機械学習の方法。
- **報酬(Reward)**を手がかりに、長期的に良い結果につながる行動を学ぶ。
- 教師あり学習とは違い、すべての行動に正解を教える必要はない。
美月: 「強化学習って、AIが何度も挑戦して、結果を見ながら上達していく仕組みなんだね!」
伴菜: 「そのとおり! 次は理解度チェックで復習してみよう!」
もっと知りたい! AI用語集
強化学習の仕組みをもう少し詳しく知りたい人は、こちらもチェックしてみてね!
- エージェント(Agent) — 行動を選び、環境とのやり取りを通じて学習する主体。
- 環境(Environment) — エージェントの行動によって状態が変化し、次の状態や報酬を返すもの。
- 報酬(Reward) — 行動の結果に対して与えられる評価信号。
- 方策(Policy) — ある状態で、どの行動を選ぶかを決める仕組み。
- 累積報酬(Cumulative Reward) — 複数の時点で得られる報酬を合計したもの。将来の報酬を割り引いて評価する場合もある。
理解度チェック(3 Minutes AI 第4話)
もっと詳しく知りたい人へ
強化学習の基本が分かったら、30 Minutes AI 第4話へ進んでみよう。
エージェント、環境、状態、行動、報酬の関係や、AIがどのように行動を選ぶのかを、図解と具体例でもっと詳しく説明するよ。
→ 30 Minutes AI 第4話へ(公開後にリンクを設定)