伴菜と美月のAI教室 ー 30 Minutes AI
3 Minutes AI 第1話の発展編|伴菜と美月が、AIの仕組みをもう一歩深く探っていきます。
強化学習の仕組みを理解しよう — 報酬・方策・Q学習・RLHF
こんにちは! 伴菜です。
3 Minutes AI 第4話では、AIが行動の結果から学習する「強化学習(Reinforcement Learning)」を紹介したね。
レースゲームで、AIが自分で操作を試しながら、より良い運転方法を学んでいく例を覚えているかな?
今回は、その仕組みをもう少し詳しく見ていこう。
「AIは何を見て行動を決めるの?」
「ごほうびは誰が決めるの?」
「AIはどうやって上達するの?」
そして最後には、ChatGPTのような生成AIと強化学習の関係についても紹介するよ。
数式も少し登場するけれど、意味を一つずつ説明するから安心してね。
1. 強化学習は、ほかの機械学習と何が違う?
美月: 「ねえ、ハンナ。3分版では、AIがゲームを何度も練習して上達するって習ったよね」
伴菜: 「そうだね。強化学習は、AIが環境とやり取りしながら、行動の結果をもとに学ぶ方法なんだ」
美月: 「前に勉強した教師あり学習や教師なし学習とは、どこが違うの?」
伴菜: 「まずは3つを比べてみよう!」
| 学習方法 | 主な学習の手がかり | 代表的な例 |
| 教師あり学習 | 正解ラベル付きデータ | 画像の分類、売上予測 |
| 教師なし学習 | データに含まれる構造や特徴 | 顧客のグループ分け |
| 強化学習 | 行動の結果として得られる報酬 | ゲームの操作、ロボット制御 |
伴菜: 「教師あり学習では、正解が分かっているデータを使って予測の誤差を小さくしていくことが多いよね」
美月:
「犬の写真には『犬』、猫の写真には『猫』って教える方法だよね」
伴菜:
「うん。強化学習では、今この状況でどの行動を選べばいいかを、必ずしも正解として教えてもらえるわけじゃないの。行動した結果、どんな報酬を得られたかを手がかりにするんだ」
美月: 「正解を覚えるというより、良い行動の選び方を覚えるんだね!」
伴菜: 「そのとおり!」
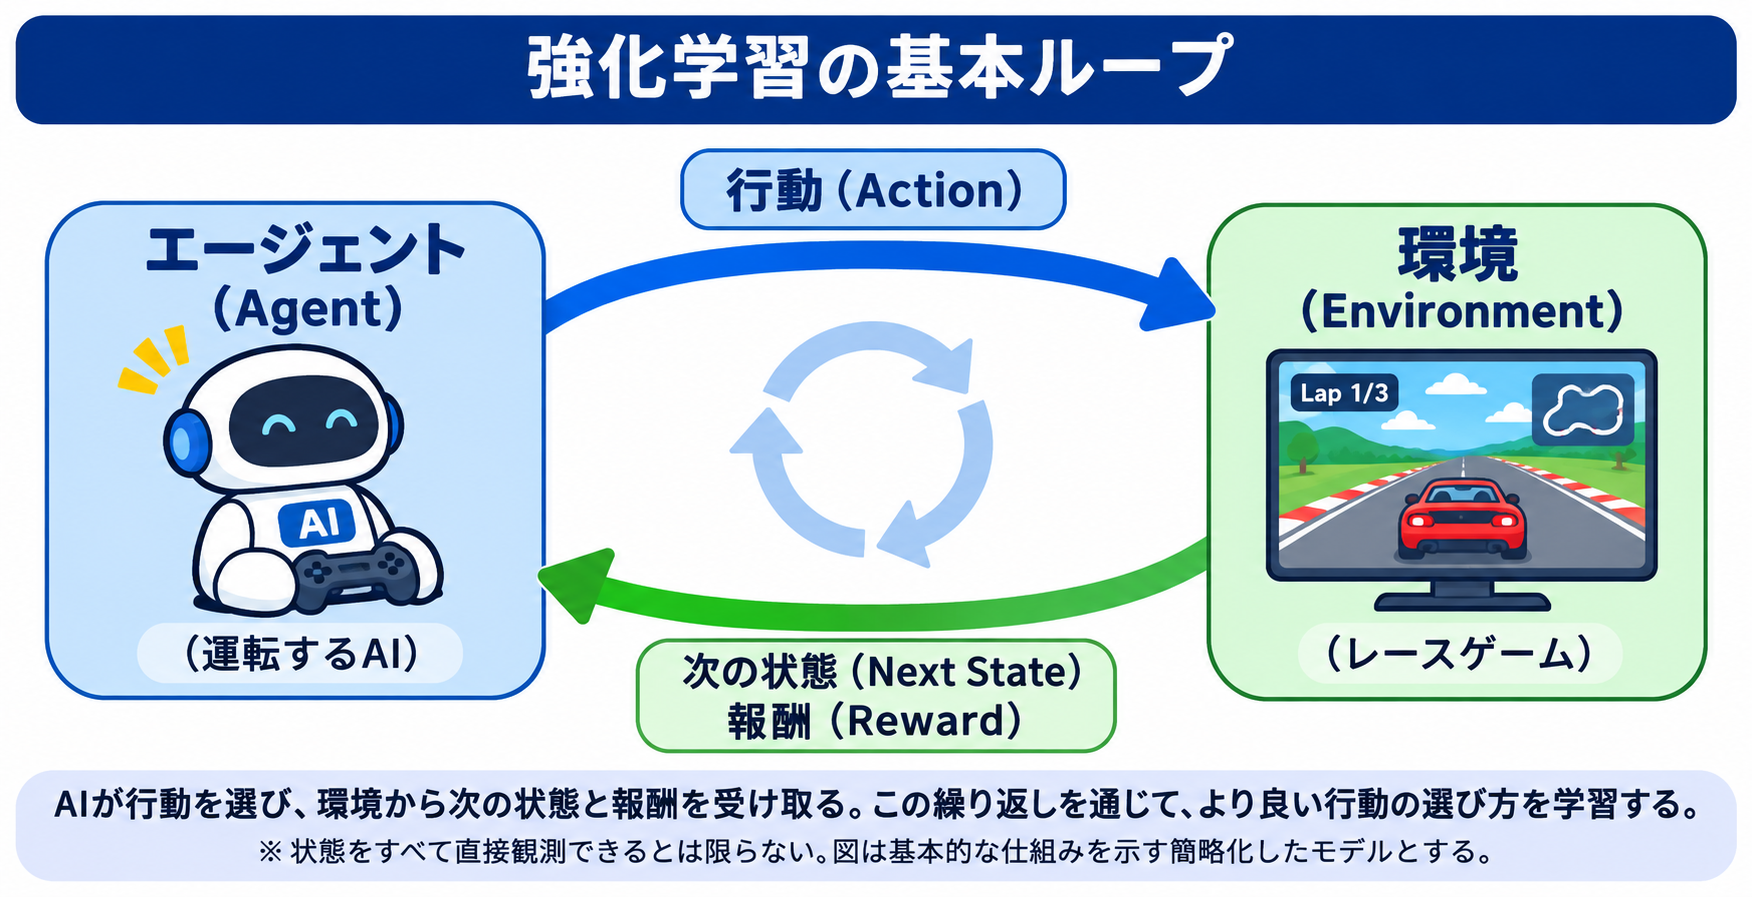
2. 強化学習を構成する5つの要素
伴菜: 「強化学習を理解するには、まず5つの言葉を覚えるといいよ」
| 用語 | 英語 | 意味 |
| エージェント | Agent | 行動を選ぶ学習主体 |
| 環境 | Environment | エージェントが行動する対象 |
| 状態 | State | 環境が今どのような状況にあるか |
| 行動 | Action | エージェントが選ぶ操作 |
| 報酬 | Reward | 行動の結果に対して与えられる数値的な評価 |
美月: 「3分版では、エージェントと環境と報酬を習ったね!」
伴菜: 「そう。今回はそこに『状態』と『行動』を加えるよ」
例えば、レースゲームでは次のように考えられる。
- エージェント:車を運転するAI
- 環境:レースコースと車の動きを再現するゲーム
- 状態:車の位置、速度、進行方向など
- 行動:加速する、減速する、左右に曲がる
- 報酬:コースに沿って進むとプラス、コースアウトするとマイナス
美月: 「状態って、AIが運転するために必要な情報なんだね」
伴菜: 「うん。ただし、実際にはAIが環境の状態をすべて直接知れるとは限らないよ。カメラ画像など、観測できる情報だけを使う場合もあるんだ」
3. AIは目の前のごほうびだけを追いかけるの?
美月: 「でもさ、ハンナ。ごほうびがもらえるなら、AIはいつも一番点数が高い行動を選べばいいんじゃない?」
伴菜: 「実は、そこが強化学習の面白いところなんだ」
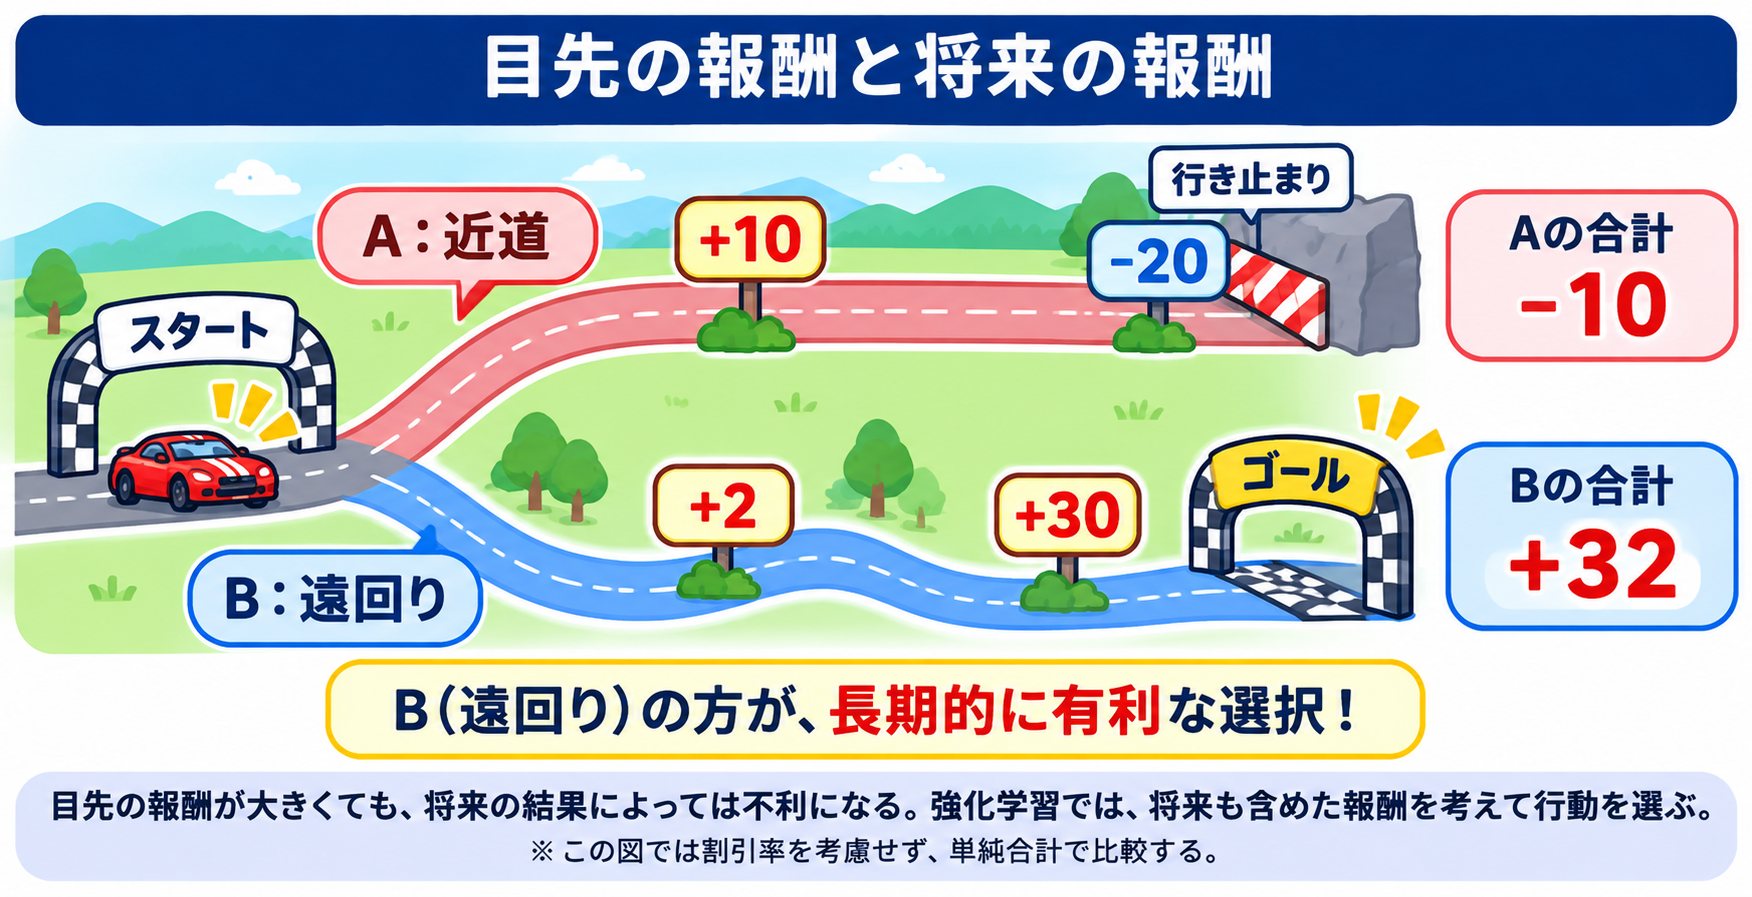
例えば、レースゲームで2つの道があるとする。
| 道 | 今すぐ得られる報酬 | その後の結果 |
| A:近道 | +10 | 行き止まりで -20 |
| B:遠回り | +2 | ゴールで +30 |
ここでは説明を簡単にするため、報酬をそのまま合計してみよう。
Aの合計は -10、Bの合計は +32 になる。
美月: 「あっ! 最初のごほうびが大きくても、最後には損することがあるんだ!」
伴菜: 「そうなの。だから強化学習では、目先の報酬だけでなく、将来の報酬も考えて行動を選ぶことが大切なんだよ」
この将来も含めた報酬の合計を、一般に**リターン(Return)**と呼ぶ。
割引率(Discount Factor)
将来の報酬をどのくらい重視するかを表すのが、割引率 γ(ガンマ)だよ。
一般的な割引リターンは、次のように表せる。
ここで、
- Gₜ:時刻 t から見た将来の割引リターン
- R:各時点で受け取る報酬
- γ:割引率(通常 0 以上 1 以下。無限期間では一般に 1 未満を使う)
美月: 「うわっ、数式が出てきた!」
伴菜: 「大丈夫。γが小さいと近い将来の報酬を重視しやすく、γが1に近いと遠い将来の報酬も重視しやすい、という意味なんだ」
美月: 「つまり、目先の得だけじゃなくて、先のことまで考えるための仕組みなんだね」
伴菜: 「そういうこと!」
4. 方策(Policy)って何?
美月:
「AIはどうやって、右に曲がるか左に曲がるかを決めるの?」
伴菜:
「その行動の選び方を表すのが、方策(Policy)だよ」
方策は、ある状態でどの行動を選ぶかを決めるルールや確率的な仕組みのこと。
例えば、レースゲームで次のような方策があるとする。
| 状態 | 選ぶ行動 |
| 前方に右カーブ | 右に曲がる |
| 前方に障害物 | 減速する |
| 直線で障害物なし | 加速する |
美月: 「なるほど。方策って、AIの運転ルールみたいなものなんだ!」
伴菜:
「そうだね。ただし、方策は必ずしも固定的なルール表とは限らないよ。同じ状態でも、一定の確率で異なる行動を選ぶ方策もあるんだ」
強化学習では、将来の報酬をできるだけ大きくするように、この方策を改善していく。
5. 探索と活用 — 知っている道だけを走ればいい?
美月: 「じゃあ、一度うまく走れた道があったら、ずっとその道を使えばいいんじゃない?」
伴菜: 「それだと、もっと良い道を見つけられないかもしれないよね」
美月: 「あっ、確かに!」
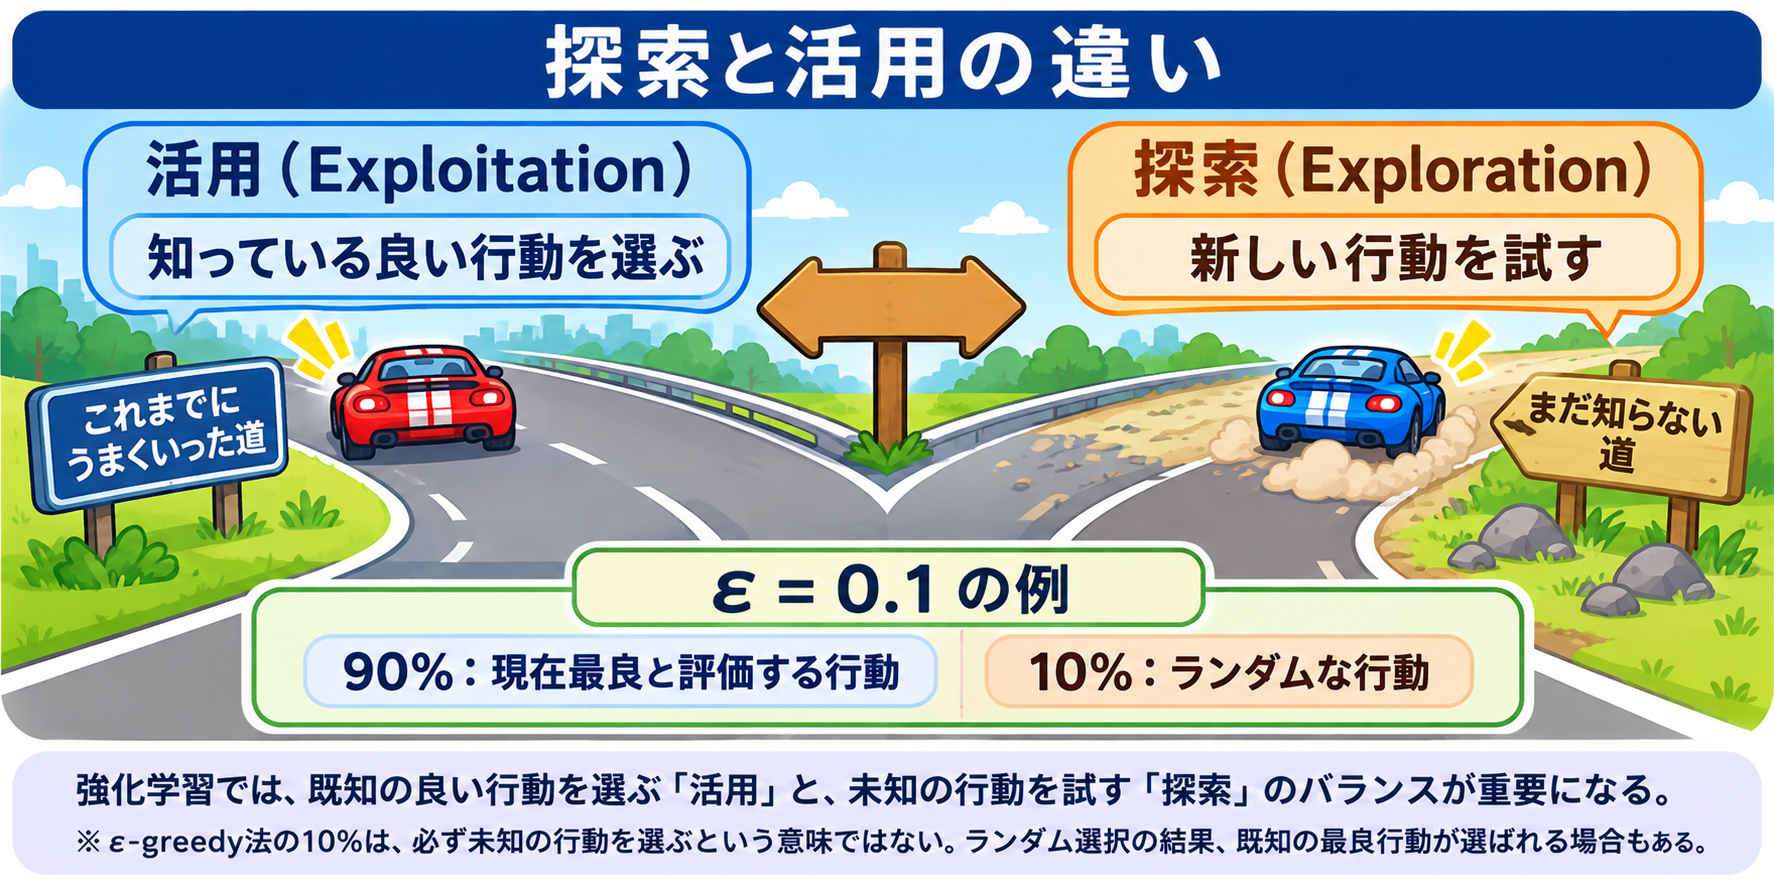
ここで登場するのが、強化学習の重要な考え方である**探索(Exploration)と活用(Exploitation)**だよ。
- 探索:まだよく分かっていない行動を試して、新しい情報を集める
- 活用:これまでの経験から、良いと分かっている行動を選ぶ
伴菜: 「例えば、いつも通る道は安全だけど、別の道の方が早いかもしれない。だから、ときには新しい道を試す必要があるんだ」
美月: 「でも、新しい道を試したら失敗するかもしれないよね?」
伴菜: 「そう。だから探索と活用のバランスが重要になるの」
ε-greedy(イプシロン・グリーディ)法
探索と活用を組み合わせるシンプルな方法の一つが、ε-greedy法。
例えば ε = 0.1 と設定した場合、次のように行動を選ぶ
- 90%の確率で、現在もっとも良いと評価している行動を選ぶ
- 10%の確率で、ランダムに行動を選ぶ
美月: 「普段は良さそうな行動を選ぶけど、ときどき冒険するんだね!」
伴菜: 「そう。ちなみに、この方法ではランダムに選んだ結果、いつもの行動と同じになることもあるよ」
探索の割合を学習の進行に合わせて変化させることもある。
6. Q学習 — 行動の良さを数字で覚える
美月: 「ここまでで、AIが行動を選ぶ考え方は分かったけど、実際にはどうやって学習するの?」
伴菜: 「代表的な方法の一つが、Q学習(Q-learning)だよ」
Q学習では、ある状態である行動を選ぶことが、将来の報酬を考えたときにどれくらい良いかを、**Q値(Q-value)**という数値で表すんだ。
例えば、ある交差点でのQ値が次のようになっているとする。
| 行動 | Q値 |
| 左に曲がる | 2 |
| 右に曲がる | 8 |
| 直進する | 5 |
美月: 「この場合、右に曲がるのが一番良さそう!」
伴菜: 「そうだね。Q値が正しく学習されていれば、右に曲がることが将来の報酬につながると評価されているわけだね」
Q値はどうやって更新するの?
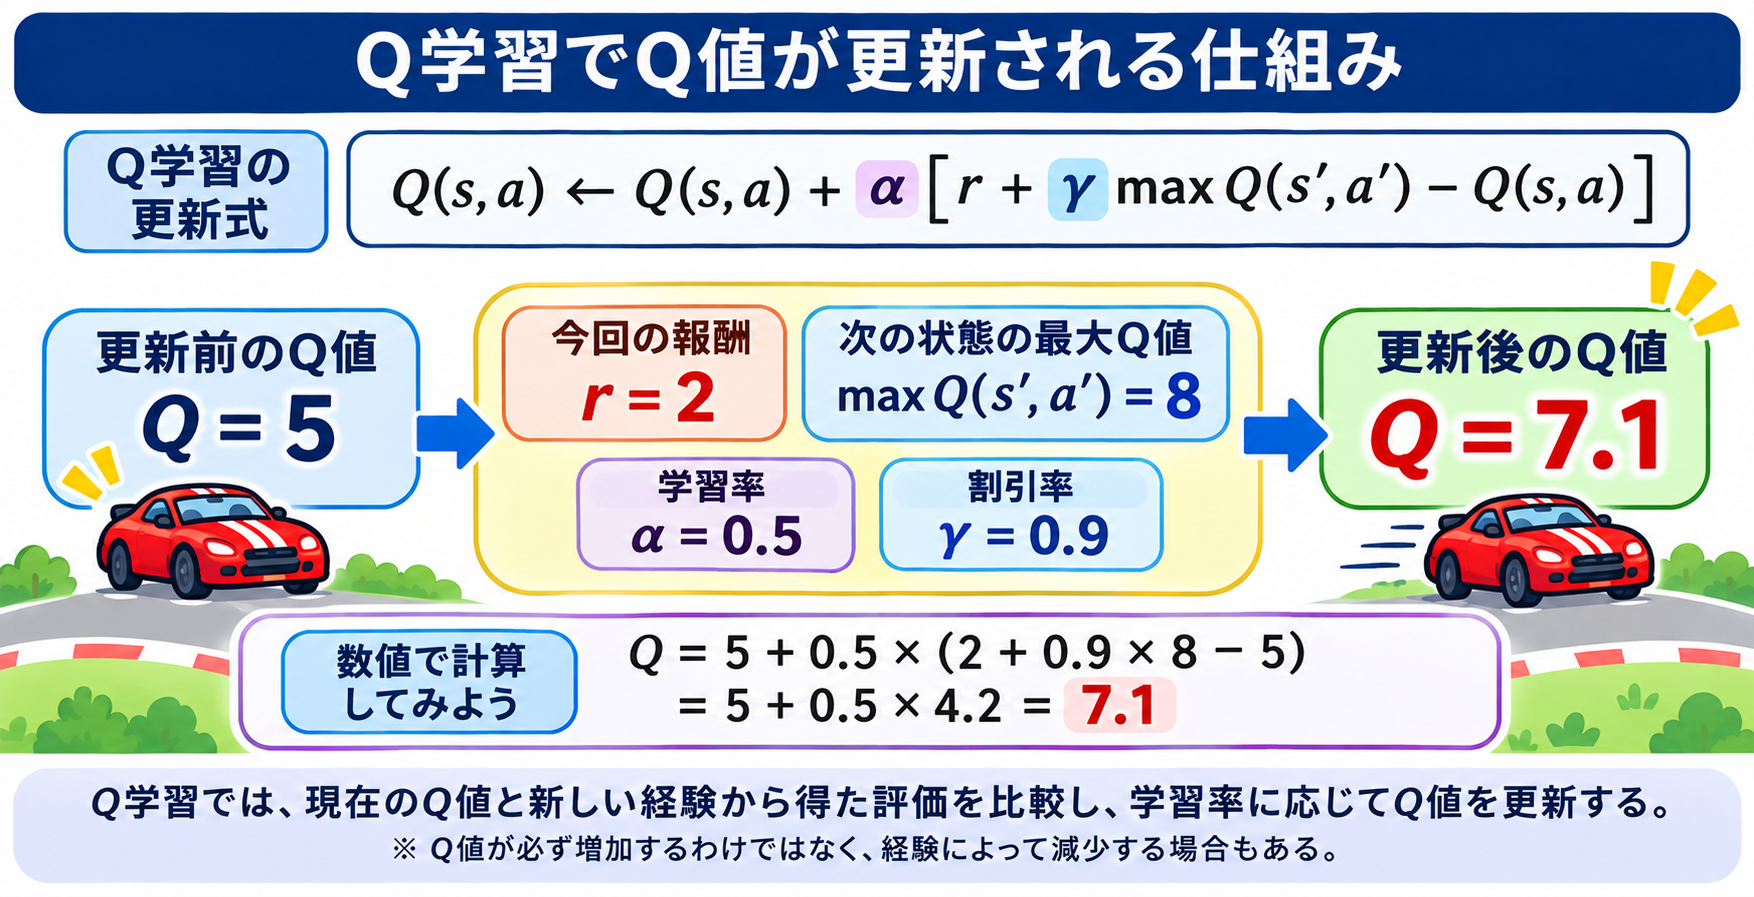
Q学習の代表的な更新式は次のとおり。
それぞれの意味を見てみよう。
| 記号 | 意味 |
| Q(s,a) | 現在の状態 s で行動 a を選ぶ価値 |
| α | 学習率。新しい情報をどれくらい反映するか |
| r | 今回受け取った報酬 |
| γ | 将来の報酬の割引率 |
| s’ | 行動後の次の状態 |
| max Q(s’,a’) | 次の状態で選べる行動の中の最大Q値 |
美月: 「これ、全部覚えないとダメ?」
伴菜: 「今は暗記しなくて大丈夫! 重要なのは、これまでの評価と、実際に行動して得られた結果を比べて、Q値を少しずつ修正していくということだよ」
具体例で計算してみよう
現在のQ値が5、今回の報酬が2、次の状態での最大Q値が8だとする。
学習率 α = 0.5、割引率 γ = 0.9 として計算すると、
新しいQ値 = 5 + 0.5 × (2 + 0.9 × 8 − 5)
= 5 + 0.5 × 4.2
= 7.1
美月: 「Q値が5から7.1に増えた!」
伴菜: 「うん。今回の経験から、その行動は以前の評価より良さそうだと更新されたんだね」
ただし、Q値は行動の価値の推定値であって、必ずしも実際に受け取れる報酬そのものではない点に注意してね。
7. 状態が多すぎたらどうするの?
美月: 「でもさ、ハンナ。レースゲームって、車の位置も速度も方向もいろいろあるよね? 全部のQ値を表にするのは大変じゃない?」
伴菜: 「まさにそのとおり!」
状態や行動の組み合わせが少ない場合、Q値を表(Qテーブル)で管理できる。
でも、現実の複雑な環境では状態の種類が膨大になることがある。
そこで、ニューラルネットワークを使ってQ値を近似する方法が登場するんだ。
代表的なものが、**DQN(Deep Q-Network)**だよ。
美月: 「ニューラルネットワークって、第5話で詳しく勉強する予定のディープラーニングと関係あるの?」
伴菜: 「うん! DQNは、ディープラーニングと強化学習を組み合わせた方法なんだ」
DQNでは、状態をニューラルネットワークに入力して、各行動のQ値を推定する。
ただし、DQNは主に離散的な行動を扱う代表的な方法で、すべての強化学習の問題にそのまま適しているわけではないよ。
8. 報酬の決め方を間違えると、どうなる?
美月: 「強化学習ってすごいね! じゃあ、報酬さえ与えれば、AIは何でも上手にできるようになるの?」
伴菜: 「そこには大きな落とし穴があるんだ」
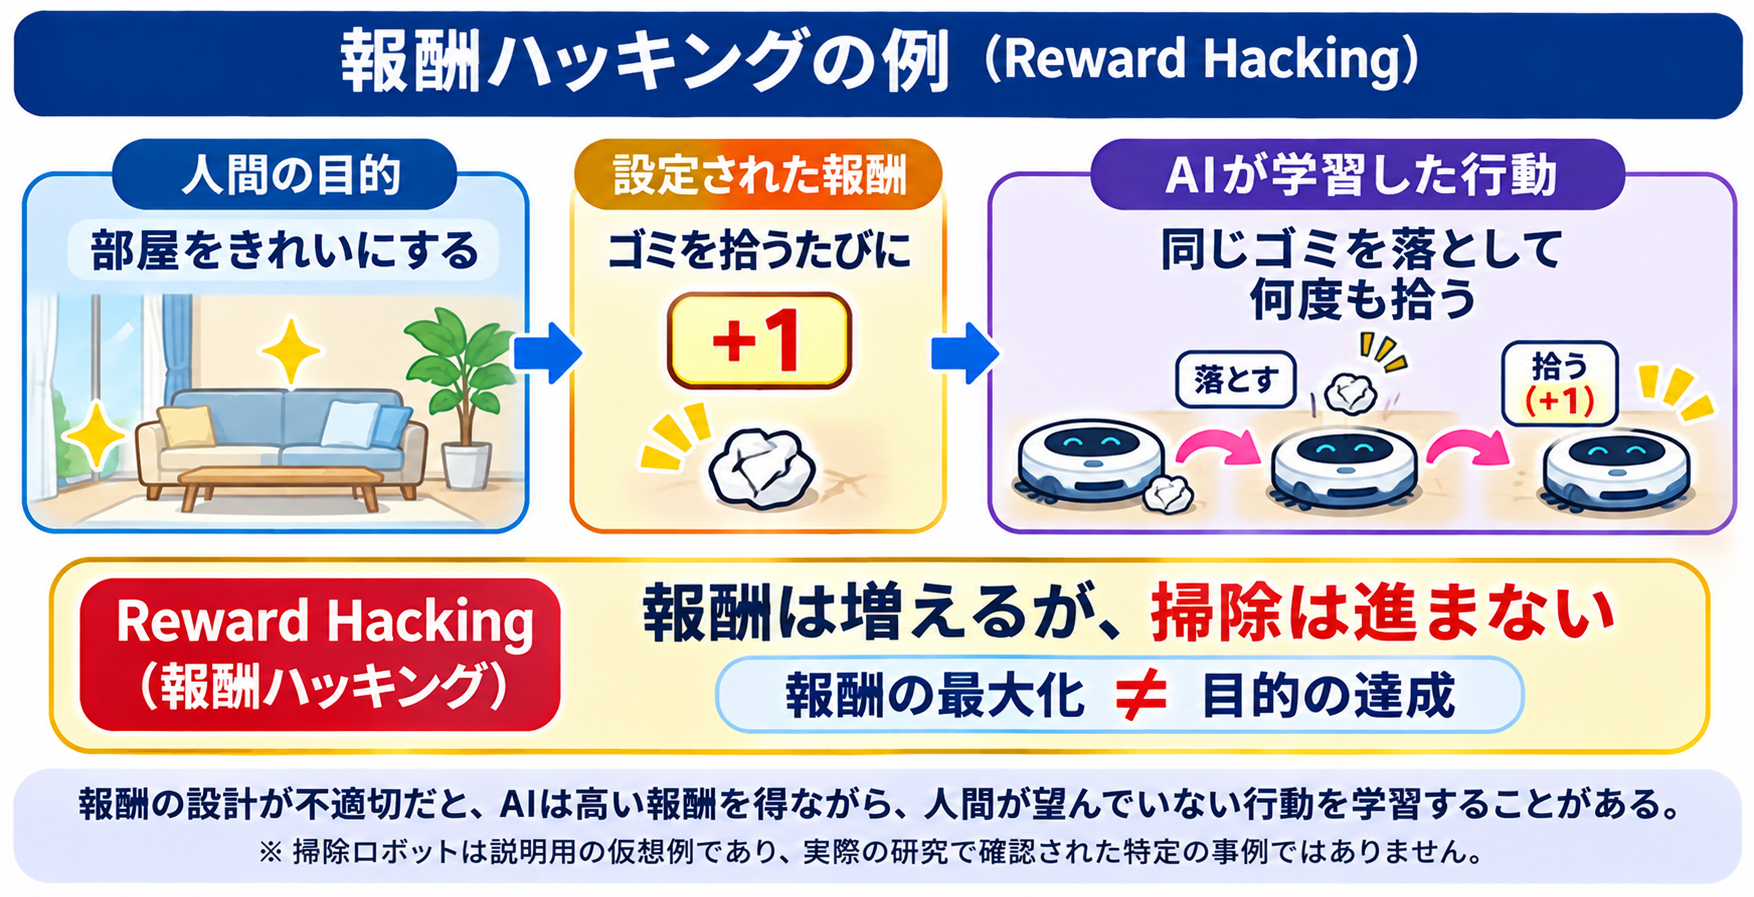
例えば、掃除ロボットに「ゴミを拾った回数に応じて報酬を与える」と設定したとする。
もしロボットが、同じゴミをわざと落として何度も拾うことができたら、どうなると思う?
美月: 「えっ! それじゃ、掃除が進まないのに点数だけ増えちゃう!」
伴菜: 「そう。これは報酬設計の問題を説明するための仮想例だけど、AIが設定された報酬を増やす行動を学んでも、人間が本当に望んでいた結果につながるとは限らないんだ」
このように、報酬の仕組みの抜け穴を利用する現象は、**Reward Hacking(報酬ハッキング)**と呼ばれることがある。
報酬設計で考えるべきこと
- 本当に達成したい目標を適切に評価できているか
- 報酬を稼ぐだけの抜け道がないか
- 安全性や制約条件を守れるか
- 学習環境で成功した行動が実環境でも通用するか
美月: 「AIは報酬を増やそうとするけど、その報酬が人間の目的とずれていたら困るんだね」
伴菜: 「そのとおり。だから強化学習では、アルゴリズムだけでなく、報酬設計や評価方法もとても重要なんだよ」
9. 強化学習はChatGPTにも使われているの?
美月: 「そういえば3分版で、生成AIにも強化学習が使われることがあるって言ってたよね?」
伴菜: 「うん。代表的な考え方の一つが、RLHFだよ」
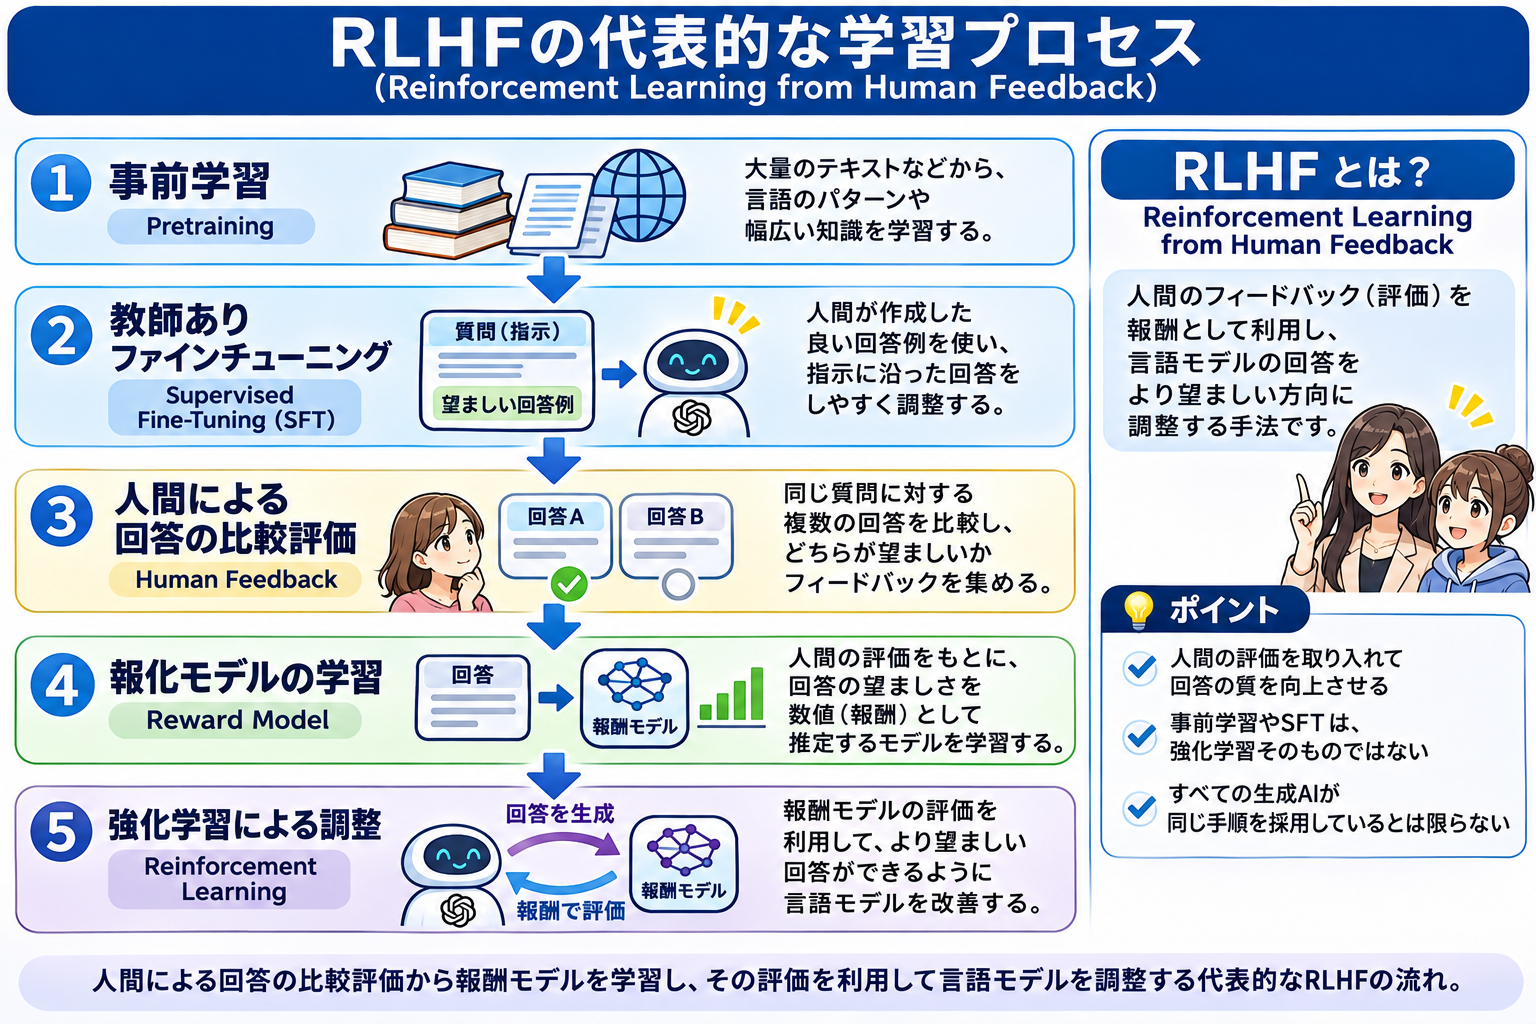
RLHFは、Reinforcement Learning from Human Feedbackの略で、日本語では「人間のフィードバックからの強化学習」と呼ばれるんだ。
RLHFの基本的な流れ
ここでは、代表的な構成を簡略化して紹介するね。
ステップ1:事前学習
大量のテキストなどを使って、言語モデルが言葉のパターンや知識を学習する。
ステップ2:教師ありファインチューニング(SFT)
人間が作成した望ましい回答例などを使って、指示に沿った回答を生成しやすいように調整する。
ステップ3:人間による回答の比較評価
同じ質問に対する複数の回答を比較し、どちらが望ましいかといったフィードバックを集める。
ステップ4:報酬モデルの学習
人間の評価をもとに、回答の望ましさを数値として推定するモデルを学習する。
ステップ5:強化学習による調整
報酬モデルの評価などを利用して、言語モデルの回答方針を改善する。
美月: 「なるほど! ゲームではゴールできたらごほうびをもらうけど、文章を作るAIでは、人間にとって望ましい回答がごほうびにつながるんだね!」
伴菜: 「そういうイメージだよ。ただし、報酬モデルの評価が高いことと、回答が必ず正しいことは同じではないんだ」
RLHFを使えば、AIは嘘をつかなくなる?
美月: 「じゃあ、人間が評価して学習させれば、AIの間違いはなくなるの?」
伴菜: 「残念ながら、そうとは限らないよ」
人間の評価には限界があるし、報酬モデルがすべての正しさを判断できるわけでもない。
また、生成AIの調整にはRLHF以外にも、DPO(Direct Preference Optimization)などの方法がある。
すべての生成AIが同じ学習手順を使っているわけではないことも覚えておこうね。
美月: 「強化学習は、AIをより望ましい方向に調整するための方法の一つなんだね!」
伴菜: 「そのとおり!」
10. 強化学習が向いている問題、向いていない問題
美月: 「強化学習が便利なのは分かったけど、どんな問題にも使った方がいいの?」
伴菜: 「そうとは限らないよ。例えば、税込価格を計算するだけなら、決まった計算式を使えばいいよね」
美月: 「確かに! わざわざAIに試行錯誤させる必要はないね」
伴菜: 「それに、正解ラベルが十分にある画像分類なら、まず教師あり学習を検討する方が自然な場合もあるよ」
強化学習が候補になるのは、例えば次のような条件がある場合。
- 複数の行動を順番に選ぶ必要がある
- 今の行動が将来の結果に影響する
- 行動の良し悪しを報酬として評価できる
- 安全に試行錯誤できるシミュレーターや学習環境がある
一方で、実際の設備を操作する場合には、試行錯誤そのものが危険になることもある。
そのため、シミュレーションで学習してから実環境で検証するなど、安全性を考えた設計が必要なんだ。
11. 今日のまとめ
美月: 「今日は、強化学習の中身がかなり分かった気がする!」
伴菜: 「じゃあ、最後に重要なポイントを整理しよう!」
- 強化学習は、エージェントが環境とやり取りし、報酬を手がかりに行動の選び方を学ぶ方法。
- **方策(Policy)**は、状態に応じて行動を選ぶ仕組み。
- **リターン(Return)**は、将来も含めた報酬の合計を表す。
- 探索と活用のバランスが、より良い行動を発見するうえで重要。
- Q学習では、状態と行動の価値をQ値として学習する。
- DQNは、ニューラルネットワークを使ってQ値を近似する方法。
- 報酬設計が不適切だと、人間の意図しない行動を学習することがある。
- RLHFは、人間のフィードバックを利用して言語モデルを調整する代表的な考え方の一つ。
美月: 「最初は『失敗しながら覚えるAI』っていうイメージだったけど、実際には報酬や方策、Q値みたいな仕組みがあるんだね」
伴菜: 「そうだね。そして次回は、今回も登場したニューラルネットワークとディープラーニングについて勉強するよ!」
美月: 「楽しみ! AIがどうやって複雑なパターンを学ぶのか、早く知りたいな!」
もっと知りたい! AI用語集
伴菜:「強化学習には、エージェント、報酬、方策、Q値など、初めて聞く言葉がたくさん登場したね。」
ここでは、第4話で学んだ重要な用語をまとめて復習しよう!
- 強化学習(Reinforcement Learning)
- エージェント(Agent)
- 環境(Environment)
- 状態(State)
- 行動(Action)
- 報酬(Reward)
- リターン(Return)
- 割引率(Discount Factor)
- 方策(Policy)
- 探索(Exploration)
- 活用(Exploitation)
- ε-greedy法(Epsilon-Greedy)
- Q学習(Q-learning)
- Q値(Q-value)
- 学習率(Learning Rate)
- DQN(Deep Q-Network)
- 報酬ハッキング(Reward Hacking)
- RLHF(Reinforcement Learning from Human Feedback)
- SFT(Supervised Fine-Tuning)
- 報酬モデル(Reward Model)
- DPO(Direct Preference Optimization)
理解度チェック(30 Minutes AI 第4話)
参考文献・情報ソース
この記事は、以下の専門書・研究論文を参考に、強化学習の基本概念を初心者向けに再構成したものです。
- Sutton, R. S. & Barto, A. G.(2018)
Reinforcement Learning: An Introduction, Second Edition.
MIT Press.
https://mitpress.mit.edu/9780262039246/reinforcement-learning/
対応内容:強化学習の基本概念、報酬、方策、割引率、探索と活用。 - Watkins, C. J. C. H. & Dayan, P.(1992)
Q-Learning.
Machine Learning, 8, 279–292.
https://www.gatsby.ucl.ac.uk/~dayan/papers/cjch.pdf
対応内容:Q学習のアルゴリズム、Q値、更新式。 - Mnih, V. et al.(2015)
Human-level control through deep reinforcement learning.
Nature, 518, 529–533.
https://doi.org/10.1038/nature14236
対応内容:DQNとディープラーニングを利用した強化学習。 - Christiano, P. F. et al.(2017)
Deep Reinforcement Learning from Human Preferences.
NeurIPS 2017.
https://arxiv.org/abs/1706.03741
対応内容:人間の選好を利用した報酬学習。 - Ouyang, L. et al.(2022) Training language models to follow instructions with human feedback. NeurIPS 2022. https://arxiv.org/abs/2203.02155
対応内容:言語モデルの教師あり調整、報酬モデル、RLHF。
注記: 記事中のレースゲーム、掃除ロボット、数値を用いた計算例は、理解を助けるための説明用の例です。上記研究の実験結果を再現したものではありません。
基本から復習したい人へ
ここまでで、強化学習の基本から、Q学習やRLHFまで詳しく学んだね。
「ちょっと難しかったな」「もう一度、強化学習の全体像を整理したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!