カテゴリー
2026年 30 Minutes AI AI コンピューター 伴菜と美月のAI教室

30 Mins AI|第3話「教師あり学習と教師なし学習をもっと詳しく知ろう!」

伴菜と美月のAI教室|学習時間:約30分(解説・図解・理解度チェックを含む)

はじめに

前回の3 Minutes AIでは、教師あり学習と教師なし学習の基本的な違いを学んだね。

教師あり学習は、正解となる情報を使ってモデルを学習させる方法。

教師なし学習は、正解ラベルを使わずに、データの中にある特徴やパターンを見つける方法。

でも、実際にAIを使おうとすると、こんな疑問が出てくるよね。

「売上を予測したいときは、どちらを使えばいいの?」

「顧客をグループに分けたいときは?」

「分類とクラスタリングは、どちらもグループ分けなのに何が違うの?」

今回は、伴菜と美月と一緒に、4つの代表的な機械学習のタスクを詳しく見ていこう!

1. 教師あり学習と教師なし学習をおさらい

美月:「ハンナ、教師あり学習と教師なし学習の違いは分かったつもりなんだけど、実際にはどうやって使い分けるの?」

伴菜:「まず考えるのは、何を知りたいのか、そして学習に使えるデータに正解が付いているかどうかよ」

美月:「正解が付いていれば教師あり学習で、付いていなければ教師なし学習?」

伴菜:「基本的にはそう考えていいわ。ただし、正解ラベルがないから必ず教師なし学習というわけではないの。目的によっては、人間がラベルを付けたり、別の学習方法を選んだりすることもあるのよ」

美月:「なるほど。データだけじゃなくて、何をしたいのかも大事なんだね」

伴菜:「そのとおり。例えば、将来の売上を予測するのと、似た顧客を探すのでは、解決したい問題が違うでしょう?」

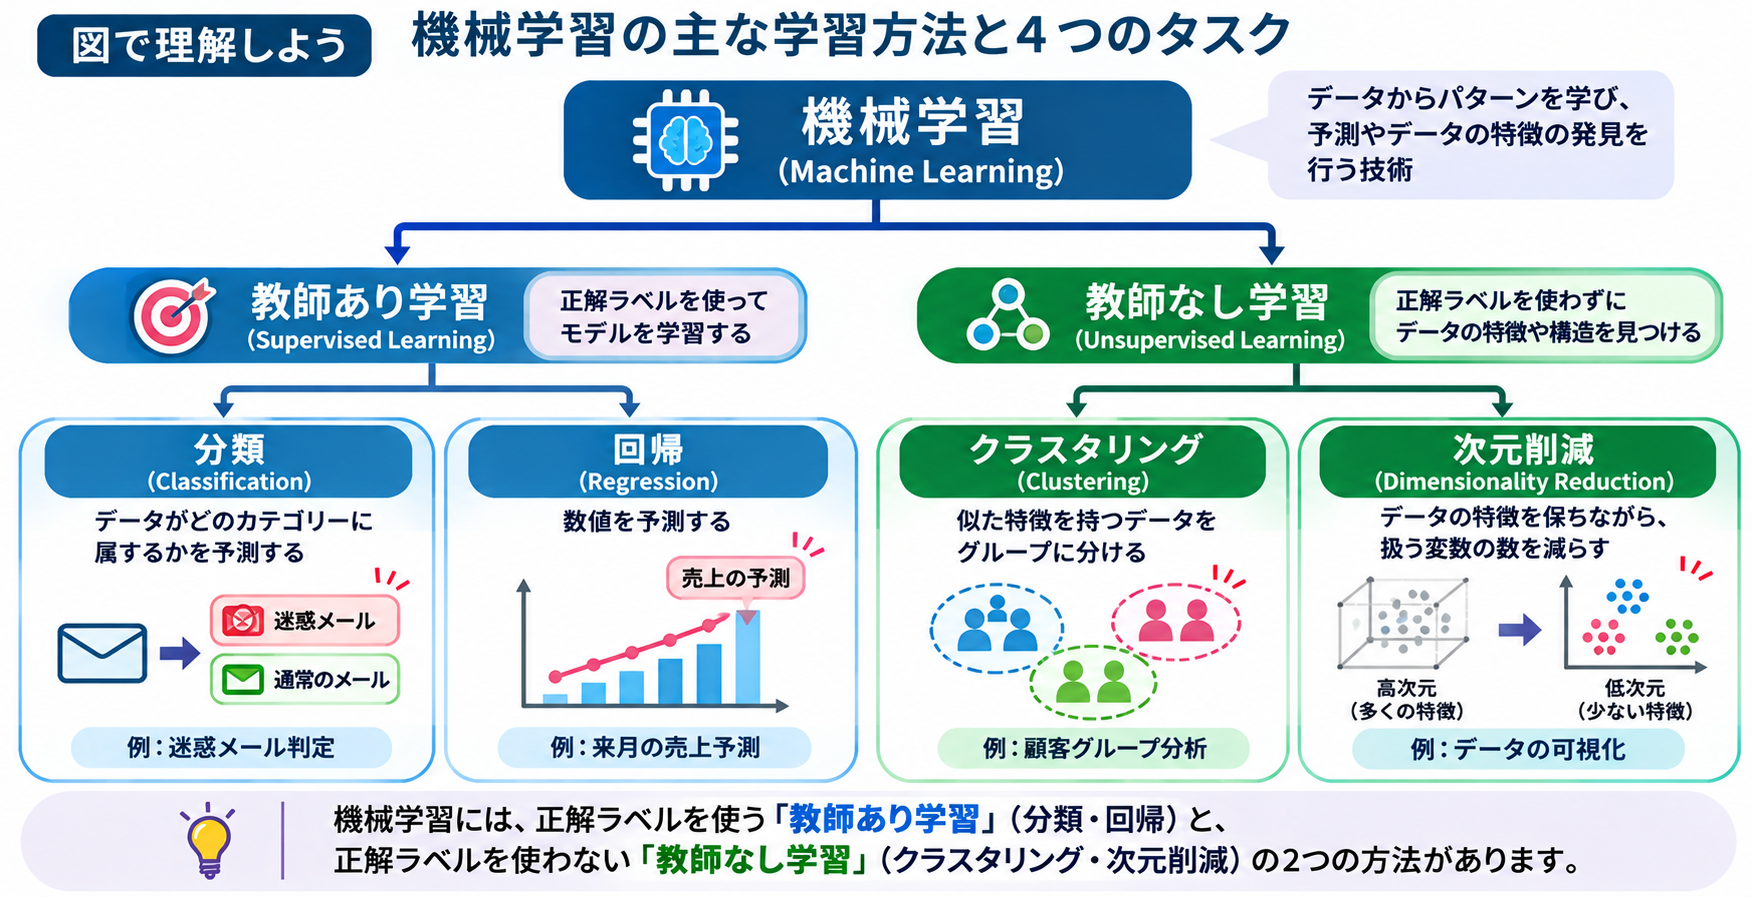
4つの代表的なタスク

学習方法タスク主な目的具体例
教師あり学習分類カテゴリーを予測する迷惑メール判定
教師あり学習回帰数値を予測する売上予測
教師なし学習クラスタリング似たデータをまとめる顧客グループ分析
教師なし学習次元削減データの変数を減らすデータの可視化

2. 分類(Classification)とは?

美月:「まずは分類から教えて。猫と犬を見分けるのも分類なんだよね?」

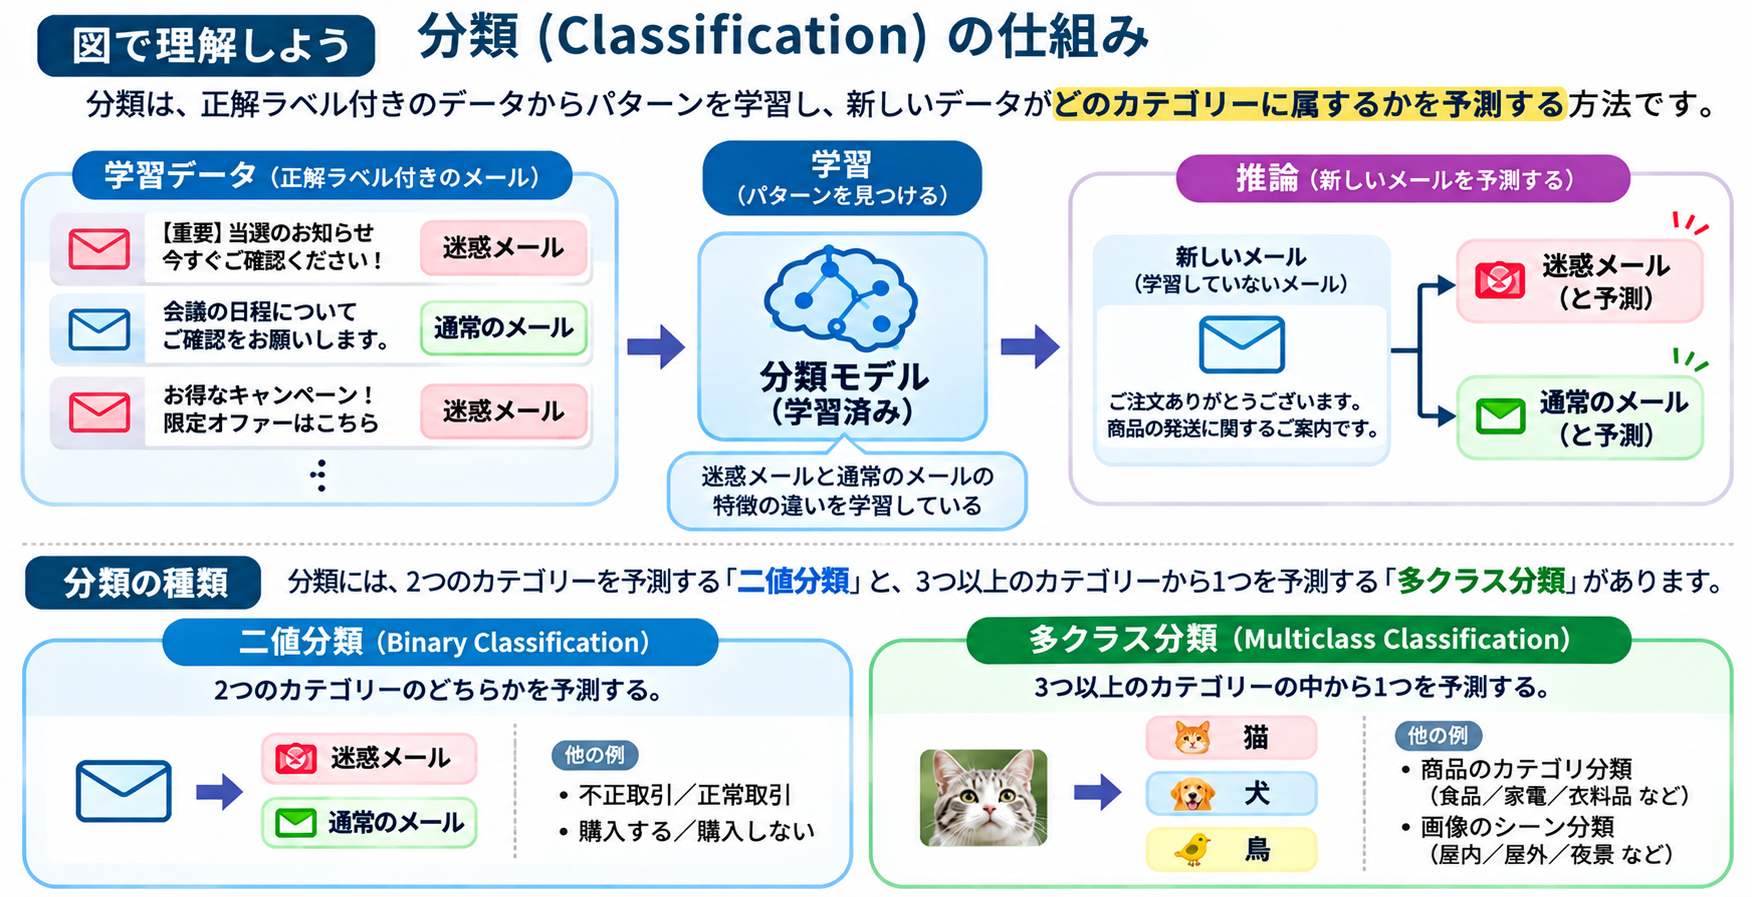
伴菜:「そうよ。分類は、入力されたデータが、あらかじめ決められたカテゴリーのどれに属するかを予測する方法なの」

美月:「例えば、メールが迷惑メールかどうかを判断するのも?」

伴菜:「そのとおり。過去のメールと正解ラベルを使って学習したモデルが、新しいメールを判定するのよ」

美月:「でも、迷惑メールっぽい普通のメールもあるよね?」

伴菜:「もちろん。だからモデルは間違えることもあるの。予測結果がどれくらい正しいかを評価することが大切なのよ」

分類の仕組み

美月:「ハンナ、分類って、実際にはどうやって正しいカテゴリーを判断しているの?」

伴菜:「例えば、迷惑メールを判定するAIを考えてみましょう。まず、過去のメールをたくさん用意して、それぞれに『迷惑メール』か『通常のメール』という正解ラベルを付けるのよ」

美月:「メールの内容と正解をセットにして教えるんだね!」

伴菜:「そうよ。AIはメールの文章や送信者などの情報と、正解ラベルの関係を学習するの。そして、新しいメールが届いたときに、学習したパターンを使って、どちらのカテゴリーに属するかを予測するのよ」

美月:「じゃあ、初めて見るメールでも、学習した特徴を使って判断できるんだ!」

伴菜:「そのとおり。ただし、学習したことのないパターンが出てきたり、迷惑メールの手口が変わったりすると、予測を間違えることもあるわ。だから、学習したモデルが新しいデータにも対応できるかを確認することが大切なのよ」

二値分類と多クラス分類

美月:「ところで、分類って、いつも2つのカテゴリーから選ぶの?」

伴菜:「いいえ。分類するカテゴリーの数によって、いくつかの種類があるのよ」

美月:「どんな種類があるの?」

伴菜:「まず、2つのカテゴリーのどちらかを予測する方法を、**二値分類(Binary Classification)**というの。例えば、メールを『迷惑メール』と『通常のメール』に分けたり、取引を『不正取引』と『正常取引』に分けたりする場合ね」

美月:「なるほど。じゃあ、猫と犬と鳥の3種類を見分ける場合は?」

伴菜:「それは、**多クラス分類(Multiclass Classification)**ね。3つ以上のカテゴリーの中から、1つを予測する方法なのよ」

美月:「じゃあ、1枚の写真に猫と犬が両方写っていたら、どうなるの?」

伴菜:「そこに気付くのは大事ね。1つのデータに複数のラベルを付けたい場合には、**マルチラベル分類(Multilabel Classification)**という方法があるのよ」

美月:「つまり、猫と犬が両方写っている写真なら、『猫』と『犬』の両方を予測できるんだね!」

伴菜:「そうよ。整理すると、二値分類は2つから1つ、多クラス分類は3つ以上から1つ、マルチラベル分類は複数のラベルを同時に予測できる方法なの」

美月:「同じ分類でも、予測したい答えの種類によって方法が違うんだね!」
分類モデルはどう評価する?

美月:「ハンナ、分類モデルがちゃんと学習できたかどうかは、どうやって確認するの?」

伴菜:「いい質問ね。学習に使っていない評価用のデータを使って、モデルの予測と実際の正解を比較するのよ」

美月:「何問中、何問正解したかを調べる感じ?」

伴菜:「そうね。それが**正解率(Accuracy)**よ。例えば、100件のメールのうち90件を正しく判定できたら、正解率は90%になるわ」

美月:「90%なら、かなり優秀なんじゃない?」

伴菜:「そう思うでしょう? でも、正解率だけでは分からないこともあるのよ」

美月:「えっ、どういうこと?」

伴菜:「例えば、100件のメールのうち95件が通常のメールで、迷惑メールが5件だったとするでしょう? もしAIが全部を『通常のメール』と判定しても、正解率は95%になるの」

美月:「ええっ! 迷惑メールを1件も見つけていないのに95%なの?」

伴菜:「そうなの。だから、どんな間違いをしているのかも確認する必要があるのよ」

美月:「じゃあ、ほかにはどんな評価方法があるの?」

伴菜:「代表的なのが、**適合率(Precision)と再現率(Recall)**よ。迷惑メールを検出する場合で説明するわね」

伴菜:「適合率は、AIが『迷惑メール』と判定したメールのうち、実際に迷惑メールだった割合なの」

美月:「つまり、迷惑メールだと言ったときに、どれくらい当たっているかってこと?」

伴菜:「そのとおり。適合率が低いと、大切なメールまで迷惑メールと判定してしまう可能性が高くなるわ」

美月:「それは困るね。大事な連絡を見逃しちゃうかもしれない!」

伴菜:「一方、再現率は、実際に迷惑メールだったもののうち、AIがどれくらい見つけられたかを表すのよ」

美月:「再現率が低いと、迷惑メールをたくさん見逃してしまうんだね」

伴菜:「そうよ。そして、適合率と再現率の両方を考慮する代表的な指標が、**F1スコア(F1 Score)**なの。これは2つの値の調和平均で計算するのよ」

美月:「なるほど! 正解率だけじゃなくて、間違い方も大切なんだね」

伴菜:「そのとおり。重要なメールを迷惑メールに振り分ける間違いと、迷惑メールを見逃す間違いでは、影響が違うでしょう? だから、AIを何に使うのかによって、重視する評価指標も変わるのよ」

美月:「AIの評価って、単に正解が多ければいいというわけじゃないんだね!」

3. 回帰(Regression)とは?

美月:「じゃあ、回帰って何なの? 分類とは違うの?」

伴菜:「分類がカテゴリーを予測するのに対して、回帰は数値を予測する方法なのよ」

美月:「数値って、例えばテストの点数とか?」

伴菜:「そうね。ほかにも、住宅価格や将来の売上金額、電力消費量などを予測するときに使われるの」

美月:「売上を予測できるなら、お店の経営にも役立ちそう!」

伴菜:「そうよ。ただし、予測はあくまで予測なの。過去のデータにない大きな変化が起きると、予測が外れることもあるわ」

回帰の仕組み

美月:「ハンナ、分類は『迷惑メールかどうか』みたいにカテゴリーを予測するんだよね。じゃあ、回帰はどうやって数値を予測するの?」

伴菜:「例えば、お店の来月の売上を予測するとしましょう。過去の売上金額や来店客数、広告費、曜日などのデータを使って、売上に関係するパターンを学習するのよ」

美月:「広告費が多い月は売上も増えるとか、週末はお客さんが多いとか、そういう関係を見つけるんだね!」

伴菜:「そうよ。そして、学習したモデルに新しい条件を入力すると、売上金額を予測できるの。例えば『来月の売上は450万円』というように、数値で結果が出るのよ」

美月:「なるほど! 分類なら『売上が高い・低い』だけど、回帰なら『450万円』みたいに具体的な金額を予測するんだ!」

伴菜:「そのとおり。分類はカテゴリーを予測し、回帰は数値を予測する。これが大きな違いなのよ」

線形回帰(Linear Regression)

美月:「でも、AIはどうやって売上金額を計算するの?」

伴菜:「回帰にはいろいろな方法があるけれど、代表的なのが**線形回帰(Linear Regression)**よ」

美月:「線形って、直線のこと?」

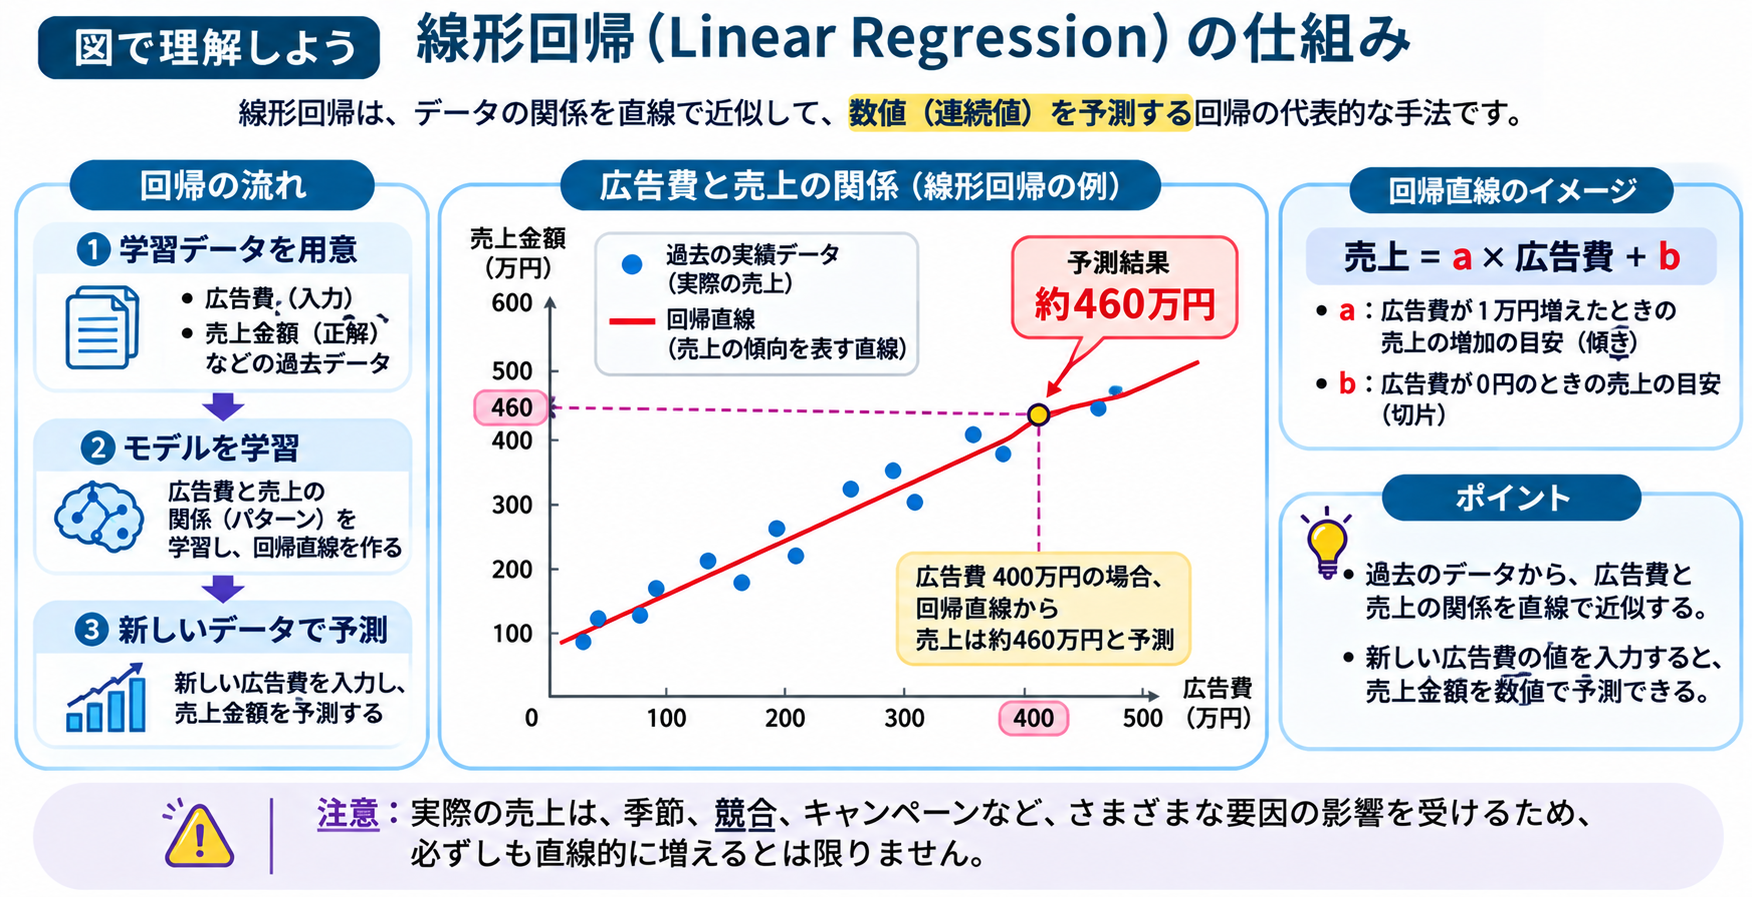
伴菜:「そうよ。例えば、横軸に広告費、縦軸に売上金額を取って、過去の実績を点で描いてみるの。もし広告費が増えるほど売上も増える傾向があれば、点の並びを直線で近似できることがあるわ」

美月:「点がたくさんあって、その真ん中あたりを直線が通るイメージかな?」

伴菜:「そうね。ただし、適当に直線を引くわけではないの。一般的な線形回帰では、実際の値と直線による予測値の差を二乗して合計し、その値ができるだけ小さくなるように直線を求めるのよ。これを**最小二乗法(Least Squares Method)**というの」

美月:「なるほど! できるだけ実際のデータに合う直線を計算するんだね」

伴菜:「そのとおり。そして、新しい広告費をその直線に当てはめると、売上金額を予測できるのよ」

美月:「例えば、広告費が400万円だったら、売上が460万円になると予測するような感じ?」

伴菜:「そうよ。図の例ではそういう予測になっているわ。ただし、これは説明のための仮のデータなの。実際の売上は季節や競合、キャンペーンなど、いろいろな要因の影響を受けるから、広告費だけで正確に予測できるとは限らないのよ」

美月:「そうだよね。広告を増やせば必ず売上が増えるわけじゃないもんね」

伴菜:「そのとおり。それに、線形回帰で関係が見つかったとしても、広告費が売上増加の原因だと証明できたわけではないことにも注意が必要よ」
回帰モデルはどう評価する?

美月:「ハンナ、回帰モデルが予測した売上金額が正しいかどうかは、どうやって評価するの?」

伴菜:「分類では正解率などを使ったけれど、回帰では予測値と実際の値がどれくらい違うかを調べるのよ」

美月:「例えば、450万円と予測したのに、実際は400万円だったら、50万円外れたってこと?」

伴菜:「そうよ。その差を予測誤差というの。回帰モデルでは、こうした誤差を複数のデータで調べて評価するのよ」

美月:「どんな評価方法があるの?」

伴菜:「代表的なのは、MAE、MSE、RMSEの3つね。順番に説明するわ」

MAE(平均絶対誤差)

伴菜:「まず、**MAE(Mean Absolute Error:平均絶対誤差)**は、予測がどれくらい外れたかを、誤差の絶対値で平均したものなの」

美月:「絶対値って、マイナスを気にせず、差の大きさだけを見るんだよね?」

伴菜:「そうよ。例えば、3か月分の売上予測で、実際との差がプラス10万円、マイナス20万円、プラス30万円だったとするでしょう?」

美月:「差の大きさは10万円、20万円、30万円だから、平均すると20万円だね!」

伴菜:「正解! この場合、MAEは20万円になるの。予測が平均してどのくらい外れているかを、元の売上と同じ単位で理解しやすい指標なのよ」

MSE(平均二乗誤差)

美月:「じゃあ、MSEは何が違うの?」

伴菜:「**MSE(Mean Squared Error:平均二乗誤差)**は、予測誤差をそれぞれ二乗してから平均するのよ」

美月:「二乗するってことは、10万円の誤差なら100、20万円なら400、30万円なら900になるんだね?」

伴菜:「そうよ。今回の例なら、100、400、900を平均して、約466.7になるわ。単位は万円の二乗になるのよ」

美月:「でも、どうしてわざわざ二乗するの?」

伴菜:「大きな誤差を、より強く評価に反映させるためよ。例えば、10万円の誤差と30万円の誤差では、二乗すると100と900になるでしょう? 大きく外れた予測の影響が強くなるの」

美月:「なるほど! 大きな予測ミスを特に問題にしたいときに役立つんだね」

RMSE(二乗平均平方根誤差)

美月:「じゃあ、RMSEは?」

伴菜:「**RMSE(Root Mean Squared Error:二乗平均平方根誤差)**は、MSEの平方根を取ったものなの」

美月:「平方根を取ると、どうなるの?」

伴菜:「MSEは誤差を二乗しているから、元の売上金額とは単位が違ってしまうでしょう? 平方根を取ると、元の単位に戻せるのよ」

美月:「じゃあ、今回のMSEが約466.7なら、RMSEは?」

伴菜:「約21.6万円になるわ。MAEと同じように金額で理解できるけれど、大きな誤差の影響をより強く受けるという特徴があるのよ」

美月:「なるほど! MAEは誤差の大きさを平均して、MSEは二乗して大きな誤差を重く扱う。RMSEはその平方根を取って、元の単位で表すんだね!」

伴菜:「完璧よ。ただし、どの指標が最適かは、予測の目的や大きな誤差をどれくらい重視するかによって変わるの。評価指標は、目的に合わせて選ぶことが大切なのよ」

4. クラスタリング(Clustering)とは?

美月:「教師なし学習のクラスタリングって、分類と似ているよね?」

伴菜:「そう見えるわよね。でも、分類は正解ラベルを使って決められたカテゴリーを予測するのに対して、クラスタリングはデータの特徴からグループを見つけるのよ」

美月:「例えば、どんなことに使えるの?」

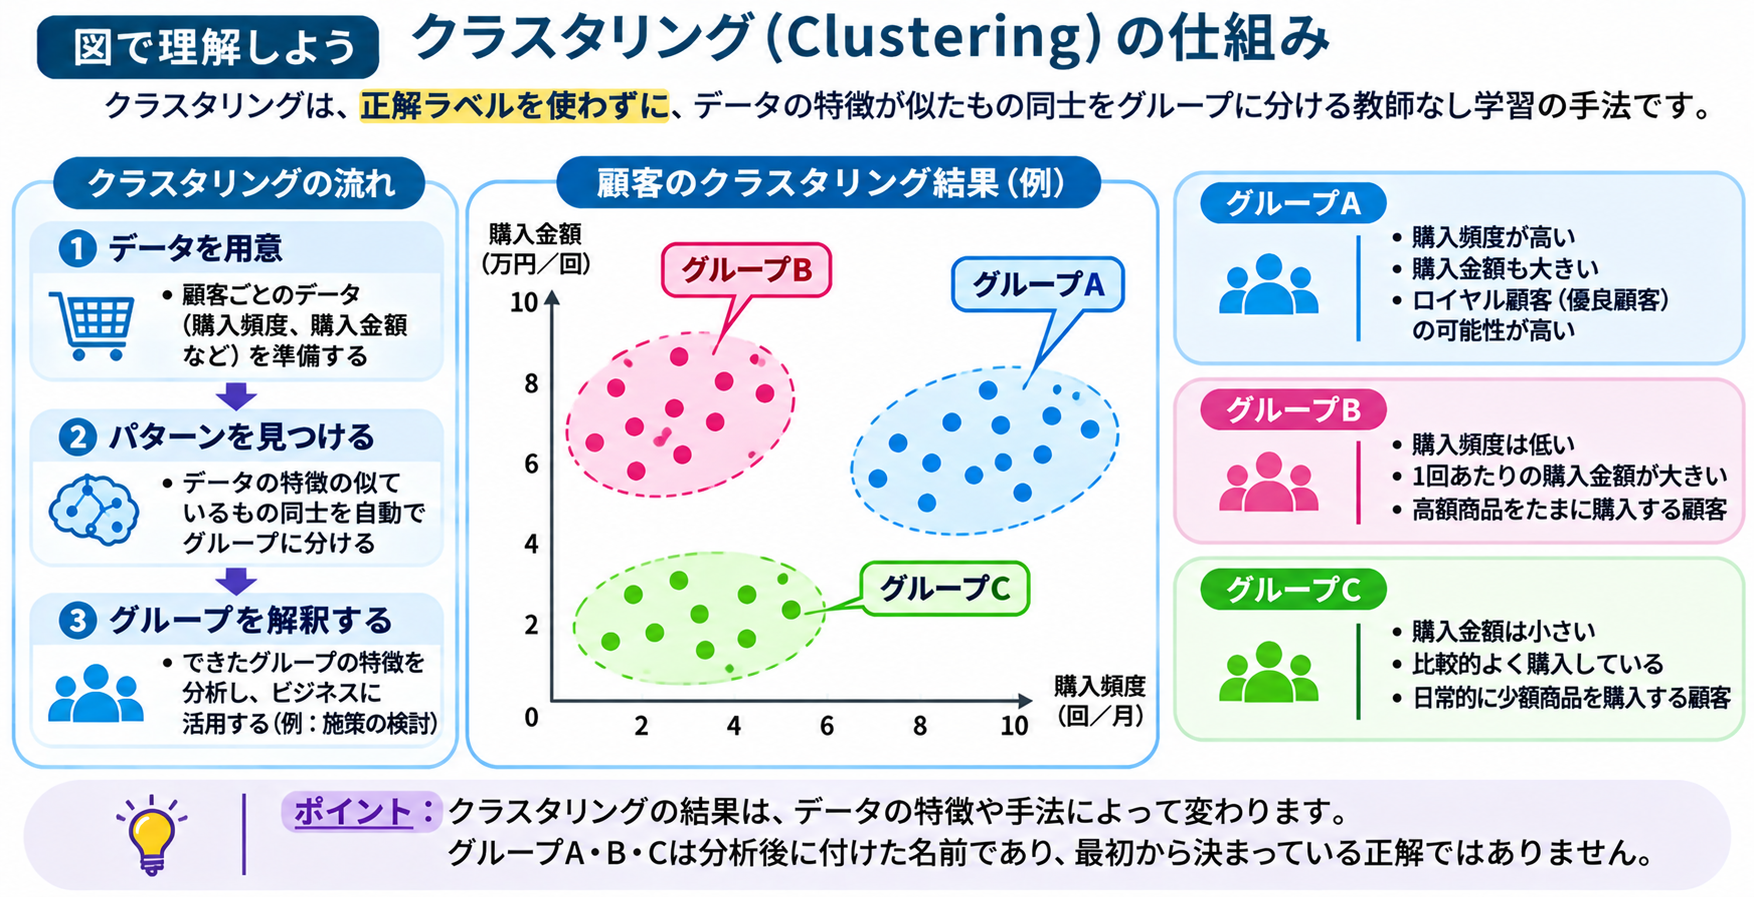
伴菜:「ネットショップの顧客を、購入履歴や購入頻度などからグループに分けることができるわ」

美月:「よく買い物する人と、たまに買う人を分ける感じ?」

伴菜:「そうね。ただし、どんなグループができるかは、使うデータや分析方法によって変わるのよ」

クラスタリングの仕組み

美月:「ハンナ、クラスタリングって、似ているデータをグループに分けるんだよね。でも、何を基準に似ているって判断するの?」

伴菜:「例えば、ネットショップの顧客を分析する場合を考えてみましょう。顧客ごとに、購入金額や購入頻度、どんな商品を買っているかといったデータがあるでしょう?」

美月:「うん。毎週買い物する人もいれば、たまに高い商品を買う人もいるよね」

伴菜:「そうね。クラスタリングでは、そうした特徴を数値として表して、似た特徴を持つ顧客同士をグループにまとめるのよ」

美月:「例えば、どんなグループができるの?」

伴菜:「分析の結果として、こんなグループが見つかるかもしれないわ」

  • グループA: 購入頻度が高く、購入金額も大きい顧客
  • グループB: 購入頻度は低いけれど、一度の購入金額が大きい顧客
  • グループC: 少額の商品を定期的に購入する顧客

美月:「なるほど! お客さんの買い物の仕方によって、グループができるんだね!」

伴菜:「そのとおり。でも、ここで大切なのは、最初から『この人はグループA』という正解を教えているわけではないことなの」

美月:「じゃあ、AIがグループを作ってから、人間がその特徴を調べるの?」

伴菜:「そうよ。例えば、あるグループには購入頻度の高い顧客が多いと分かったら、人間が『リピーター層』と名前を付けることもできるわ」

美月:「つまり、グループの名前はAIが最初から知っているわけじゃないんだね」

伴菜:「そのとおり。クラスタリングは、データの中にある似た特徴やまとまりを見つける方法なの。どんなグループができるかは、使うデータや分析方法によって変わるのよ」

美月:「分類は決められたカテゴリーを予測するけど、クラスタリングはデータからグループを見つけるんだね!」

伴菜:「そうよ。その違いが分かれば、分類とクラスタリングを混同しなくなるわね」

K-means(K平均法)

美月:「ハンナ、クラスタリングって、どうやって似たデータをグループに分けているの?」

伴菜:「いろいろな方法があるけれど、代表的なのが**K-means(K平均法)**という手法なのよ」

美月:「K-means? なんだか数学っぽい名前だね」

伴菜:「ふふっ、そうね。でも、基本的な考え方はそれほど難しくないわ。K-meansは、データをあらかじめ指定した数のグループに分ける方法なの」

美月:「じゃあ、3つのグループに分けたいなら、最初に『3』って指定するの?」

伴菜:「そのとおり。このグループの数を表すのが『K』なのよ。K=3なら、3つのクラスターを作ることを目指すの」

美月:「でも、どのお客さんをどのグループに入れるかは、どうやって決めるの?」

伴菜:「まず、3つのクラスターの中心となる点を初期設定するの。そして、それぞれの顧客データを、最も近い中心のグループに割り当てるのよ」

美月:「近い中心って、どういうこと?」

伴菜:「例えば、横軸を購入頻度、縦軸を購入金額としたグラフを考えてみて。購入頻度も購入金額も似ている顧客なら、グラフ上でも近い位置に並びやすいでしょう?」

美月:「ああ、なるほど! グラフの点同士の距離で考えるんだね!」

伴菜:「そうよ。一般的なK-meansでは、特徴を数値で表して、その距離を使ってグループを決めるの」

美月:「それで、最初に近い中心を選んだら終わり?」

伴菜:「いいえ。各グループに割り当てられたデータの平均位置を計算して、中心を更新するの。そして、もう一度、各データを最も近い中心に割り当て直すのよ」

美月:「中心を動かして、またグループ分けするんだ!」

伴菜:「そうなの。この処理を繰り返して、グループの割り当てや中心がほとんど変わらなくなったら終了するのよ」

美月:「なるほど! 最初にグループの数を決めて、近い中心に集めて、中心を調整する。それを繰り返すんだね!」

伴菜:「そのとおり。ただし、K-meansには注意点もあるのよ」

美月:「どんな注意点?」

伴菜:「例えば、購入頻度が月1〜10回、購入金額が1,000〜100,000円だったら、数値の大きさがずいぶん違うでしょう?」

美月:「確かに、購入金額の数字の方がずっと大きいね」

伴菜:「そのまま距離を計算すると、購入金額の違いが強く影響することがあるの。だから、必要に応じてデータを標準化するなど、前処理が重要になるのよ」

美月:「なるほど。数字の大きさが違うだけで、グループ分けの結果も変わるんだね」

伴菜:「そうよ。それに、最初に指定するKの値や中心の初期位置によっても結果が変わることがあるわ」

美月:「じゃあ、K=3にすれば、必ず意味のある3つのグループが見つかるわけじゃないんだね」

伴菜:「そのとおり。K-meansは指定された数のクラスターに分けるけれど、それがビジネス上意味のあるグループとは限らないの。だから、分析結果を人間が確認して、役立つ分類になっているかを評価することが大切なのよ」

美月:「クラスタリングって、AIにグループを作ってもらうだけじゃなくて、その結果をどう解釈するかも重要なんだね!」

伴菜:「そうよ。AIが見つけたパターンを、実際の課題解決につなげることが大切なの」

5. 次元削減(Dimensionality Reduction)とは?

美月:「ハンナ、次元削減って名前が難しそう。次元って何なの?」

伴菜:「ここでいう次元は、データを表す特徴や変数の数だと考えると分かりやすいわ」

美月:「例えば、顧客の年齢、購入金額、購入頻度があったら3次元?」

伴菜:「そうよ。その3つの特徴で顧客を表しているなら、3次元のデータと考えられるの」

美月:「じゃあ、次元削減は、その数を減らすってこと?」

伴菜:「そのとおり。ただ単に情報を捨てるのではなく、重要な特徴や構造をできるだけ残しながら、少ない変数で表現することを目指すのよ」

なぜ次元削減が必要なの?

美月:「ハンナ、次元削減っていう言葉が出てきたけど、そもそも『次元』って何なの?」

伴菜:「機械学習では、データを表す特徴の数を『次元』と呼ぶことが多いのよ。例えば、顧客を年齢、購入金額、購入頻度の3つの特徴で表すなら、3次元のデータになるわ」

美月:「なるほど! 特徴が3つなら3次元、10個なら10次元なんだね!」

伴菜:「そうよ。実際のデータには、数十、数百、場合によっては数千以上の特徴が含まれることもあるの」

美月:「そんなにたくさん? 例えば、どんなデータ?」

伴菜:「画像データが分かりやすいわね。例えば、100×100ピクセルの白黒画像なら、各ピクセルの明るさを1つの数値で表すと、10,000個の数値になるのよ」

美月:「ええっ! 小さな画像1枚でも10,000次元になるんだ!」

伴菜:「そうなの。特徴が多いと、処理によっては計算量が増えたり、データ同士の関係を人間が理解しにくくなったりすることがあるのよ」

美月:「確かに、3次元ならグラフにできるけど、10,000次元なんて想像もできないね」

伴菜:「そこで役立つのが、**次元削減(Dimensionality Reduction)**なの。元のデータが持つ情報をできるだけ残しながら、より少ない特徴で表現することを目指すのよ」

美月:「つまり、複雑なデータを、できるだけ分かりやすい形にするんだね!」

伴菜:「そうね。ただし、次元を減らせば必ず性能が良くなるわけではないの。何のために次元削減をするのかが大切なのよ」

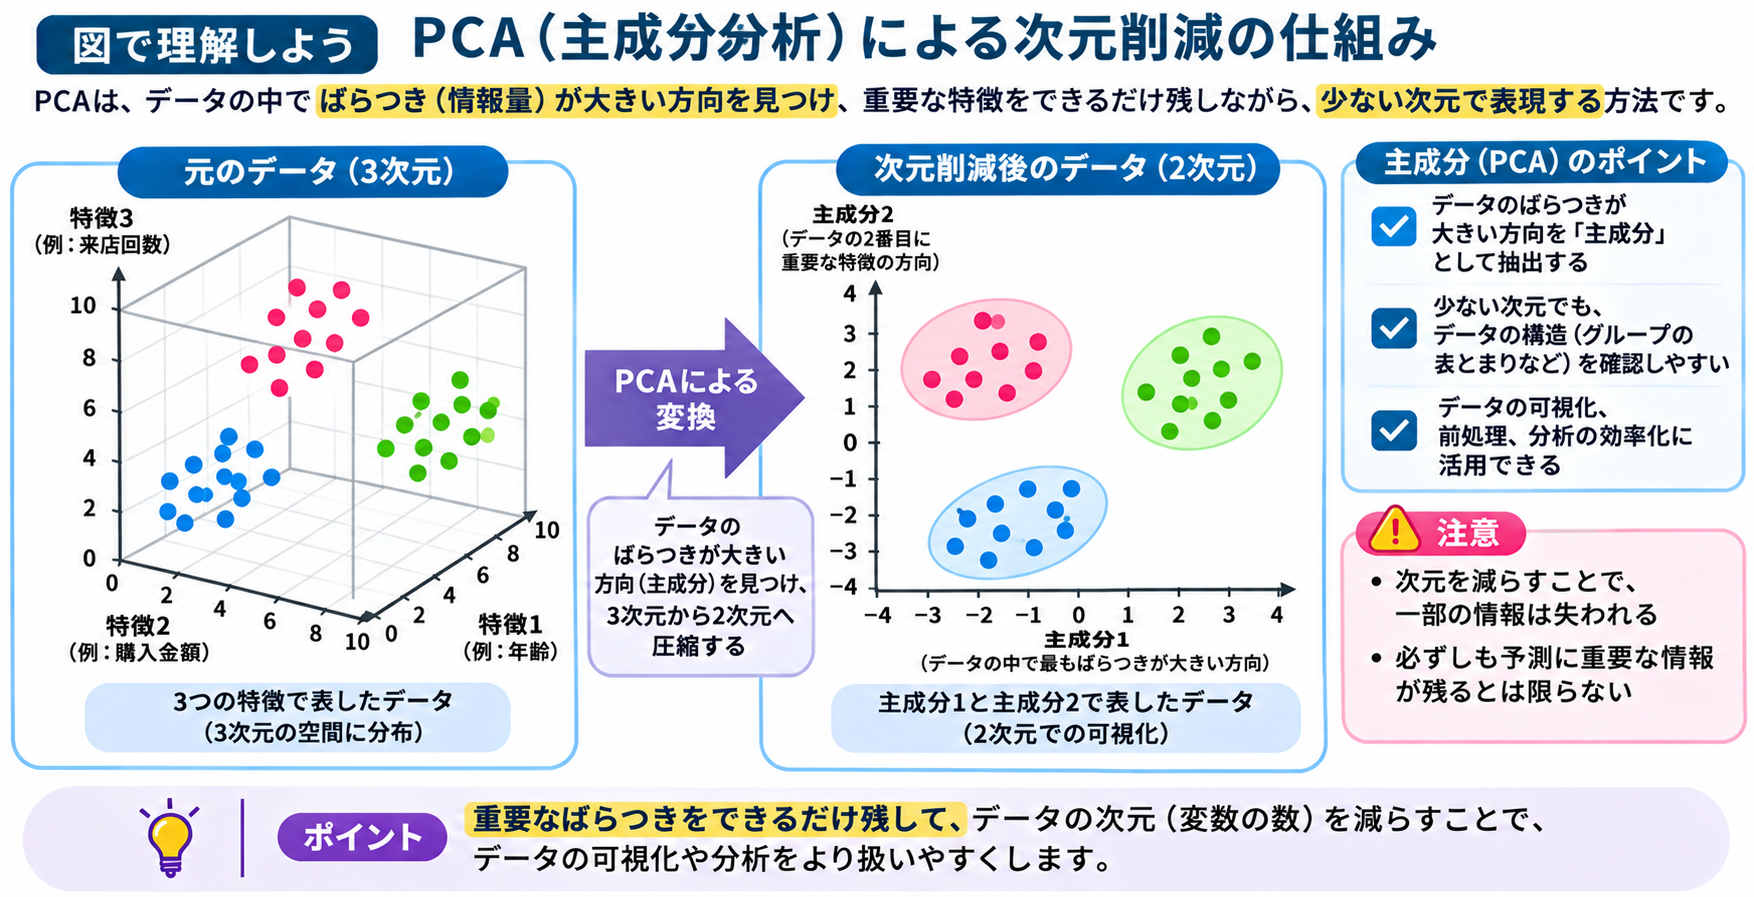
PCA(主成分分析)

美月:「じゃあ、実際にはどうやって次元を減らすの?」

伴菜:「代表的な方法に、**PCA(Principal Component Analysis:主成分分析)**という手法があるのよ」

美月:「PCAって、特徴が10個あったら、そのうち重要そうな5個を選んで残すの?」

伴菜:「そう考えたくなるわよね。でも、PCAは単純に元の特徴を選んで残す方法ではないの。元の特徴を組み合わせて、新しい軸を作るのよ」

美月:「新しい軸? どういうこと?」

伴菜:「例えば、顧客の『年齢』『購入金額』『購入頻度』を使った3次元のデータを考えてみましょう。データを点で表すと、点がいろいろな方向に広がっているでしょう?」

美月:「うん。お客さんによって年齢も買い物の仕方も違うもんね」

伴菜:「PCAでは、その点の集まりが最も大きくばらついている方向を探すの。そして、その方向を新しい軸にするのよ。これを**第1主成分(Principal Component 1)**というの」

美月:「ばらつきが大きい方向って、点が一番広く散らばっている方向のこと?」

伴菜:「そのとおり。次に、第1主成分と直交する方向の中から、残っているばらつきが最も大きい方向を探すの。それが**第2主成分(Principal Component 2)**よ」

美月:「なるほど! 元の年齢や購入金額の軸とは違う、新しい軸を作るんだね!」

伴菜:「そうよ。PCAの主成分は、元の特徴を重み付きで組み合わせたものなの。だから、第1主成分も第2主成分も、複数の特徴の情報を含んでいることがあるのよ」

美月:「じゃあ、3次元のデータを第1主成分と第2主成分の2つだけで表せば、2次元にできるんだ!」

伴菜:「そのとおり。元の3次元データを、2つの主成分で表すことで、平面の散布図として確認できるようになるのよ」

美月:「それなら、データのまとまりや特徴も見つけやすくなりそう!」

伴菜:「そうね。特に、たくさんの特徴を持つデータを可視化するときに役立つことがあるわ」

美月:「でも、3次元を2次元にしたら、何か情報がなくなっちゃうんじゃない?」

伴菜:「いいところに気付いたわね。実際、次元を減らすことで、一部の情報が失われることがあるの。PCAは、残す主成分でデータのばらつきをできるだけ多く表現しようとする方法なのよ」

美月:「じゃあ、ばらつきが大きい情報を残せば、AIの予測にも役立つんだね!」

伴菜:「必ずしもそうとは限らないの。ここは大切なポイントよ」

美月:「えっ、どうして?」

伴菜:「PCAが重視するのは、データの分散、つまりばらつきの大きさなの。でも、ばらつきが大きい特徴が、必ずしも予測したい答えに重要とは限らないでしょう?」

美月:「ああ、なるほど。データの違いが大きいことと、予測に役立つことは別なんだね」

伴菜:「そのとおり。例えば、ある特徴のばらつきは小さくても、迷惑メールかどうかを判断するうえで重要な情報かもしれないわ。PCAでその情報を十分に残せなければ、予測性能が下がる可能性もあるのよ」

美月:「だから、次元を減らした後も、ちゃんとモデルを評価する必要があるんだね!」

伴菜:「そうよ。それに、PCAは特徴の尺度にも影響されるから、必要に応じて標準化などの前処理を行うことも重要なの」

美月:「なるほど! PCAは、重要そうな特徴を適当に削るんじゃなくて、データのばらつきをできるだけ残せる新しい軸を作る方法なんだね!」

伴菜:「そのとおり。『重要なばらつきをできるだけ残しながら、次元を減らす』。これがPCAを理解するうえでの基本なのよ」
6. どの学習方法を選べばいいの?

美月:「4つの方法が分かってきたけど、実際に使うときはどうやって選ぶの?」

伴菜:「まずは、何を知りたいのかをはっきりさせることね。カテゴリーを予測したいのか、数値を予測したいのか、それともデータの特徴を発見したいのか」

美月:「目的によって選ぶ方法が違うんだね」

伴菜:「そうよ。それに、利用できるデータや正解ラベルの有無、必要な精度、説明のしやすさなども考える必要があるの」

目的別の使い分け

やりたいこと代表的なタスク
メールが迷惑メールか判断したい分類
来月の売上金額を予測したい回帰
似た購買傾向の顧客を探したいクラスタリング
多数の特徴を少ない変数で表したい次元削減
画像が猫か犬かを予測したい分類
大量の顧客データを2次元で可視化したい次元削減

AIを使わない方がよい場合もある

美月:「ハンナ、ここまでいろいろな機械学習の方法を教えてもらったけど、AIって本当に便利だね! だったら、何でもAIに任せればいいんじゃない?」

伴菜:「ふふっ、そう思うわよね。でも、実はAIを使わない方がいい場合もあるのよ」

美月:「えっ、そうなの? どんな場合?」

伴菜:「例えば、お店で商品の税込価格を計算するとしましょう。税抜価格が1,000円で、税率が10%なら、税込価格はいくらになる?」

美月:「1,100円だよね。そんなの簡単だよ!」

伴菜:「そうでしょう? こういう計算は、税率や端数処理のルールが決まっていれば、普通のプログラムで正確に処理できるの。わざわざ機械学習モデルを作る必要はないわ」

美月:「でも、AIでも計算できるんじゃないの?」

伴菜:「もちろん、計算を支援できるAIもあるわ。でも、機械学習はデータからパターンを学習して予測する技術でしょう? 決まった計算式で答えを求められる処理なら、その式をそのままプログラムにした方が、結果を検証しやすく、動作も予測しやすいのよ」

美月:「なるほど。答えの出し方が決まっているなら、AIに予測させる必要はないんだね!」

伴菜:「そのとおり。一方で、『来月の売上はいくらになるか』『この取引は不正の可能性があるか』といった問題は、単純な計算ルールだけでは判断しにくい場合があるでしょう?」

美月:「うん。いろいろな条件が関係するし、必ず正解できるわけでもないよね」

伴菜:「そういうときには、過去のデータからパターンを学習する機械学習が役立つことがあるのよ」

美月:「つまり、AIが使えるかどうかだけじゃなくて、本当にAIが必要なのかを考えることが大切なんだね!」

伴菜:「そのとおり。AIを使うこと自体が目的になってはいけないの。解決したい問題に合わせて、機械学習、通常のプログラム、あるいはその組み合わせから適切な方法を選ぶことが大切なのよ」

美月:「分かった! AIは何でも解決する魔法じゃなくて、目的に合わせて使う道具なんだね!」

伴菜:「そうよ。どんなに優れた技術でも、使いどころを間違えたら十分な効果は得られないもの。『何を解決したいのか』を最初に考えることが、AIを上手に活用する第一歩なのよ」

7. まとめ

美月:「今日はたくさん覚えたね! 分類はカテゴリーを予測して、回帰は数値を予測する。クラスタリングは似たデータをまとめて、次元削減は特徴の数を減らすんだよね!」

伴菜:「そのとおり。しかも、それぞれ得意なことが違うの。だから、AIを使うときには、まず何を解決したいのかを考えることが大切なのよ」

美月:「なるほど! AIって、何でも同じ方法で学習するわけじゃないんだね」

伴菜:「そうよ。これから学ぶ技術も、今日の4つのタスクと結び付けて考えると理解しやすくなるわ」

理解度チェック

ここまで理解できたかな?

今回は5問の4択問題に挑戦してみよう!

伴菜と美月のAI教室へようこそ!

30 Mins AI の理解度チェックです。

全5問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. 教師あり学習の「分類」に該当するものはどれ?

Q2. 回帰(Regression)の特徴として正しいものはどれ?

Q3. クラスタリングについて正しいものはどれ?

Q4. PCA(主成分分析)の説明として正しいものはどれ?

Q5. 次のうち、機械学習を使わず通常のプログラムで処理する方が一般的に適しているものはどれ?


基本から復習したい人へ

ここまでで、教師あり学習と教師なし学習の違いから、分類・回帰・クラスタリング・次元削減の仕組み、さらにモデルの評価方法まで詳しく学んだよ。

「ちょっと難しかったな」「分類とクラスタリングの違いをもう一度確認したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!

← 3 Minutes AI 第3話へ


次回予告

第4話「分類と回帰の仕組みをもっと詳しく知ろう!」

同じ教師あり学習でも、カテゴリーを予測する分類と、数値を予測する回帰では、モデルの出力や評価方法が違う。

次回は、分類の正解率・適合率・再現率・F1スコア、回帰の予測誤差などを、具体例と図解を使って詳しく学んでいこう!

カテゴリー
2026年 3 Minutes AI AI コンピューター 伴菜と美月のAI教室

3 Mins AI|第3話「教師あり学習と教師なし学習って何が違うの?」

伴菜と美月のAI教室|読了時間:約3分

美月の「これってどういうこと?」

美月:「ねえ、ハンナ。前にAIはデータを使って学習するって教えてくれたよね。でも、AIってどうやって正しい答えを覚えるの?」

伴菜:「いい質問ね。実は、AIの学習にはいくつかの方法があるの。今日は代表的な『教師あり学習』と『教師なし学習』を紹介するわね」

美月:「教師ってことは、AIにも先生がいるの?」

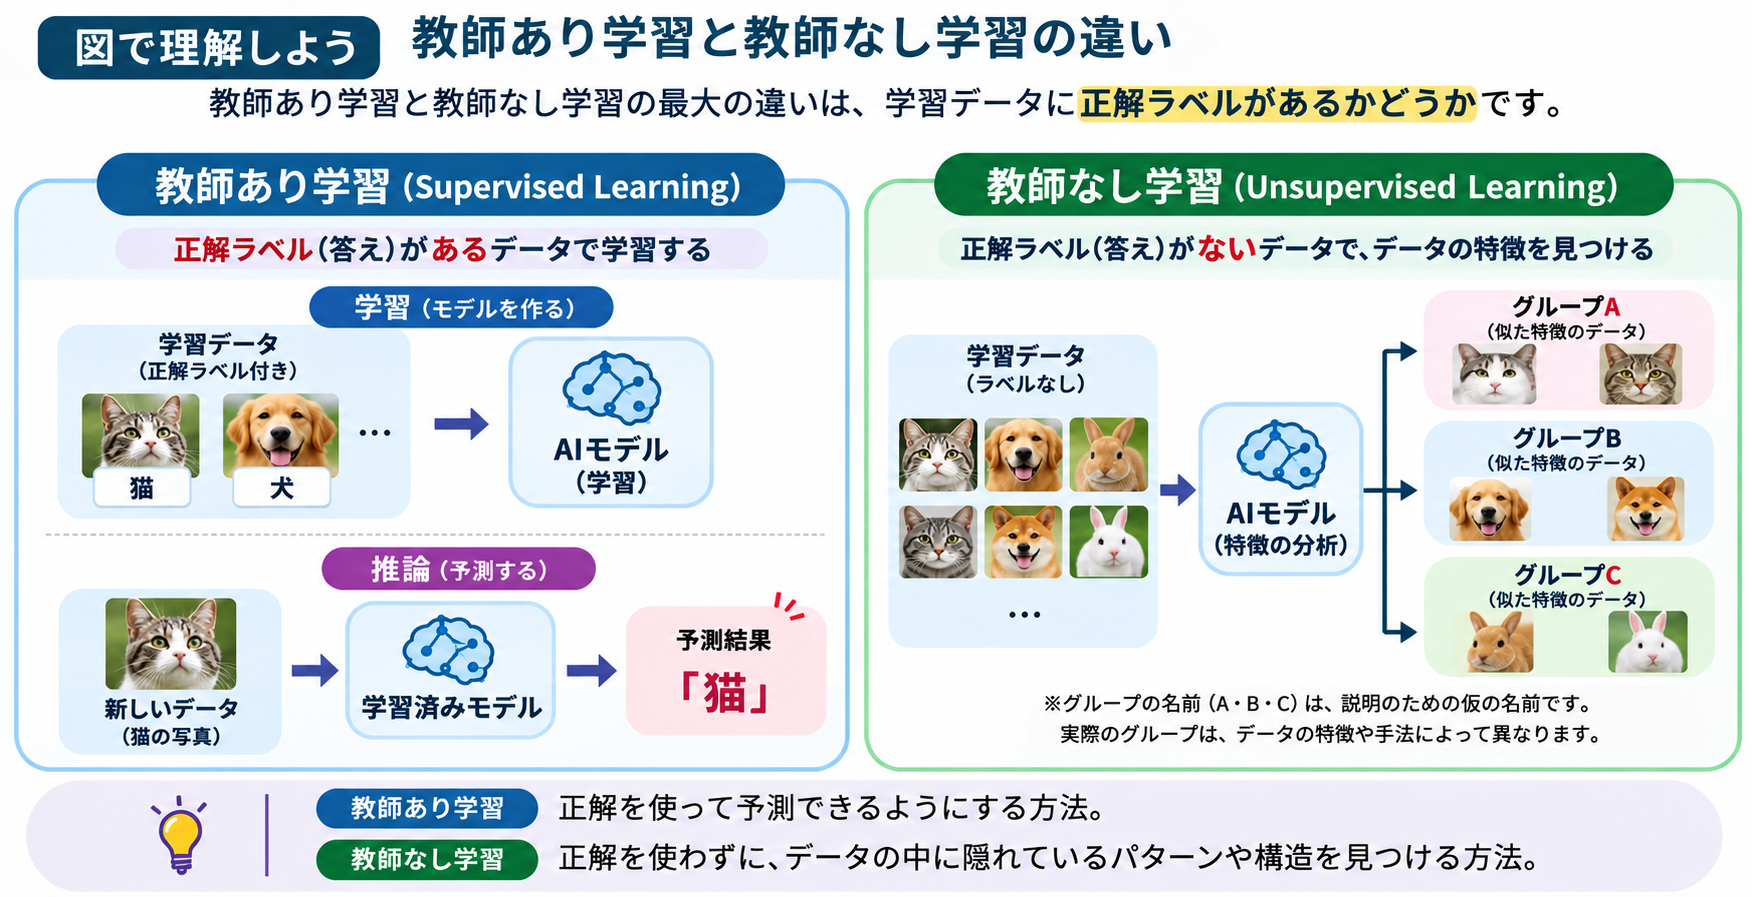
伴菜:「ふふっ、本当の先生がいるわけじゃないのよ。教師あり学習では、正解となる情報を付けたデータを使って学習するの。例えば、猫の写真には『猫』、犬の写真には『犬』という正解を付けて教えるのよ」

美月:「なるほど! じゃあ、教師なし学習は正解を教えないってこと?」

伴菜:「そのとおり。教師なし学習では、正解ラベルを付けずに、データの特徴や似ているもの同士のまとまりを見つけるの。例えば、たくさんの動物の写真を渡して、特徴が似た写真をグループに分けるような方法があるわ」

美月:「でも、正解を教えていないのに、ちゃんと猫と犬に分けられるの?」

伴菜:「必ずしもそうとは限らないの。毛の色や体の大きさなど、別の特徴でグループができることもあるわ。教師なし学習は、人間が期待する分類をそのまま再現するとは限らないのよ」

美月:「そっか! 正解を使って学ぶのが教師あり学習、正解なしでデータの特徴を見つけるのが教師なし学習なんだね!」

伴菜:「そうよ。この違いを理解すると、AIにどんな仕事を任せられるのか、もっと分かるようになるわ」

図で理解しよう

教師あり学習は、正解を使って予測できるようにする方法。

教師なし学習は、正解を使わずにデータの中に隠れているパターンや構造を見つける方法です。

もう少し詳しく

教師あり学習(Supervised Learning)

教師あり学習とは、入力データと正解となる情報を組み合わせてモデルを学習させる方法です。

例えば、過去のメールに「迷惑メール」「通常のメール」という正解ラベルを付けて学習させると、新しく届いたメールが迷惑メールかどうかを予測できるようになります。

教師あり学習の代表的なタスクには、次の2つがあります。

  • 分類(Classification):データがどのカテゴリーに属するかを予測する。例:迷惑メールか通常のメールか。
  • 回帰(Regression):数値を予測する。例:来月の売上金額。

教師なし学習(Unsupervised Learning)

教師なし学習とは、正解ラベルのないデータから、パターンや構造を見つける方法です。

例えば、顧客の購入履歴を分析して、購買傾向の似た顧客をグループに分けることができます。

代表的なタスクには、次のようなものがあります。

  • クラスタリング(Clustering):似た特徴を持つデータをグループに分ける。
  • 次元削減(Dimensionality Reduction):データの重要な特徴をできるだけ残しながら、扱う変数の数を減らす。

教師あり学習と教師なし学習の違い

比較項目教師あり学習教師なし学習
正解ラベルありなし
主な目的予測・分類パターンや構造の発見
代表的なタスク分類、回帰クラスタリング、次元削減
活用例迷惑メール判定、売上予測顧客グループ分析、データの可視化

「分類」と「クラスタリング」は違う

ここは特に間違えやすいポイントです。

分類(Classification) は、あらかじめ決められたカテゴリーを予測する教師あり学習のタスクです。

一方、クラスタリング(Clustering) は、正解ラベルを使わずに、似たデータ同士をグループにまとめる教師なし学習のタスクです。

どちらもデータをグループに分けるように見えますが、正解ラベルを使って学習するかどうかが異なります。

まとめ

美月:「教師あり学習は正解を使って学ぶ方法で、教師なし学習は正解なしでデータの特徴やパターンを見つける方法なんだね!」

伴菜:「そうよ。そして、教師あり学習には『分類』と『回帰』、教師なし学習には『クラスタリング』などがあるの。それぞれ何ができるのかを知ると、AIの使い分けも分かるようになるわ」


理解度チェック

ここまで理解できたかな?

次の3問に挑戦してみよう!

伴菜と美月のAI教室へようこそ!

3 Mins AI の理解度チェックです。

全3問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. 教師あり学習の特徴として正しいものはどれ?

Q2. 教師なし学習の代表的なタスクはどれ?

Q3. 教師なし学習で動物の写真をグループ分けした場合、正しい説明はどれ?


もっと詳しく学びたい人へ

ここまでで、教師あり学習と教師なし学習の違いや、正解ラベルを使う学習と、データの特徴を見つける学習について学んだよ。

30 Minutes AI 第3話では、教師あり学習の「分類」と「回帰」、教師なし学習の「クラスタリング」や「次元削減」などを、具体的な例を使いながらさらに詳しく説明するよ。

→ 30 Minutes AI 第3話へ


次回予告

第4話「分類と回帰って何が違うの?」

迷惑メールかどうかを判定するのが「分類」、将来の売上金額を予測するのが「回帰」。

どちらも教師あり学習だけど、予測するものが違うんだ!

次回は、分類と回帰の違いを、伴菜と美月が身近な例を使って解説するよ!

カテゴリー
2026年 30 Minutes AI AI コンピューター 伴菜と美月のAI教室

30 mins AI 第2話|AIはどうやって勉強するの?

伴菜と美月のAI教室 — 30 Minutes AI

1. AIは何を覚えているの?

休日の午後。伴菜と美月は、ノートパソコンに並んだ猫と犬の写真を眺めていた。

美月:「ハンナ、3分版では、猫と犬の写真を使ってAIが学習するって教えてもらったよね」

伴菜:「そうね。今日は、AIが学習するとき、コンピューターの中で何が起きているのか、もう少し詳しく見てみようか」

美月:「AIって、猫の写真をたくさん覚えているの?」

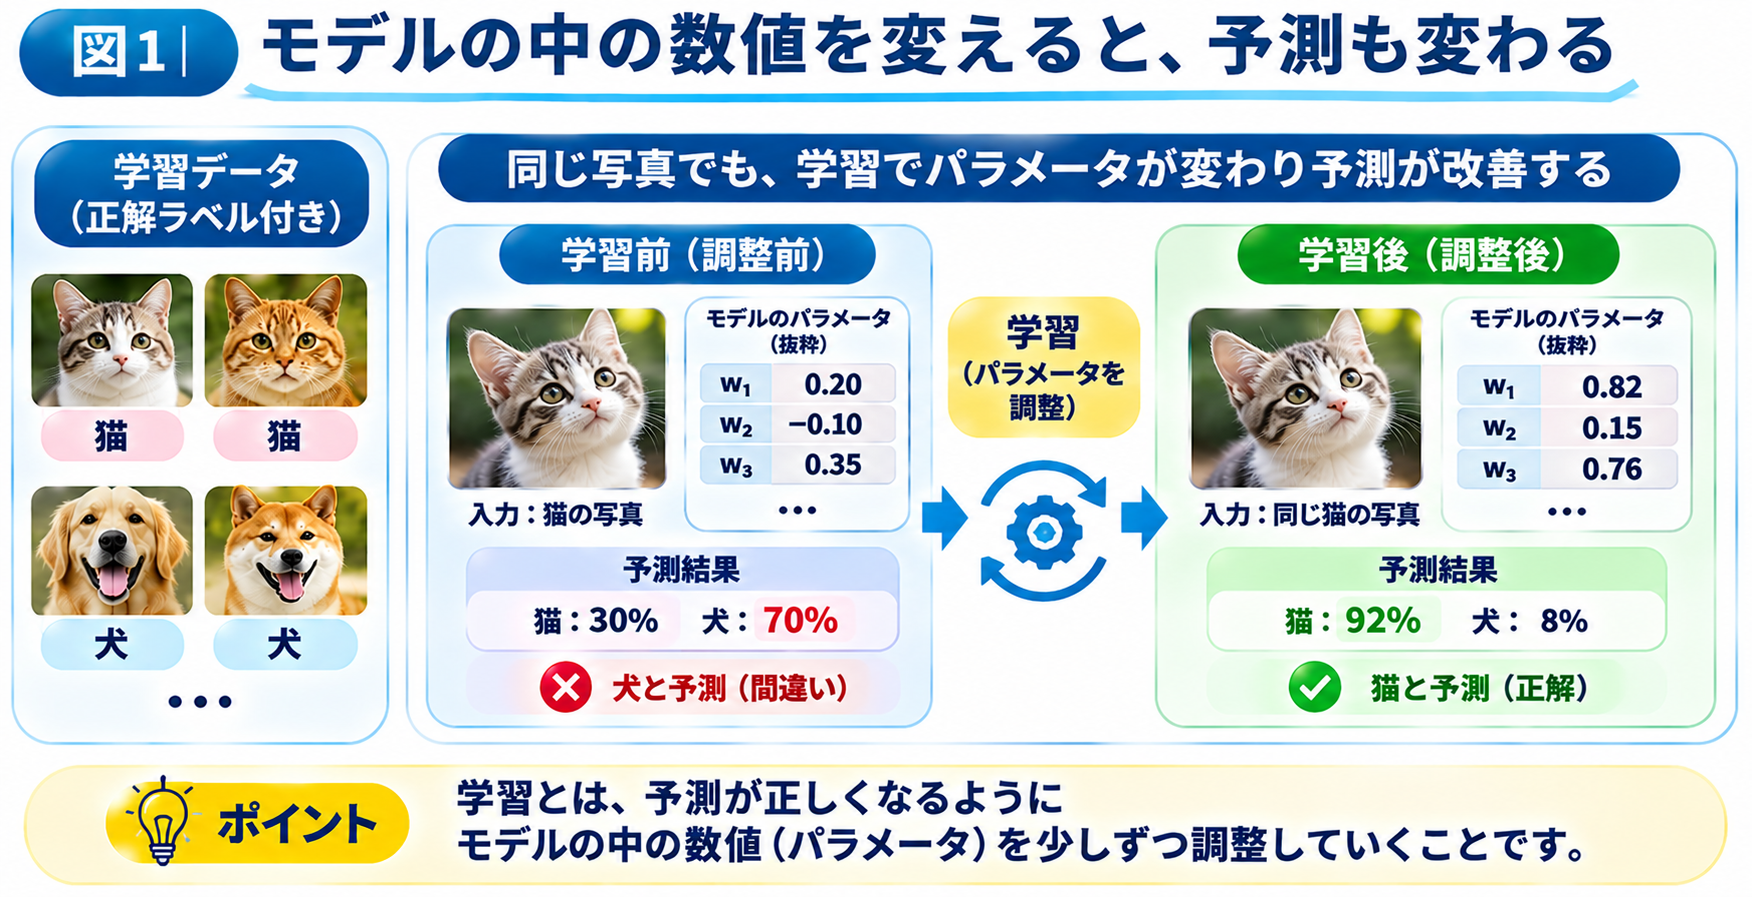
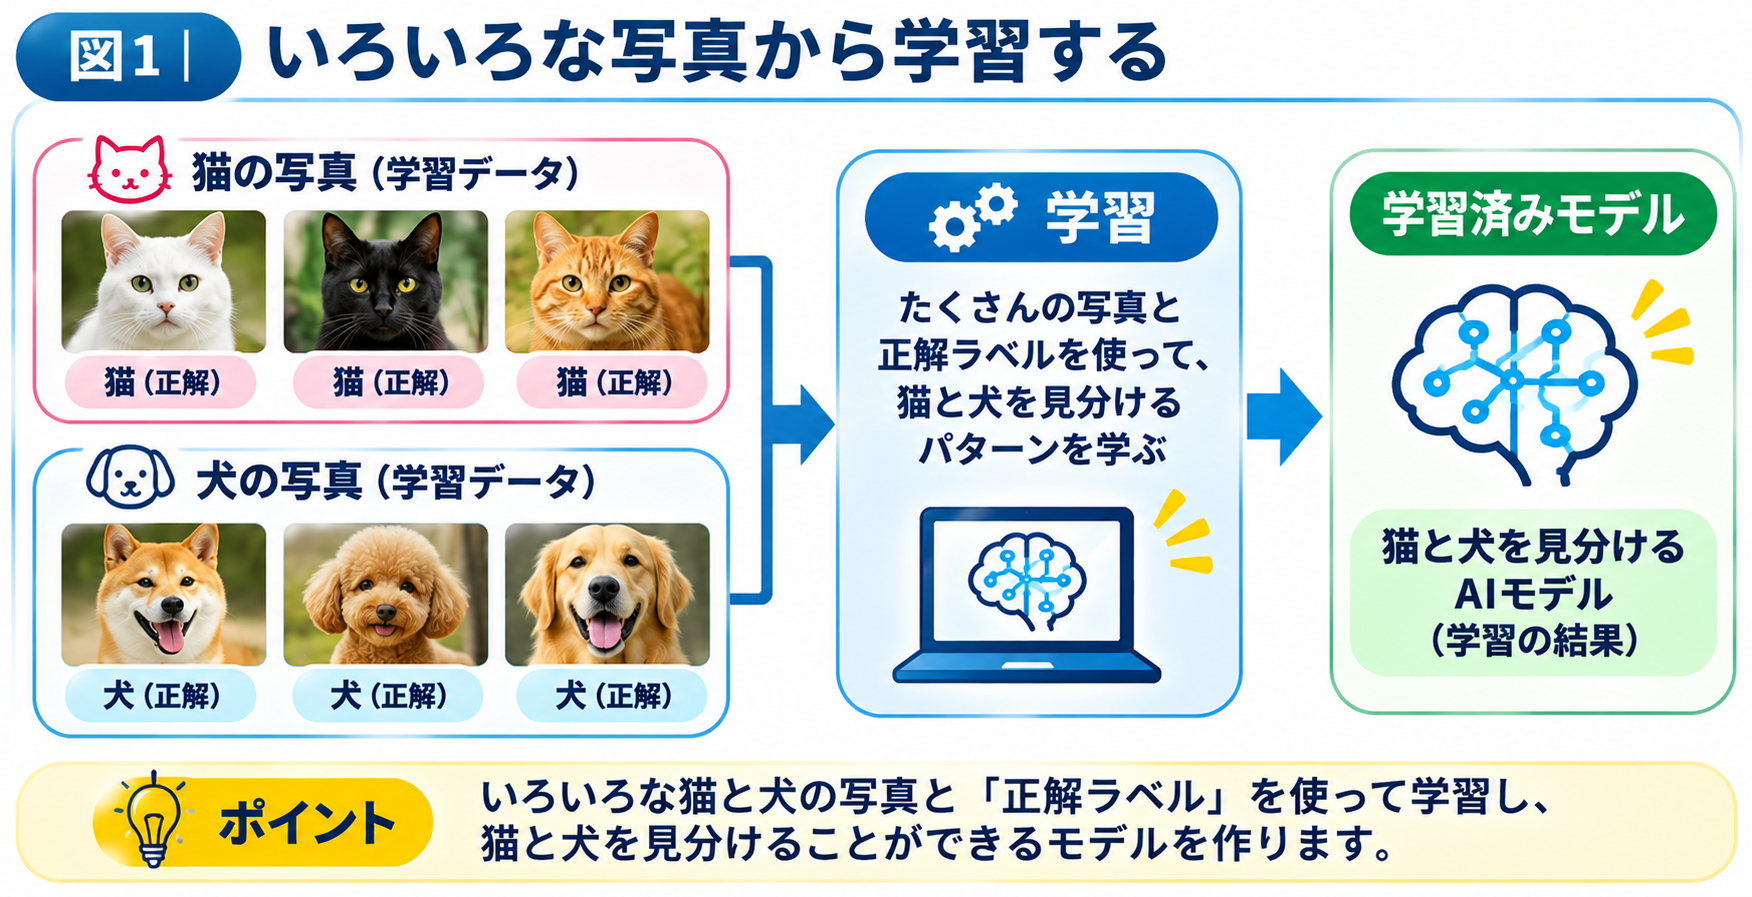
伴菜:「写真をそのまま丸暗記するのが目的ではないの。猫と犬を見分けるのに役立つパターンを、モデルの中の数値に反映させていくのよ」

美月:「モデルの中の数値?」

伴菜:「例えば、写真のどんな情報が判断に役立つか、その情報をどのくらい重視するかに関係する数値ね。こうした学習によって調整される数値を『パラメータ』というの」

美月:「じゃあ、AIが勉強するっていうのは、その数値を変えていくことなの?」

伴菜:「多くの機械学習ではそうよ。学習データを使ってパラメータを調整し、目的に合った予測ができるモデルを作るの」

美月:「なるほど。写真を全部覚えるんじゃなくて、見分けるための仕組みを作っているんだね!」

伴菜:「そういうこと。ただし、学習の仕方が悪いと、写真を覚え込みすぎたような状態になることもあるの。それは後で説明するね」

2. 学習データは、どうやって用意するの?

美月:「じゃあ、猫と犬の写真をたくさん集めれば、すぐに学習できるの?」

伴菜:「写真を集めるだけでは不十分なの。どんなデータを使うかがとても大切よ」

美月:「写真なら何でもいいわけじゃないの?」

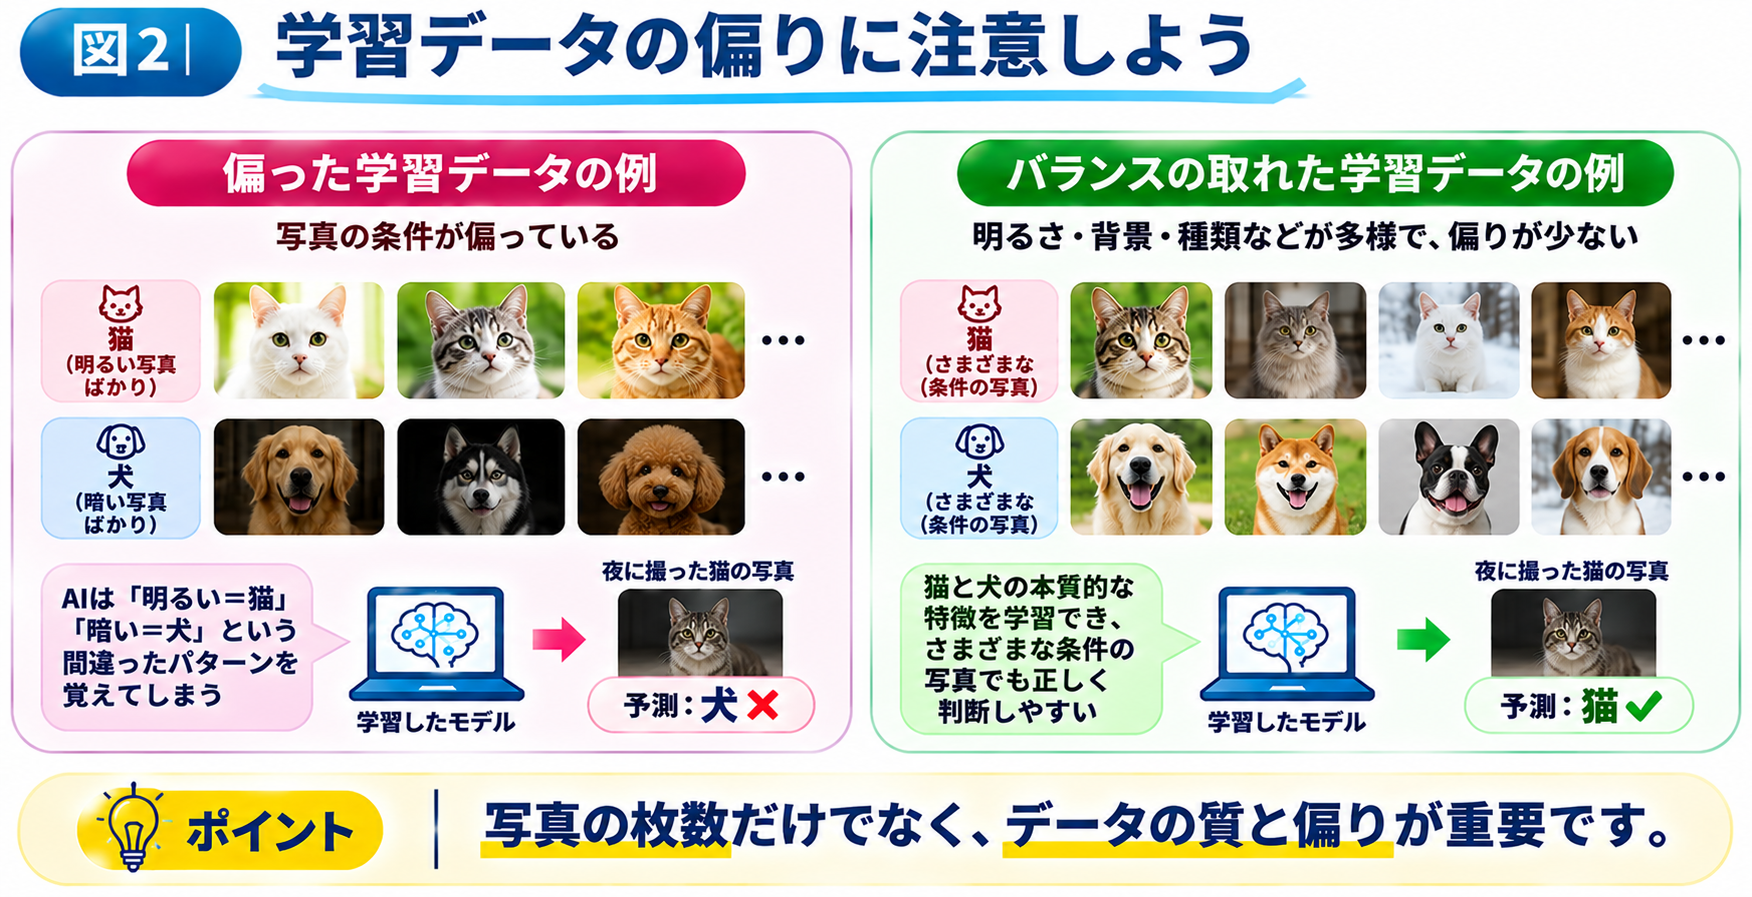
伴菜:「例えば、猫の写真が昼間の明るい場所で撮ったものばかりで、犬の写真が夜の暗い場所で撮ったものばかりだったら、どうなると思う?」

美月:「うーん。明るい写真なら猫、暗い写真なら犬って覚えちゃうかも!」

伴菜:「そうなの。猫と犬の違いではなく、写真の明るさを手がかりにしてしまう可能性があるわ」

美月:「それじゃ、夜に撮った猫を犬と間違えちゃうね」

伴菜:「そうね。だから、猫も犬も、いろいろな色、大きさ、角度、背景、明るさの写真を用意することが大切なの」

美月:「正解の『猫』『犬』も付けるんだよね?」

伴菜:「そのとおり。今回のような教師あり学習では、写真と正解ラベルを組み合わせるの。ラベルが間違っていたら、それも学習に悪い影響を与える可能性があるわ」

美月:「写真の枚数だけじゃなくて、内容と正解の正しさも重要なんだね!」

伴菜:「大正解。データの量だけを増やしても、必ず性能が上がるわけではないのよ」

3. AIはどうやって間違いを直すの?

美月:「データの準備ができたら、いよいよ学習だね!」

伴菜:「そうね。猫の写真をモデルに入力してみましょう」

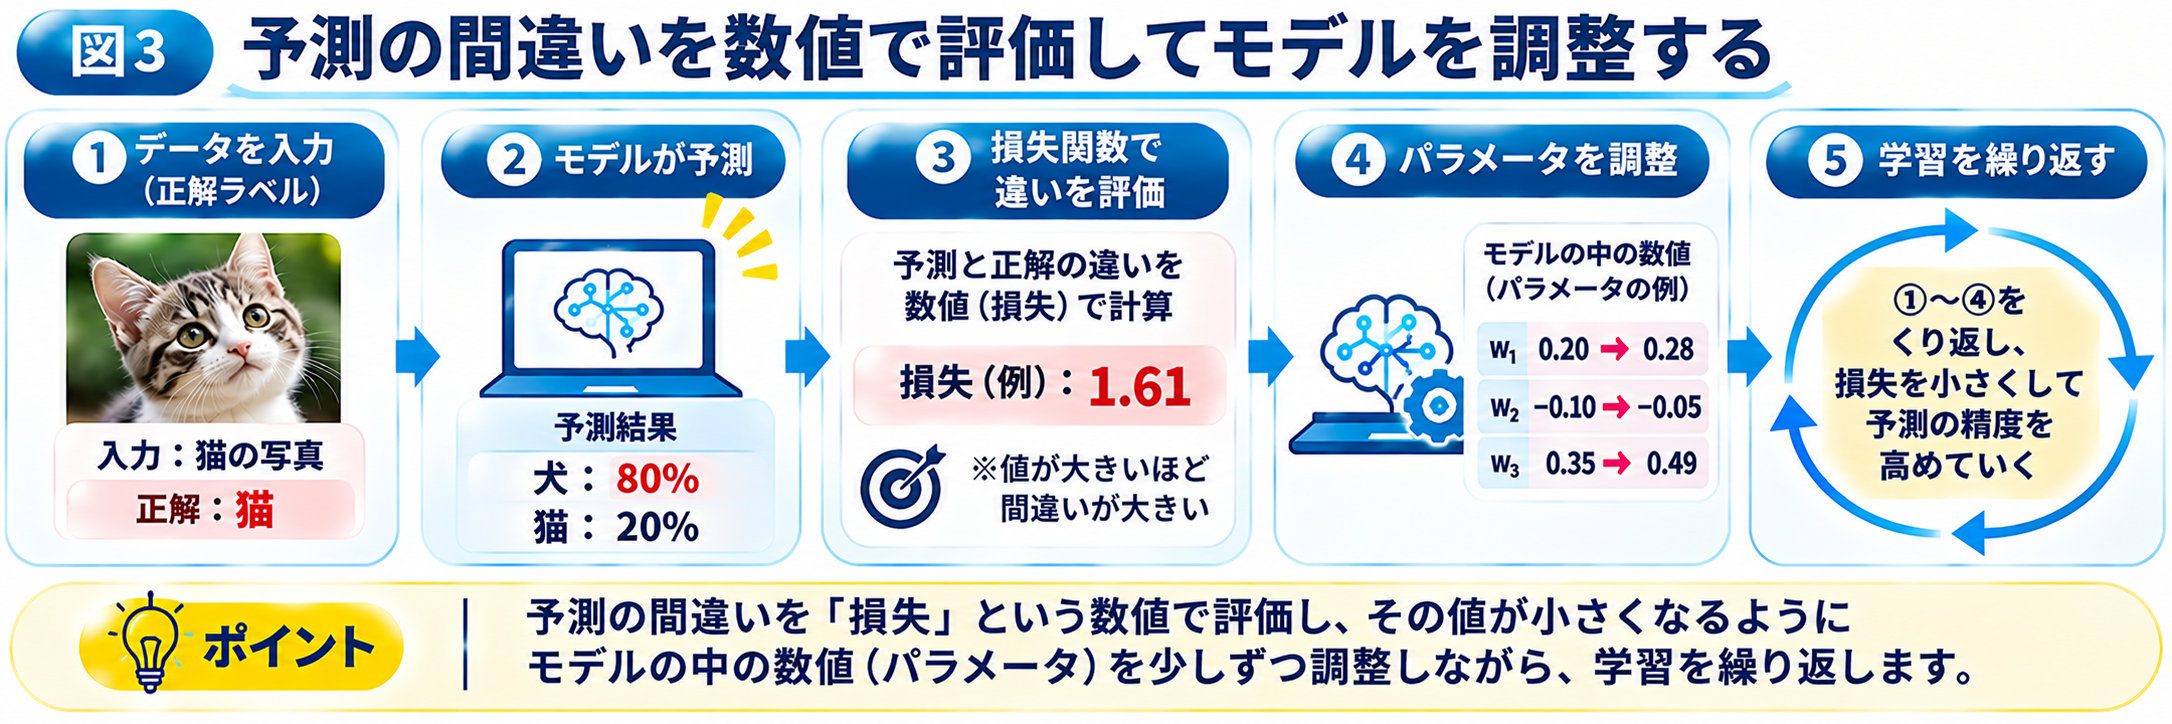
美月:「あれ? 猫なのに、犬の可能性が80%って出てる!」

伴菜:「まだ十分に学習していないモデルなら、そんな予測をすることもあるわ」

美月:「でも、正解は猫だよね。どうやって直すの?」

伴菜:「まず、モデルの予測と正解がどれくらい違うかを数値で表すの。その違いを評価するための計算を『損失関数(Loss Function)』というのよ」

美月:「損失って、何かをなくしちゃったの?」

伴菜:「ここでは、お金や物を失う意味じゃないの。予測がどれくらいうまくいっていないかを表す数値だと思ってね」

美月:「じゃあ、その数値が小さくなればいいんだ!」

伴菜:「基本的にはそう。そこで、損失が小さくなる方向にパラメータを調整するの」

美月:「どの数値を変えればいいか、どうやって分かるの?」

伴菜:「代表的な方法が『勾配降下法(Gradient Descent)』よ。損失が小さくなる方向を計算して、パラメータを少しずつ動かしていくの」

美月:「難しそう……」

伴菜:「山を下りるところを想像してみて。今いる場所から、下り坂の方向を調べて少し進む。それを繰り返すイメージよ」

美月:「ああ! いきなり正解の場所に飛ぶんじゃなくて、少しずつ良くしていくんだ!」

伴菜:「そういうこと。ただし、必ず一番良い答えにたどり着けるわけではないし、進む幅の決め方も重要なのよ」

※「犬80%」は説明用の架空の予測値です。実際の学習方法や損失関数はモデルによって異なります。

4. 学習を繰り返せば、必ず賢くなるの?

美月:「じゃあ、何回も学習を繰り返せば、どんどん正確になるんだね!」

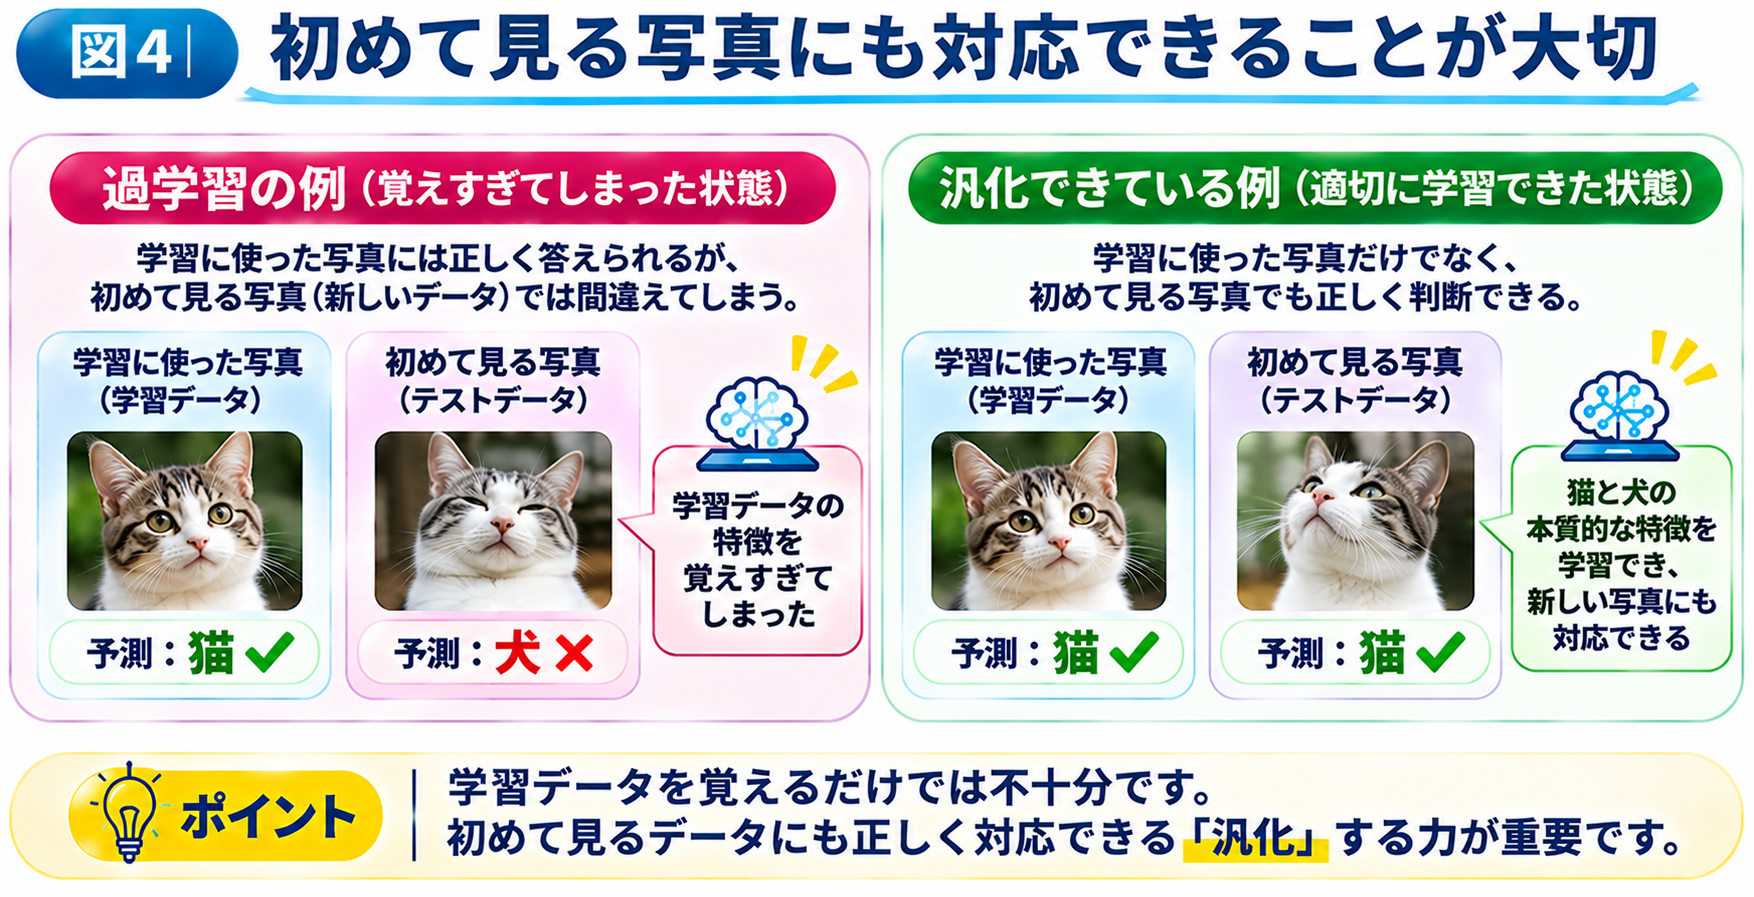
伴菜:「必ずしもそうとは限らないの。ここで『過学習(Overfitting)』という問題が出てくるわ」

美月:「過学習? 勉強しすぎってこと?」

伴菜:「そういうイメージね。例えば、美月が問題集の答えを全部覚えたとするでしょう?」

美月:「同じ問題なら満点だよ!」

伴菜:「でも、数字や文章を少し変えた問題が出たら?」

美月:「解き方を理解していなかったら、間違えるかも……」

伴菜:「AIも似ているの。学習に使った写真には非常によく対応できても、新しい写真では間違いが多いことがあるのよ」

美月:「それが過学習なんだ!」

伴菜:「そう。だから、学習に使ったデータでの成績だけを見て、成功したとは判断できないの」

美月:「じゃあ、初めて見る写真でもテストする必要があるんだね」

伴菜:「そのとおり。大切なのは、学習したデータ以外にも対応できること。この性質を『汎化(Generalization)』というのよ」

5. 学習用・検証用・テスト用って何が違うの?

美月:「ハンナ、初めて見る写真で試すのは分かったけど、いつ試せばいいの?」

伴菜:「いい質問ね。機械学習では、データを目的別に分けて使うことが多いの」

美月:「どう分けるの?」

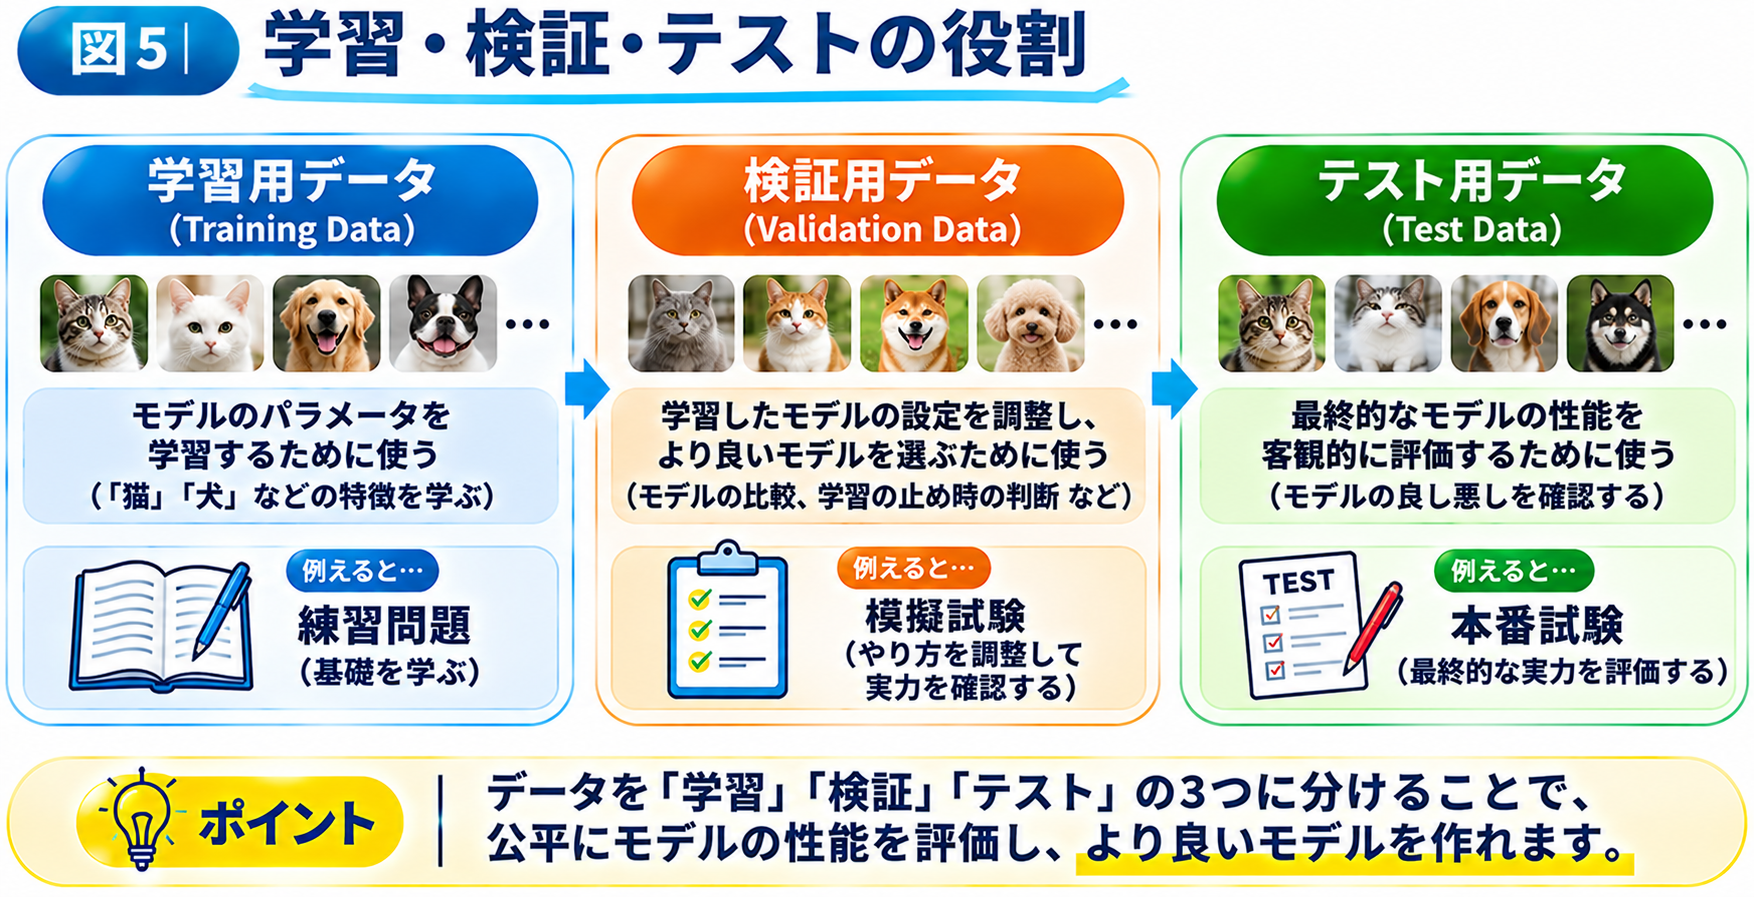
伴菜:「代表的なのが『学習用』『検証用』『テスト用』の3つよ」

美月:「全部テストみたいな名前だね(笑)」

伴菜:「まず、学習用データはモデルのパラメータを学習するために使うの」

美月:「これはいつもの練習問題だね!」

伴菜:「そう。次に検証用データは、学習方法やモデルの設定を選ぶときに使うの」

美月:「模擬試験みたいなもの?」

伴菜:「近いわね。例えば、どのモデルを採用するか、どの時点で学習を止めるかを判断する材料にするの」

美月:「じゃあ、テスト用は本番の試験?」

伴菜:「そう考えると分かりやすいわ。モデルの選択や調整が終わったあとに、最終的な性能を確認するためのデータなの」

美月:「テストの問題を先に見ながら練習したら、ずるいもんね!」

伴菜:「そのとおり。テスト用データの結果を何度も見てモデルを調整すると、公平な評価ができなくなる可能性があるのよ」

※3分割は代表的な方法です。データが少ない場合などには交差検証など別の評価方法も使われます。また、データの分け方では同じ対象からの類似画像が別グループに混ざることなどにも注意が必要です。

6. 正答率が高ければ、良いAIなの?

美月:「よし! テスト用の写真でも正しく判定できたら、AIの完成だね!」

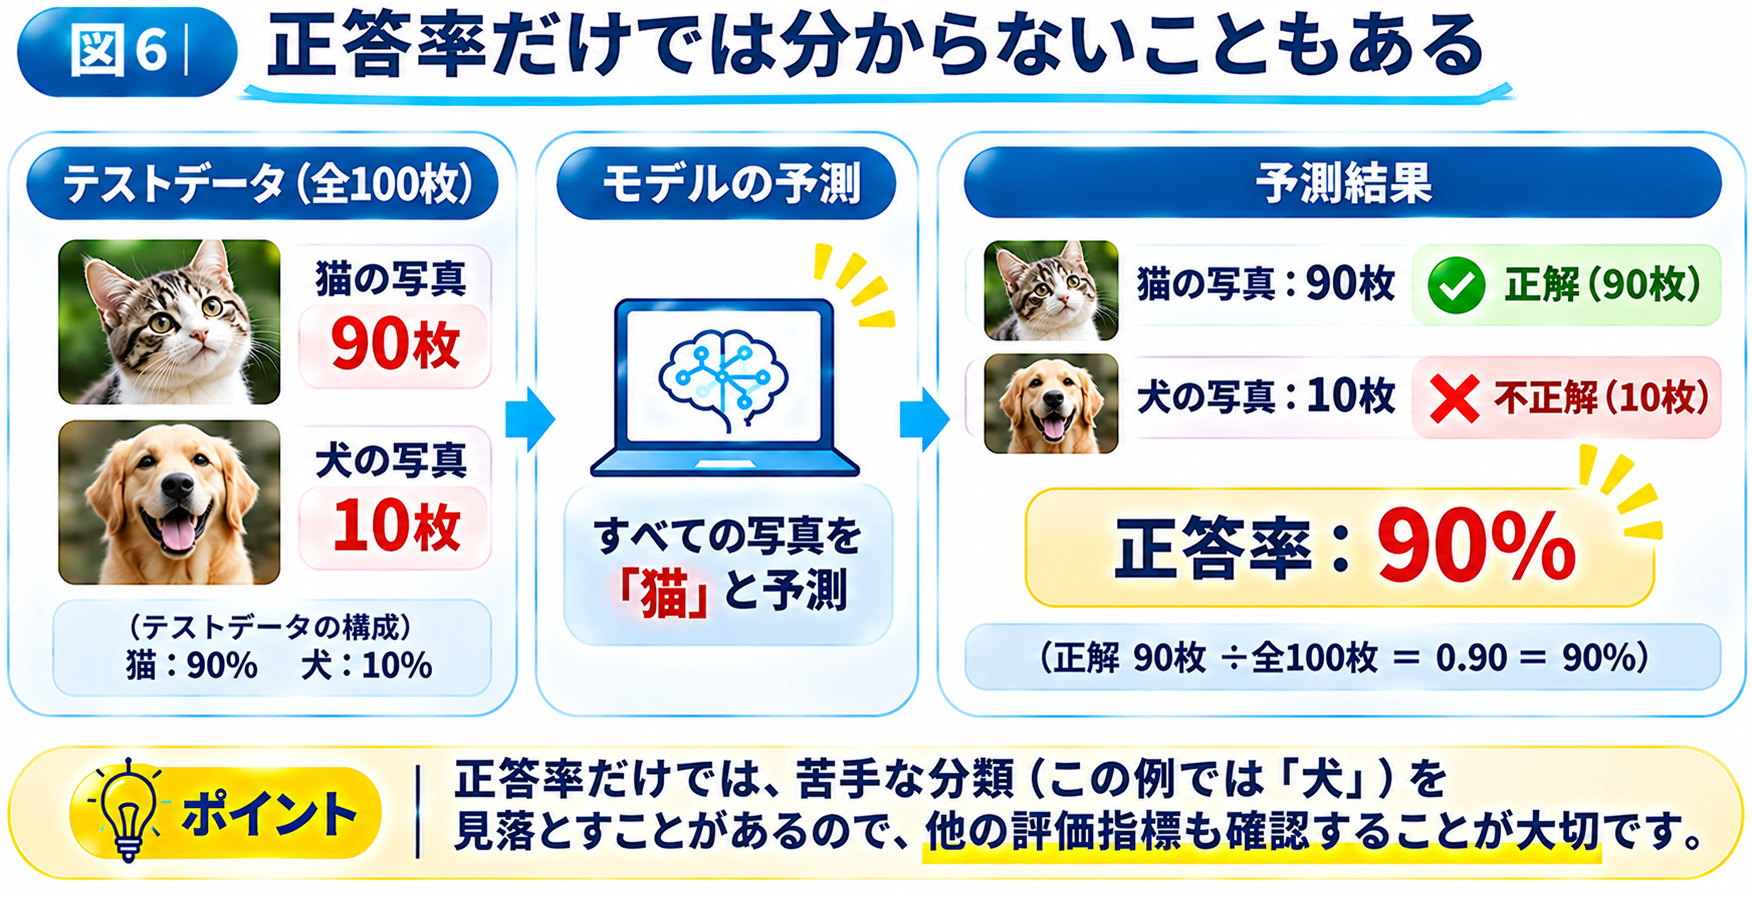
伴菜:「性能を数字で確認することも大切よ。例えば、100枚の写真のうち90枚を正しく分類できたら、正答率は90%ね」

美月:「90%なら、かなり良さそう!」

伴菜:「そうね。でも、数字だけでは分からないこともあるの」

美月:「えっ、90%なのに?」

伴菜:「例えば、100枚のうち90枚が猫で、10枚が犬だったとするでしょう。全部『猫』と答えるだけでも、正答率は90%になってしまうの」

美月:「あっ! 犬は一匹も当てられていないのに!」

伴菜:「そう。だから、正答率だけでなく、猫と犬をそれぞれどのくらい正しく見分けられたかも確認する必要があるの」

美月:「なるほど。数字が高いからって、すぐに良いモデルだとは言えないんだね」

伴菜:「そのとおり。何を正しく判断したいのかによって、適切な評価方法も変わるのよ」

7. 今日のまとめ

伴菜:「さて、美月。今日はAIの学習をかなり詳しく見てきたけど、どうだった?」

美月:「最初は、猫と犬の写真をたくさん見せればいいと思ってたけど、それだけじゃないんだね」

伴菜:「どんなことが大切だった?」

美月:「まず、偏りの少ない学習データを用意すること。次に、予測と正解を比べて、モデルの数値を調整すること!」

伴菜:「うんうん。それから?」

美月:「学習した写真だけを覚えてもダメ。初めて見る写真で正しく判断できるか確かめる!」

伴菜:「大正解。じゃあ、正答率が90%だったら?」

美月:「すぐに安心しちゃダメ! 猫と犬のどちらもちゃんと見分けられているか確認する!」

伴菜:「完璧ね」

美月:「なんだか、AIを作る人って、先生みたいだね。教材を準備して、教えて、テストして……」

伴菜:「そうね。でも、AIは人間の生徒とは違うから、何を学んだのか、どんな間違いをするのかを数字でも確かめる必要があるのよ」

美月:「よーし! 私もAIに負けないように勉強する!」

伴菜:「その意気よ。でも、まずは今日の復習クイズからね!」

もっと知りたい! AI用語集

美月:「ハンナ、今日は知らない言葉がいっぱい出てきたね!」

伴菜:「難しい言葉は、AI用語集で一つずつ確認してみてね」

今回の関連用語:

  • 機械学習(Machine Learning)
  • 学習データ(Training Data)
  • 教師あり学習(Supervised Learning)
  • モデル(Model)
  • パラメータ(Parameter)
  • 損失関数(Loss Function)
  • 勾配降下法(Gradient Descent)
  • 過学習(Overfitting)
  • 汎化(Generalization)

→ 伴菜と美月のAI用語集を見る

理解度チェック(30 Minutes AI 第2話)

伴菜と美月のAI教室へようこそ!

30 Minutes AI 第2話「AIはどうやって勉強するの?」の理解度チェックです。

全5問のクイズで、学習データ、モデルの調整、過学習、データの分割、性能評価について振り返ってみましょう。

伴菜と美月のAI教室へようこそ!

30 Mins AI 第2話「AIはどうやって勉強するの?」の理解度チェックです。

全5問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. AIの学習で「モデルのパラメータを調整する」とは、どういう意味でしょう?

Q2. 猫の写真は明るい場所、犬の写真は暗い場所で撮影されたものばかりでした。この学習データには、どのような問題があるでしょう?

Q3. 学習中のモデルが猫の写真を「犬80%」と予測しました。損失関数とパラメータ調整の役割として、最も適切なのはどれでしょう?

Q4. 学習用・検証用・テスト用データの役割として、最も適切なのはどれでしょう?

Q5. 猫90枚、犬10枚のテストデータ100枚に対し、モデルがすべて「猫」と予測しました。この結果をどう評価するのが適切でしょう?


基本から復習したい人へ

ここまでで、AIが学習データからどのように学ぶのか、予測の間違いを減らす仕組み、過学習、そして学習結果の評価方法まで詳しく学んだよ。

「ちょっと難しかったな」「もう一度、学習の基本的な流れを整理したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!

← 3 Minutes AI 第2話へ


次回予告

第3話|教師あり学習と教師なし学習って何が違うの?

美月:「ハンナ、今日の猫と犬の写真には、全部正解が付いていたよね?」

伴菜:「そうね。でも、AIには正解を教えずにデータの特徴を見つける学習方法もあるのよ」

美月:「えっ! 正解がなくても勉強できるの?」

伴菜:「次回は、その違いを詳しく見てみましょう!」

カテゴリー
2026年 3 Minutes AI AI コンピューター 伴菜と美月のAI教室

3 mins AI 第2話|AIはどうやって勉強するの?

伴菜と美月のAI教室 — 3 Minutes AI

1. AIも勉強するの?

休日の午後。伴菜と美月は、いつものダイニングテーブルでノートパソコンを開いていた。

美月:「ねえ、ハンナ。前回、AIはデータから学習するって言ってたよね?」

伴菜:「うん。今日は、その学習の仕組みを見てみようか」

美月:「AIって、私たちみたいに教科書を読んで勉強するの?」

伴菜:「ちょっと違うかな。例えば、猫と犬の写真を見分けるAIを作るとするね」

美月:「それなら簡単! 猫の写真を見せて、『これは猫です!』って教えればいいんでしょ?」

伴菜:「そういう教え方もあるよ。でも、写真を1枚見せただけでは、いろいろな猫を見分けられるとは限らないの」

美月:「えっ、どうして?」

伴菜:「猫にもいろいろいるでしょう? 白い猫、黒い猫、耳が折れた猫。犬にも小さい犬や大きい犬がいるよね」

美月:「そっか。いろんな写真で練習しないといけないんだ!」

伴菜:「そう。たくさんの写真を使って、猫と犬を見分けるのに役立つパターンを学んでいくのよ」

2. 間違えたらどうするの?

美月:「でもさ、最初から猫と犬を正しく見分けられるわけじゃないよね?」

伴菜:「もちろん。学習を始めたばかりのモデルは、間違えることもあるよ」

美月:「じゃあ、猫の写真なのに『犬!』って答えちゃうの?」

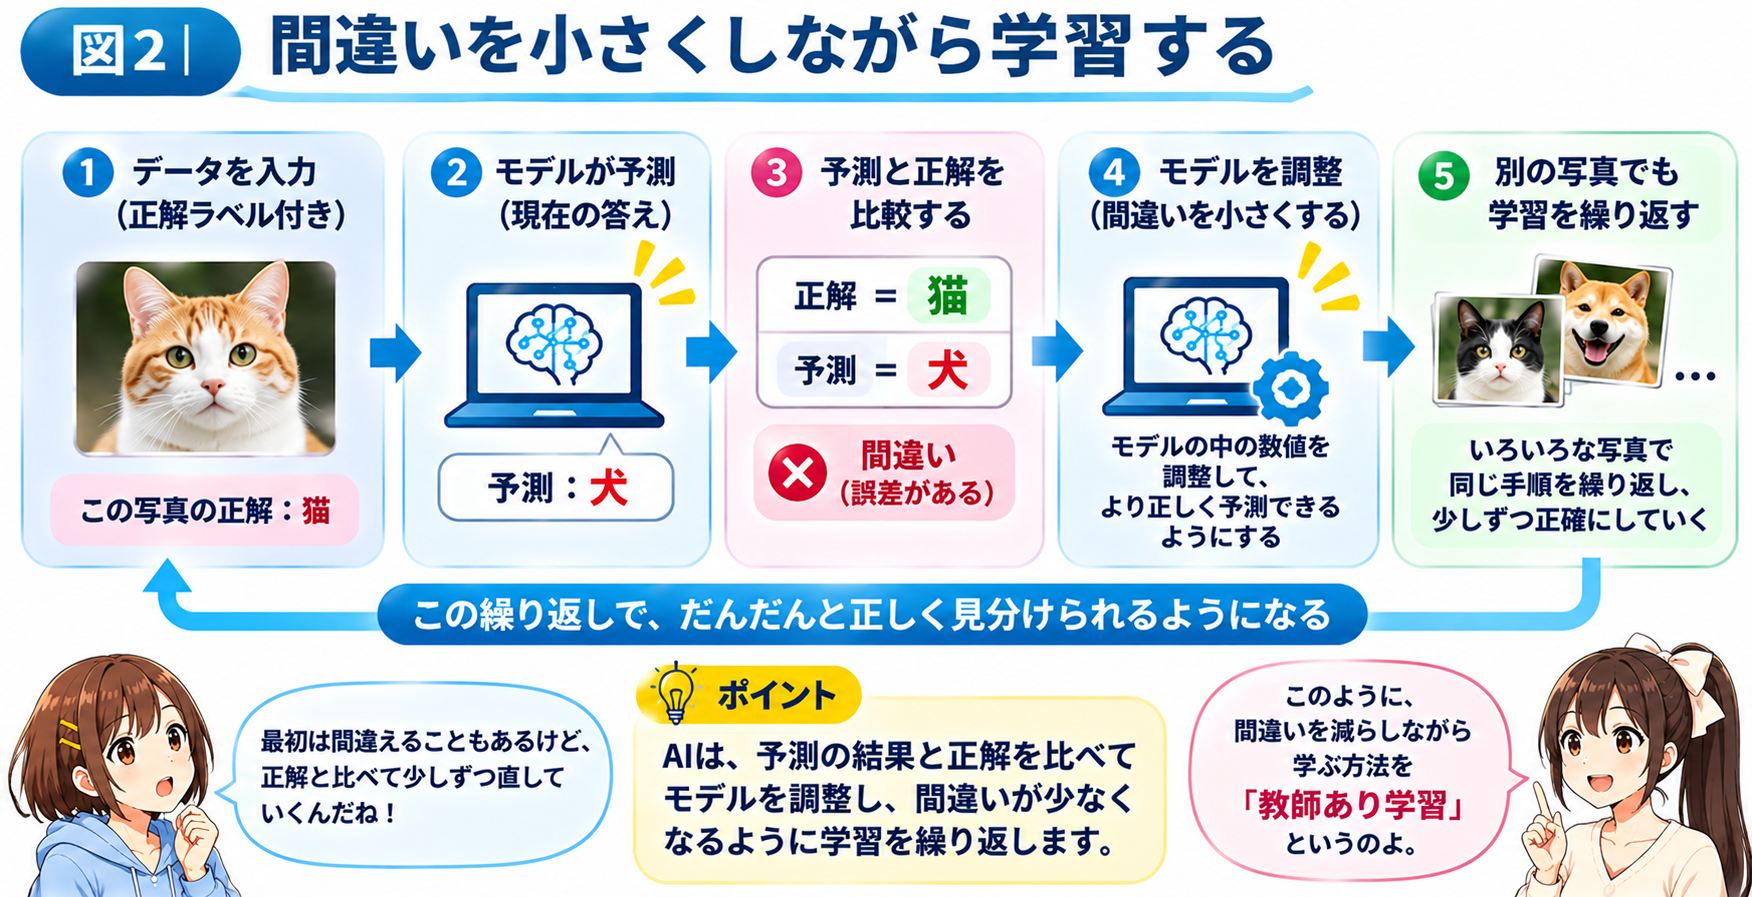
伴菜:「そういうこともあるね。そこで、モデルの予測と正解を比べて、間違いが小さくなるようにモデルの中の数値を調整するの」

美月:「数値を調整する?」

伴菜:「例えば、写真のどんな情報をどのくらい重視するかに関係する数値だよ。学習では、その数値を少しずつ変えていくの」

美月:「なるほど! 間違えたところを直しながら、練習を繰り返す感じなんだね!」

伴菜:「そういうイメージでいいよ。このように、正解を付けたデータを使って学習する方法を『教師あり学習』というの」

※これは教師あり学習の代表的な流れを簡略化したものです。実際の学習では、予測と正解の違いを数値で評価し、モデルを調整します。

3. 初めて見る猫も分かるの?

美月:「じゃあ、たくさん練習したら、もう猫と犬を間違えなくなる?」

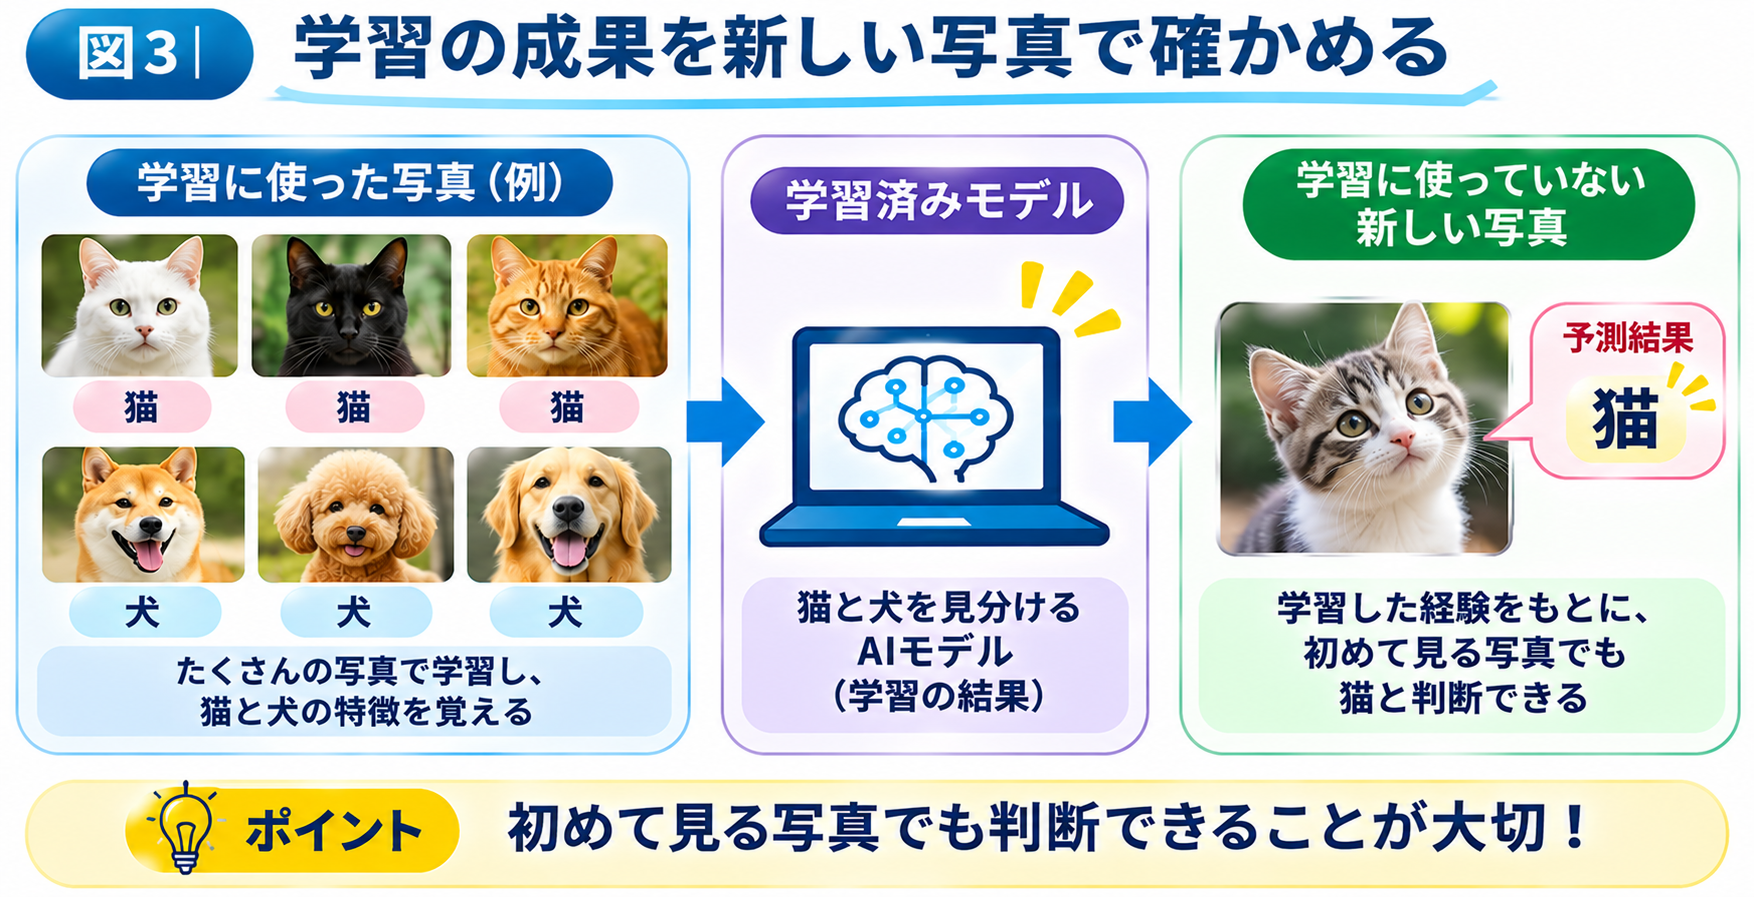
伴菜:「そうとは限らないよ。ここで大切なのが、学習に使っていない写真でも正しく判断できるかどうかなの」

美月:「どういうこと?」

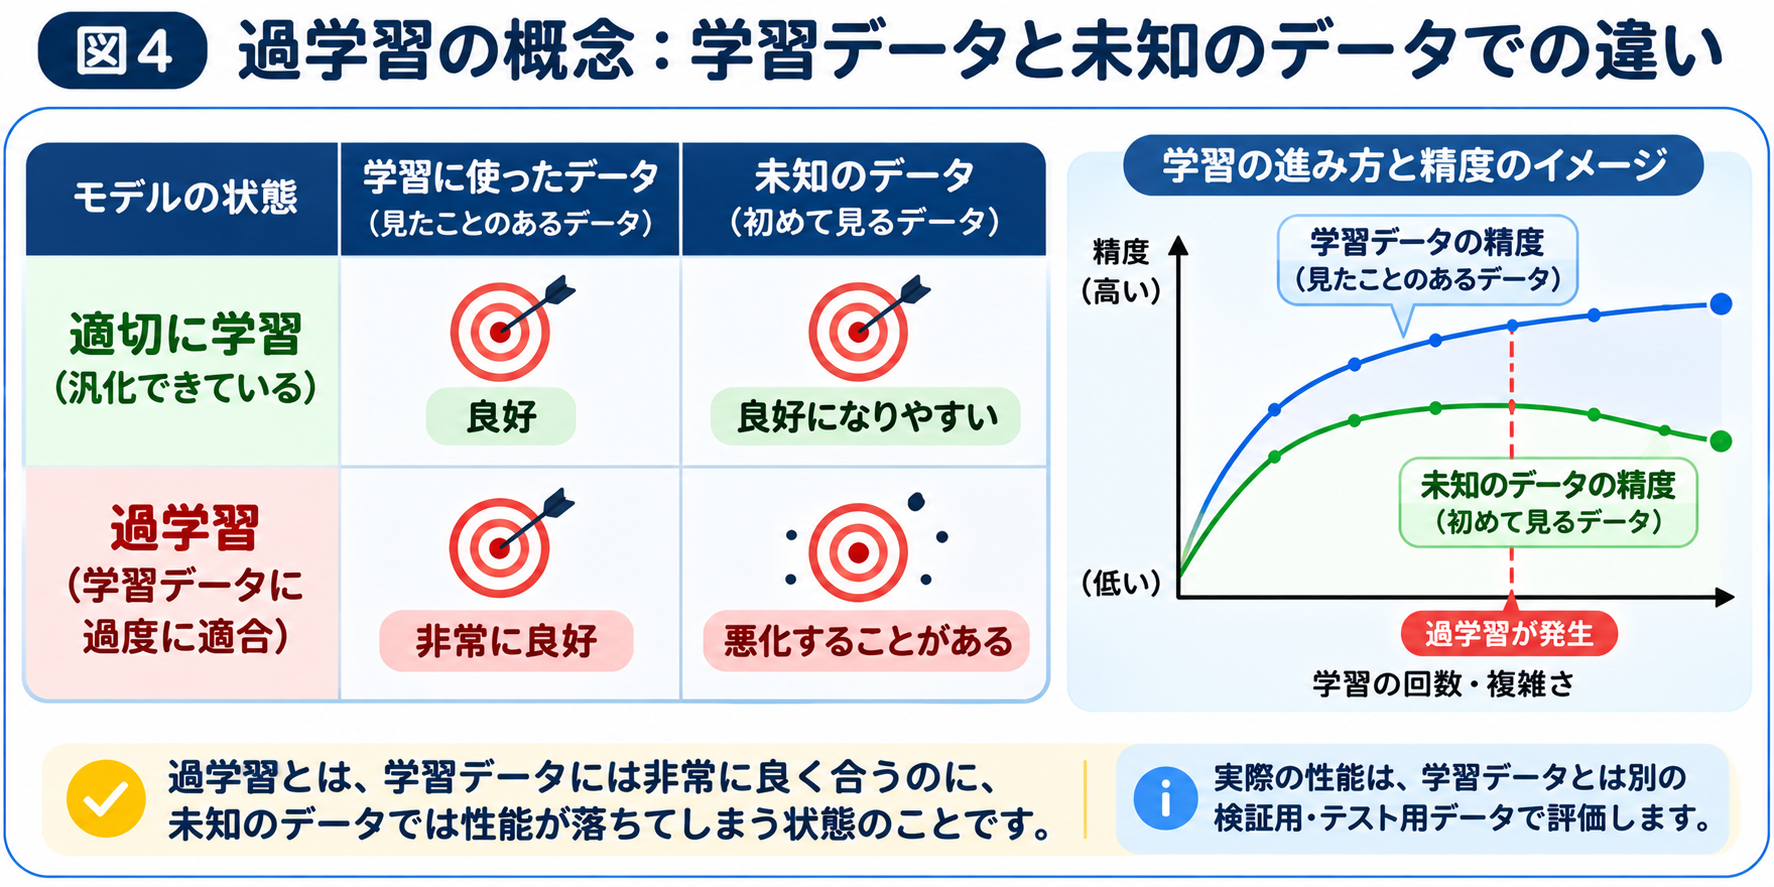
伴菜:「例えば、美月がテストの問題と答えを全部丸暗記したら、同じ問題には正解できるよね?」

美月:「うん! でも、違う問題が出たら困るかも……」

伴菜:「AIも同じなの。練習した写真だけを覚えても、初めて見る写真を見分けられなければ困るでしょう?」

美月:「そっか! 覚えた写真だけじゃなくて、新しい写真でも試す必要があるんだ!」

伴菜:「そのとおり。学習に使っていないデータで、どのくらい正しく予測できるかを確認することが大切なのよ」

4. 今日のまとめ

伴菜:「じゃあ、美月。今日の復習をしてみようか」

美月:「任せて!」

伴菜:「AIは、どうやって猫と犬を見分けられるようになるの?」

美月:「いろんな写真を使って学習する!」

伴菜:「予測が間違っていたら?」

美月:「正解と比べて、モデルを調整する!」

伴菜:「じゃあ、学習した写真を全部正しく答えられれば、それで完成?」

美月:「違う! 初めて見る写真でも正しく判断できるか確かめる!」

伴菜:「大正解!」

美月:「ふふん。これで私も猫と犬を見分けるAIを作れるかな?」

伴菜:「仕組みは分かってきたね。でも、実際に作るにはもう少し勉強が必要かな」

美月:「えー! まだ勉強するの?」

伴菜:「AIだけじゃなくて、美月もね!」

もっと知りたい! AI用語集

美月:「ハンナ、今日も新しい言葉が出てきたね!」

伴菜:「分からない言葉があったら、AI用語集で確認してみてね」

今回の関連用語

  • 機械学習(Machine Learning)
  • 学習データ(Training Data)
  • 教師あり学習(Supervised Learning)
  • 正解ラベル(Label)
  • モデル(Model)
  • 学習(Training)

→ 伴菜と美月のAI用語集を見る

理解度チェック(3 Minutes AI 第2話)

伴菜と美月のAI教室へようこそ!

3 Mins AI 第2話「AIはどうやって勉強するの?」の理解度チェックです。

全3問のクイズで、今回学んだ内容を振り返ってみましょう。回答後には、正解と詳しい解説を確認できます。

伴菜と美月のAI教室へようこそ!

3 Mins AI 第2話「AIはどうやって勉強するの?」の理解度チェックです。

全3問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. 猫と犬の写真を使ってAIに学習させるとき、写真に「猫」「犬」という正解ラベルを付けるのはなぜ?

Q2. 学習中のAIが、猫の写真を「犬」と間違えて予測した場合、どうするの?

Q3. AIが学習に使った猫と犬の写真をすべて正しく判定できたら、それで十分?


もっと詳しく学びたい人へ

ここまでで、AIがデータを使って学習する流れや、正解と予測を比較してモデルを調整する仕組みを学んだよ。

30 Minutes AI 第2話では、学習データの準備、モデルの調整、学習結果の評価などを、さらに詳しく説明するよ。

→ 30 Minutes AI 第2話へ


次回予告

第3話「教師あり学習と教師なし学習って何が違うの?」

正解を教えて学習させる方法と、正解を教えずにデータの特徴を見つける方法。

AIには、いろいろな勉強の仕方があるんだ!

カテゴリー
2026年 30 Minutes AI AI コンピューター 伴菜と美月のAI教室

30 mins AI 第1話|AIって、そもそも何?

伴菜と美月のAI教室 ー 30 Minutes AI

3 Minutes AI 第1話の発展編|伴菜と美月が、AIの仕組みをもう一歩深く探っていきます。

1. 電卓はなぜAIじゃないの?

休日の午後。伴菜と美月は、ダイニングテーブルでお茶を飲んでいた。

美月:「ねえ、ハンナ。3分版で電卓は普通AIとは呼ばないって言ってたよね?」

伴菜:「うん。覚えてるよ」

美月:「でもさ、電卓って私より計算が速いじゃん。人間より賢いところがあるのに、なんでAIじゃないの?」

伴菜:「じゃあ美月、電卓に『明日は傘を持っていったほうがいい?』って聞いたら?」

美月:「何も答えてくれないよ。天気なんて分からないもん」

伴菜:「そうだね。電卓は、決められた計算を正確に実行するように作られているの。AIは一般に、認識、予測、推論、言語の理解や生成みたいな、人間の知的活動と結びつけられる処理をコンピューターで実現する技術の総称なんだ」

美月:「つまり、計算が速いかどうかじゃなくて、何をする仕組みなのかが大切なんだ」

伴菜:「そう。ただし、ここは注意ね。AIと普通のプログラムの間に、誰もが同意する一本の境界線があるわけじゃないの」

美月:「えっ、そうなの? AIって、もっとはっきり決まってるのかと思った」

伴菜:「例えば、チェスを指すプログラム。昔から、人間が考えた探索方法や評価ルールを使って、次の手を選ぶものがあるでしょう?」

美月:「うん。何手も先を読んで、良さそうな手を選ぶんだよね」

伴菜:「そういう探索や推論もAI研究の大切な分野なんだ。だから、AIを『データから自動的に学習するプログラム』だけだと思うと、範囲を狭く捉えすぎちゃう」

美月:「なるほど。学習しなくてもAIと呼ばれるものがあるんだね」

伴菜:「その通り。まずそこが、今日の大切なポイントだよ」

2. ルールを使うAIって何?

美月:「じゃあさ、普通のプログラムとAIの違いを、もう少し具体的に知りたいな」

伴菜:「それなら、迷惑メールの話を続けようか」

美月:「また『当選しました!』ってメール?」

伴菜:「そう。美月が迷惑メールを判定するプログラムを作るなら、どうする?」

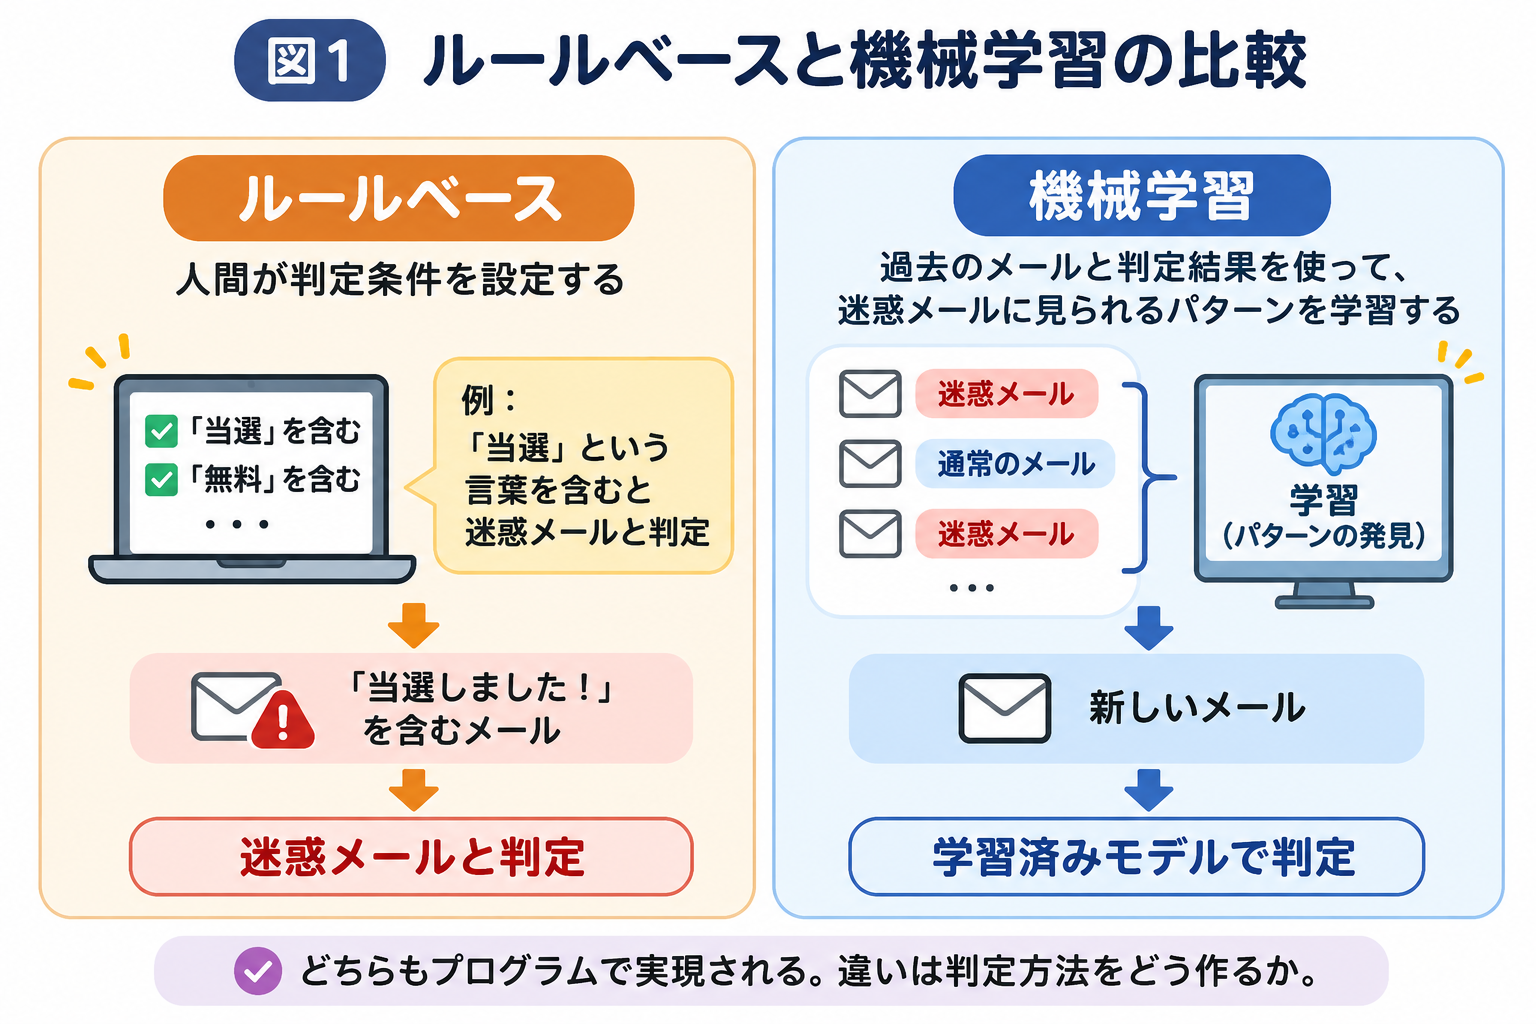
美月:「『当選しました』とか『今すぐクリック』とか、怪しい言葉が入っていたら迷惑メールにする!」

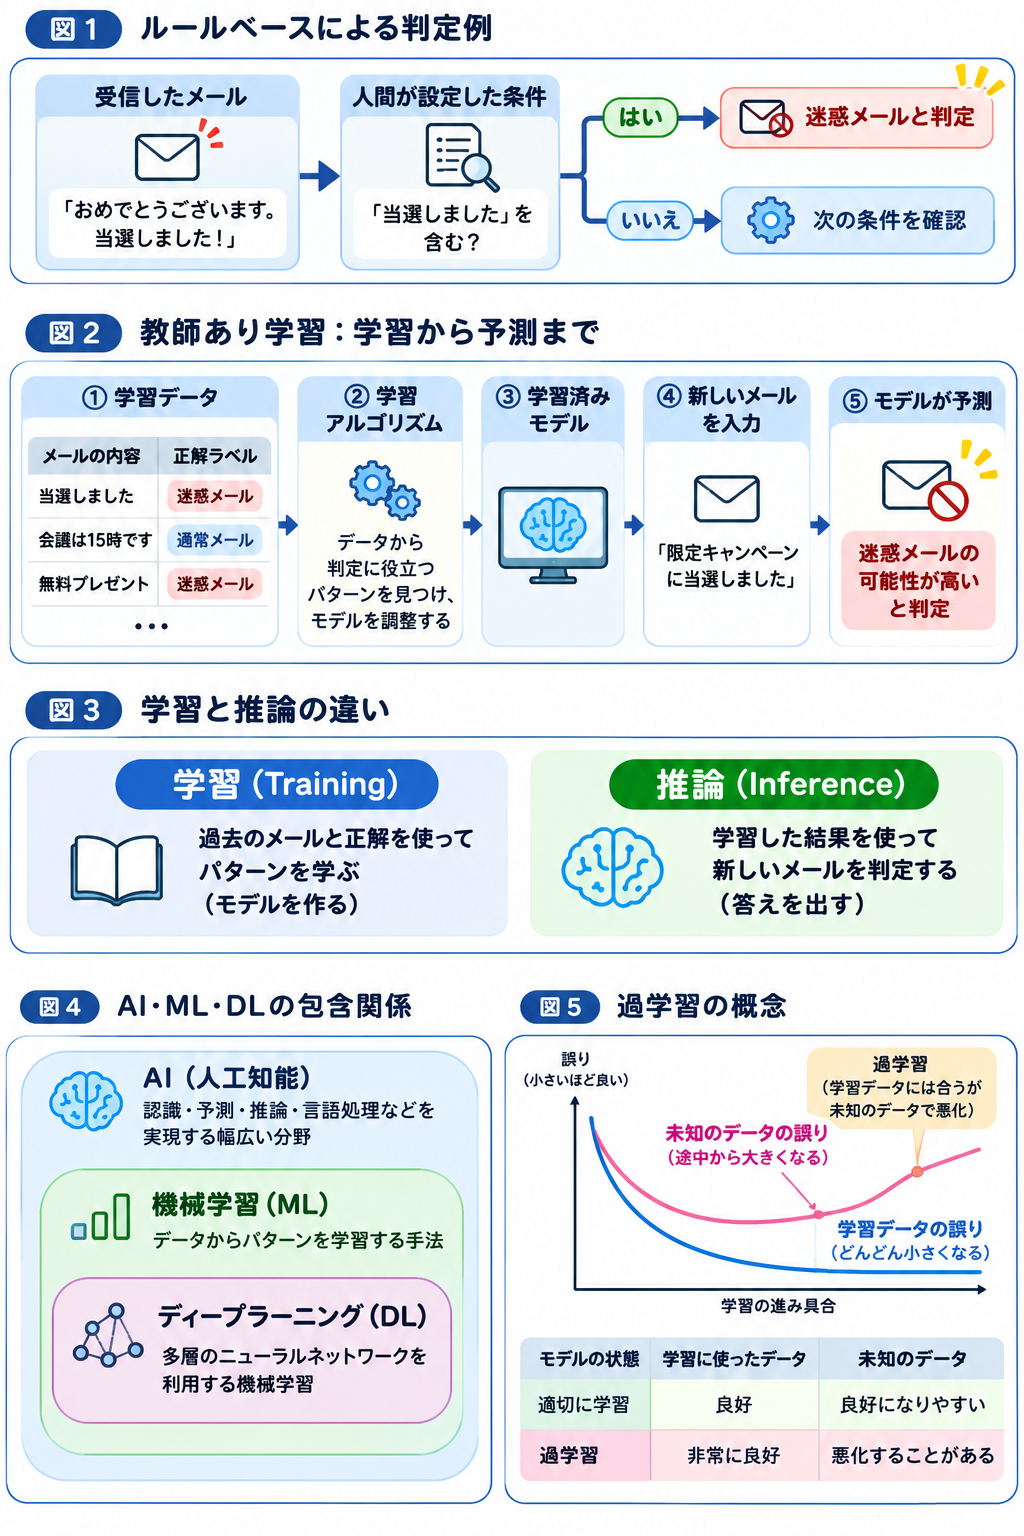
伴菜:「それはルールベースの方法だね。人間が判断条件をあらかじめ決めておくの」

美月:「でも、本当に懸賞に当選したメールも迷惑メールになっちゃうよね?」

伴菜:「そう。じゃあ、送信元のアドレスも確認するルールを追加したら?」

美月:「それなら少し良くなりそう。でも、送信元を偽装されたら困るなあ」

伴菜:「じゃあ、リンク先のURLも調べようか」

美月:「待って。どんどんルールが増えていくんだけど!」

伴菜:「そうなの。ルールベースの方法は、条件が明確であれば動作を説明しやすい。でも、複雑な状況に対応しようとすると、ルールの作成や管理が大変になることがあるんだ」

美月:「ルールが増えすぎて、人間が管理しきれなくなるわけね」

伴菜:「そこで、昔から研究されてきたAIの一つが、エキスパートシステムなの」

美月:「エキスパートって、専門家?」

伴菜:「そう。専門家が持っている知識をルールなどの形で登録して、その知識を使って推論するシステムだよ」

美月:「例えば?」

伴菜:「機械の故障診断を考えてみよう。『電源が入らない』『警告ランプが点滅している』といった症状から、考えられる故障原因を絞り込むの」

美月:「お医者さんの問診みたい」

伴菜:「似ているね。ただ、専門家の知識を全部ルールにするのは難しいし、例外への対応も課題になるんだ」

美月:「なるほど。じゃあ、単にIF文を書いたら何でもAI、というわけでもないんだね」

伴菜:「その通り。ルールを使っていることだけじゃなく、知識の表現や推論など、どんな知的処理を実現しているかが重要なの」

3. 機械学習は、何を学習しているの?

美月:「それで、ルールを人間が全部書かなくてもよくする方法が機械学習なんだよね?」

伴菜:「うん。ただし、人間の仕事がなくなるわけじゃないよ。何を予測したいか決めたり、データを準備したり、結果を評価したりする必要があるからね」

美月:「なるほど。じゃあ迷惑メールの場合、何を学習するの?」

伴菜:「過去のメールと、そのメールが迷惑メールだったかどうかの情報を使って、判定に役立つパターンを学習するんだ」

美月:「その『迷惑メールだったかどうか』も必要なの?」

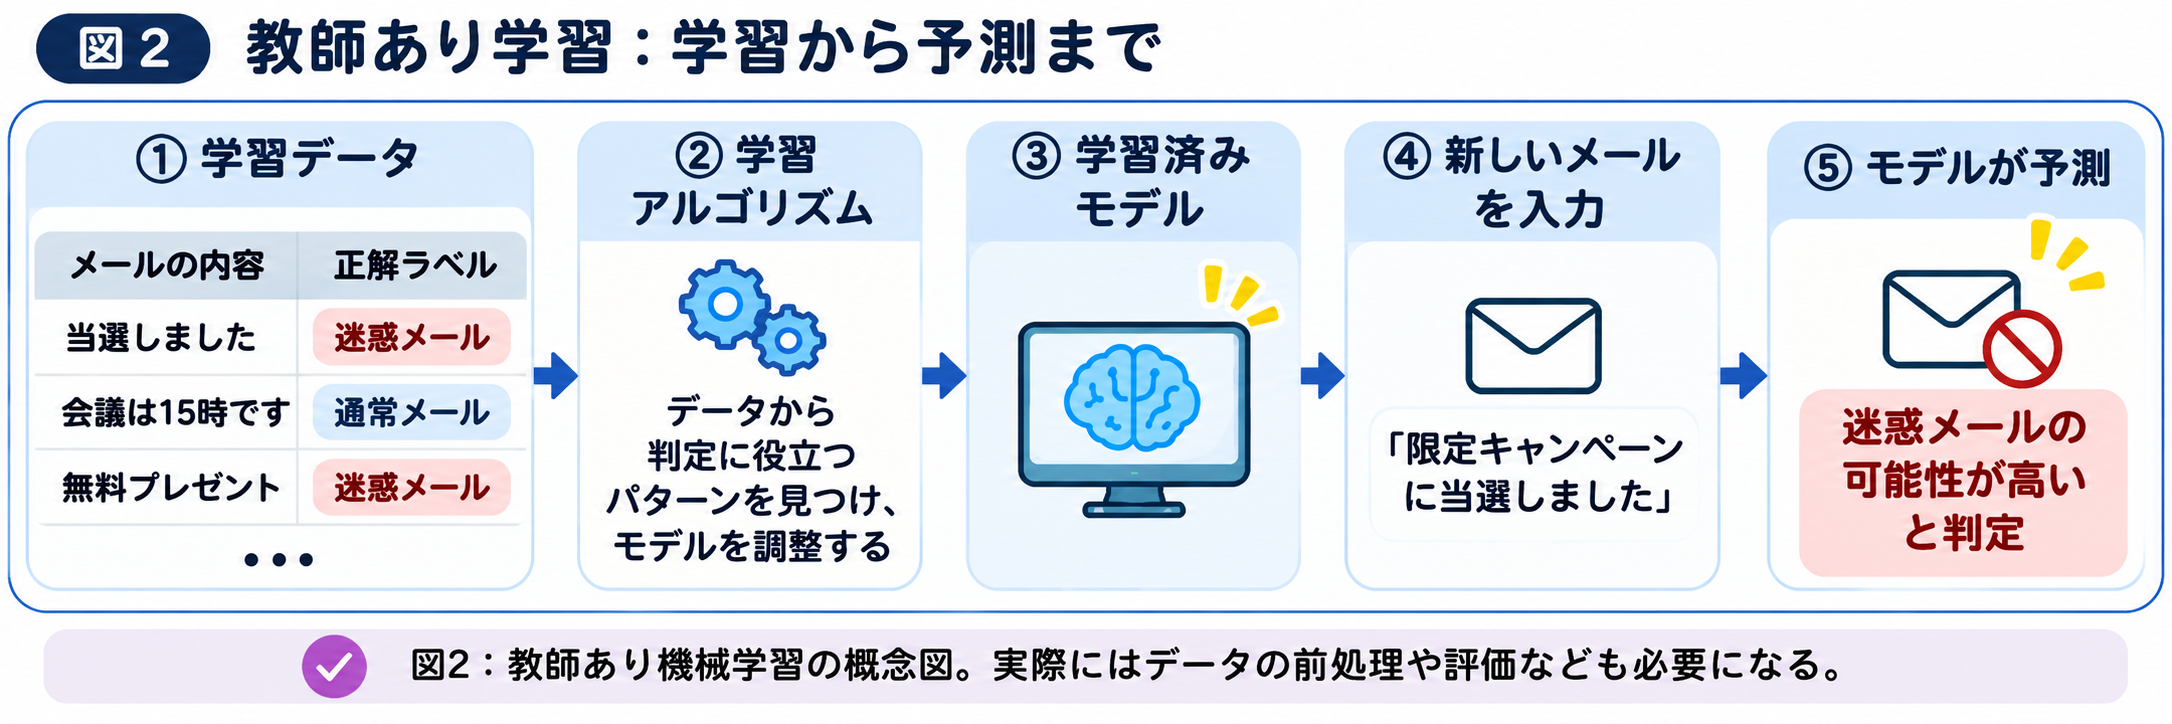
伴菜:「今説明しているのは、正解付きのデータを使う教師あり学習の例だからね。正解を付けない学習方法もあるけれど、それは第3話で詳しくやろう」

美月:「分かった。じゃあ、その教師あり学習はどう進むの?」

美月:「あれ? 学習アルゴリズムと学習済みモデルって、別物なの?」

伴菜:「いいところに気づいたね。学習アルゴリズムは、データを使ってモデルを調整するための手順。モデルは、その学習の結果を使って予測する仕組みなの」

美月:「つまり、学習するための方法と、学習してできあがったものが違うんだ」

伴菜:「そう。例えば、学習済みモデルの中には、入力された情報をどう組み合わせるかを決める数値、つまりパラメータがあるの。学習では、その数値を調整していくことが多いんだよ」

美月:「へえ。じゃあ、学習済みモデルは過去のメールを全部丸暗記しているわけじゃないんだね」

伴菜:「そう。基本的には、データから見つけたパターンを新しい入力にも使えるようにすることが目的なの。ただし、モデルによっては学習データを過度に記憶してしまうこともあるよ」

美月:「その場合は、初めて見るメールに弱くなる?」

伴菜:「そういうことがある。後で説明する『過学習』という問題だね」

4. 学習と推論は何が違うの?

美月:「ハンナ、もう一つ。ChatGPTに質問したときも、毎回学習しているの?」

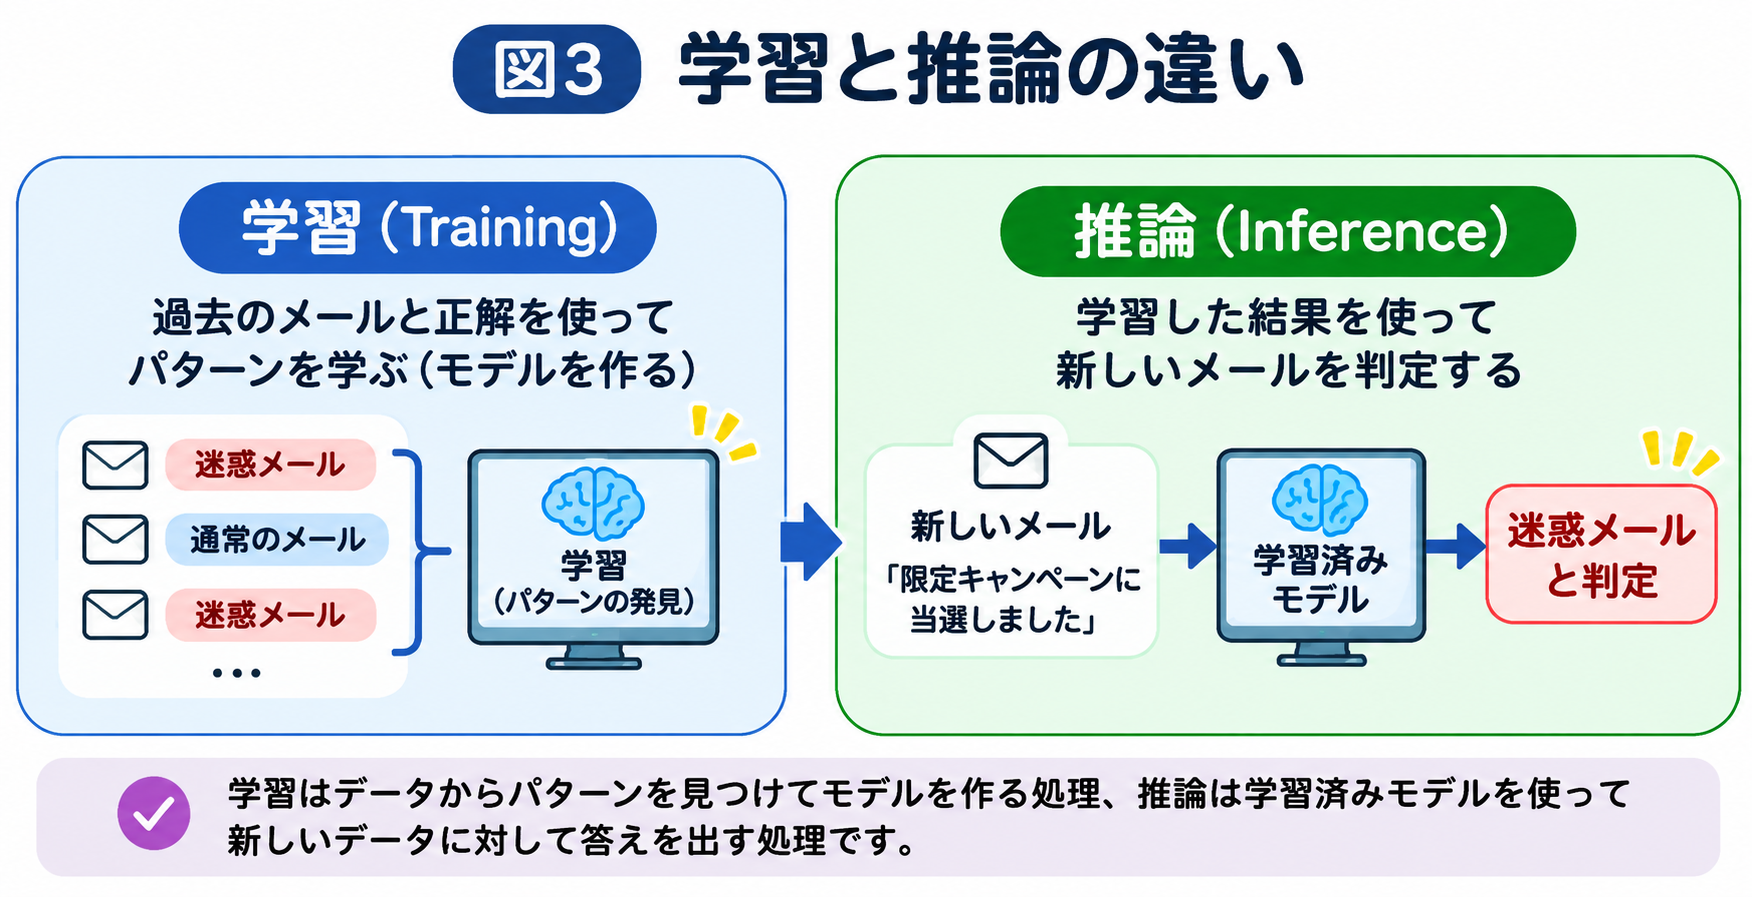
伴菜:「そこは区別が必要だね。AIには大きく分けて、モデルを作ったり調整したりする**学習(Training)と、学習済みモデルを使って出力を求める推論(Inference)**があるの」

美月:「推論って、考えること?」

伴菜:「AIの文脈では、学習済みモデルに新しい入力を与えて、予測や回答などの出力を得る処理のことだよ。必ずしも人間と同じように考えているという意味じゃないの」

美月:「じゃあ、私がChatGPTに『今日の夕飯、何にする?』って聞くのは推論?」

伴菜:「そう。一般的なチャットで回答を生成する処理は推論だよ。会話履歴を参照して答え方が変わることはあっても、それだけでモデルの重みが毎回更新されているとは限らないの」

美月:「なるほど。会話の内容を覚えているように見えることと、モデル自体が学習していることは別なんだ」

伴菜:「その理解でいいよ。AIシステムによっては、会話履歴や外部の記憶を利用することもあるけれど、それもモデルの再学習とは区別する必要があるんだ」

美月:「AIって一言で言っても、内部ではいろんな仕組みが動いているんだね」

5. AI・機械学習・ディープラーニングの関係

美月:「ところでハンナ、AIと機械学習は別物なの? それとも同じなの?」

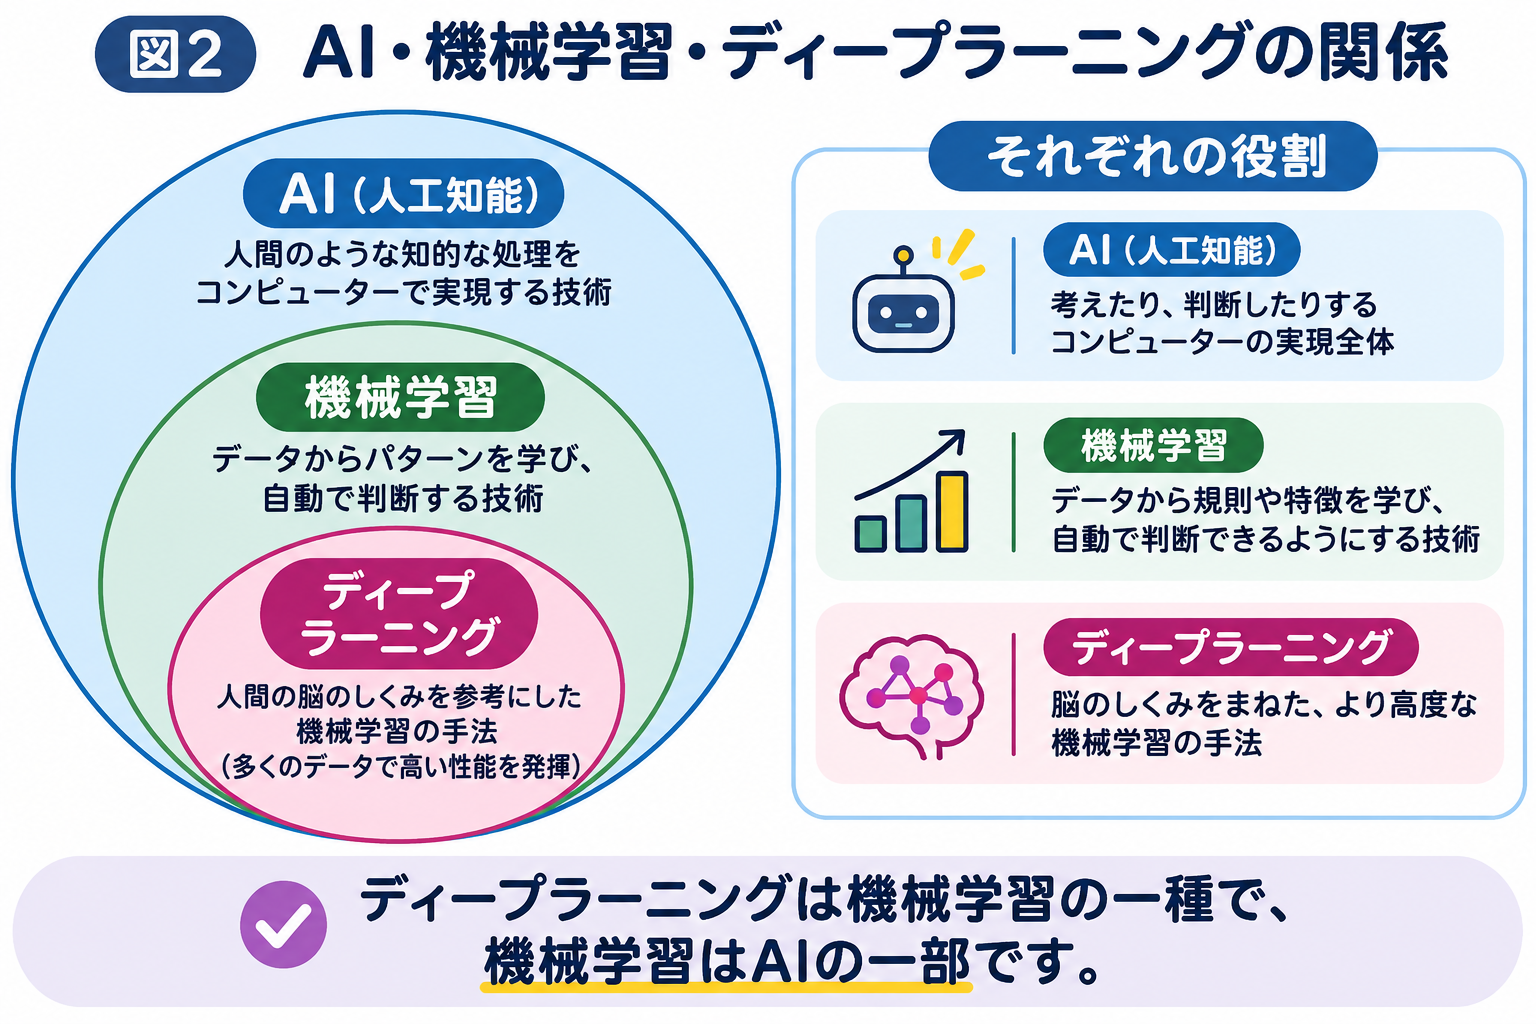
伴菜:「機械学習はAIの一分野だよ。そして、ディープラーニングは機械学習の一分野なの」

美月:「あ、3分版で見た入れ子の図だ!」

美月:「ディープラーニングは、機械学習をもっと深くしたもの?」

伴菜:「名前の『ディープ』は、主にニューラルネットワークの層が深いことを指しているんだ」

美月:「ニューラルネットワーク?」

伴菜:「人間の神経回路から着想を得た計算モデルだよ。たくさんの計算単位を層状につなげて、入力データを段階的に処理するの」

美月:「じゃあ、ディープラーニングは人間の脳をそのまま再現しているの?」

伴菜:「そこは違うよ。脳からヒントを得ているけれど、実際の脳の仕組みをそのまま再現したものではないんだ」

美月:「なるほど。じゃあ、ディープラーニング以外の機械学習もあるの?」

伴菜:「もちろん。決定木、ロジスティック回帰、サポートベクターマシンなど、いろんな方法があるよ」

美月:「えっ、ロジスティック回帰って、名前に回帰って付いてるのに?」

伴菜:「ふふ。その疑問はいいね。実はロジスティック回帰は、一般に分類問題に使われる手法なんだ。名前だけで判断すると間違えやすいところだよ」

美月:「紛らわしい名前を付けた人に文句を言いたい!」

伴菜:「第4話で詳しく説明するから、今は楽しみにしておいて」

6. AIはどうして間違えるの?

美月:「ねえ、機械学習って大量のデータで勉強するんでしょ? それなら、たくさん学習させれば間違えなくなるんじゃない?」

伴菜:「そうとも限らないんだ。例えば、美月が犬と猫の写真を見分けるAIを作るとするね」

美月:「それなら、犬と猫の写真を何千枚も用意する!」

伴菜:「いいね。でも、犬の写真が全部屋外で、猫の写真が全部室内だったら?」

美月:「……あれ? AIが『外にいるのは犬、家の中にいるのは猫』って覚えちゃうかも」

伴菜:「その可能性があるの。犬と猫そのものの特徴ではなく、背景にある偶然の違いを判断材料にしてしまうことがあるんだ」

美月:「じゃあ、室内にいる犬の写真を見せたら猫だって答えるかもしれない!」

伴菜:「そう。データの偏りが原因で、実際に使う場面で予測がうまくいかないことがあるんだよ」

美月:「データが多ければいい、という単純な話じゃないんだね」

伴菜:「そう。もう一つ、過学習という問題もあるよ」

美月:「さっき言ってたやつだ!」

伴菜:「例えば、美月が英単語の小テストを受けるとするでしょう? 練習問題の答えだけを丸暗記していたら、まったく同じ問題には正解できるかもしれない」

美月:「でも、問題文が変わったら分からないかも」

伴菜:「そうだね。機械学習でも、学習データには非常によく合うのに、新しいデータでは予測が悪くなることがある。それが過学習だよ」

美月:「じゃあ、AIを作ったら、初めて見るデータでも試さないといけないんだね」

伴菜:「その通り。学習に使っていないデータで評価することが大切なんだ」

美月:「なんだか学校のテストみたい。練習問題を覚えるだけじゃなくて、応用問題が解けるかを確認するんだ」

伴菜:「いい例えだね。機械学習では、未知のデータにも適切に対応できる性質を『汎化』というんだよ」

美月:「汎化! これは覚えておこう」

7. どんな仕事にもAIを使えばいいの?

美月:「ここまで聞くと、AIってすごく便利だよね。じゃあ、会社のシステムも全部AIにすればいいんじゃない?」

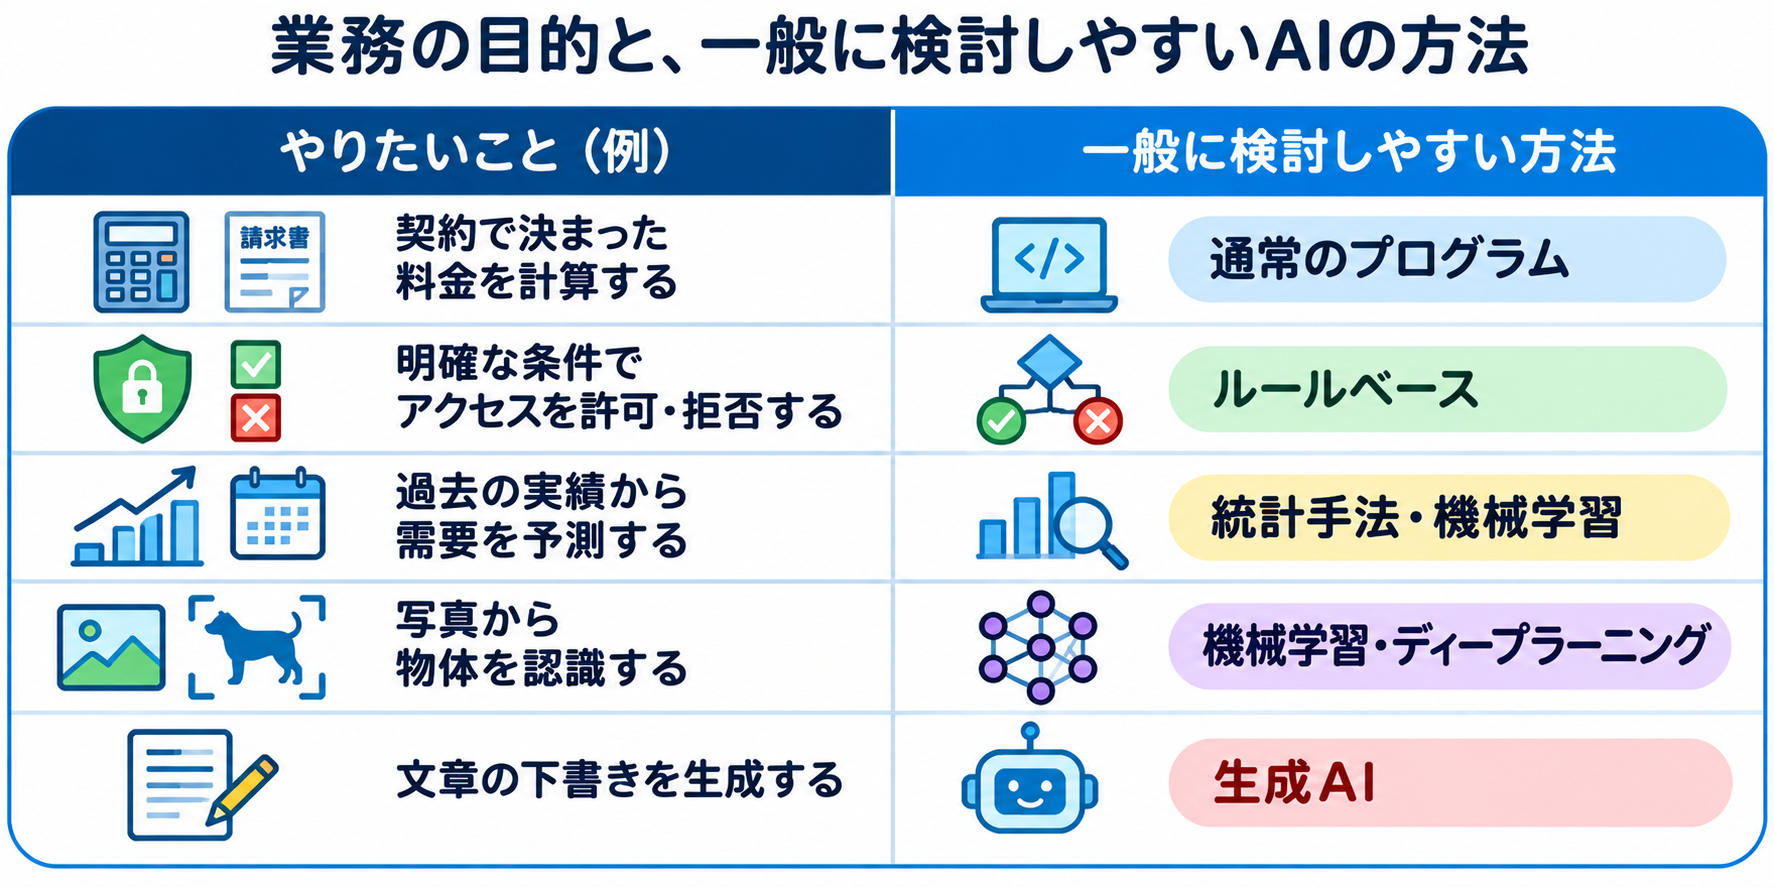
伴菜:「例えば、毎月の請求金額を計算するシステムは?」

美月:「それもAIに……あれ? でも、請求金額って正確に計算できないと困るよね」

伴菜:「そう。税率や契約条件、計算式が明確なら、普通のプログラムで正確に処理するほうが適していることが多いんだ」

美月:「AIに計算させて、請求金額が毎回変わったら大変だもんね」

伴菜:「一方で、過去の販売実績や季節性から来月の需要を予測したい場合はどうかな?」

美月:「それなら、データからパターンを見つける機械学習が役立ちそう!」

伴菜:「そうだね。ただ、AIを使えば必ず予測精度が上がるわけではないし、データが少なかったり、単純な方法で十分だったりすることもあるよ」

美月:「じゃあ、AIを使うかどうかも判断しないといけないんだ」

伴菜:「その通り。AIを導入すること自体が目的になってはいけないの」

美月:「あれ? 最後に生成AIが出てきた!」

伴菜:「うん。生成AIは文章や画像など、新しいコンテンツを生成するAIのこと。AI・機械学習・ディープラーニングとは、少し違う切り口の分類なんだ」

美月:「じゃあ、生成AIがディープラーニングのさらに内側にある、というわけじゃないの?」

伴菜:「そういう単純な包含関係として考えないほうがいいね。現在の代表的な生成AIはディープラーニングを使っているけれど、『何をするAIか』という機能の分類だからね」

美月:「なるほど。第6話で詳しく教えてね!」

8. 今日のまとめ

伴菜:「じゃあ、美月。今日は少し難しかったけれど、復習してみようか」

美月:「望むところよ、お姉さま!」

伴菜:「急にどうしたの、その呼び方。じゃあ、AIって何?」

美月:「認識や予測、推論、言語処理みたいな、人間の知的活動に関係する処理をコンピューターで実現する技術の総称!」

伴菜:「うん。じゃあ、AIは必ず機械学習を使う?」

美月:「使わない! ルールや専門知識を使って推論するAIもある!」

伴菜:「機械学習では何をするの?」

美月:「データからパターンを学習して、新しいデータの予測などに利用する!」

伴菜:「学習と推論の違いは?」

美月:「学習はモデルを調整すること。推論は学習済みモデルを使って結果を出すこと!」

伴菜:「じゃあ最後。AIを使えば、どんな仕事も良くなる?」

美月:「ならない! 普通のプログラムのほうが向いている仕事もある!」

伴菜:「完璧!」

美月:「ふふん。これで私もAI専門家かな?」

伴菜:「まだ第1話だよ?」

美月:「先は長いなあ!」

もっと知りたい! AI用語集

美月:「ハンナ、今回も新しい言葉がたくさん出てきたね!」

伴菜:「分からない言葉があったら、AI用語集で復習してみてね。図解や具体例でもっと詳しく説明しているわよ」

今回の関連用語

  • AI(人工知能)
  • 機械学習(Machine Learning)
  • ディープラーニング(Deep Learning)
  • モデル(Model)
  • 学習(Training)
  • 推論(Inference)

→ 伴菜と美月のAI用語集を見る

理解度チェック(30 Minutes AI 第1話)

伴菜と美月のAI教室へようこそ!

30 Mins AI 第1話「AIって、そもそも何?」の理解度チェックです。

全5問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. AI(人工知能)と機械学習(Machine Learning)の関係について、最も正しい説明はどれ?

Q2. ある企業が、専門家の知識を「条件と結論」のルールとして登録し、設備の故障原因を診断するシステムを開発した。この仕組みについて最も適切な説明はどれ?

Q3. 大量の迷惑メールと通常メールを使って学習したモデルに、新しく届いたメールを入力し、迷惑メールかどうかを判定させた。この新しいメールの判定処理は何と呼ばれる?

Q4. AI、機械学習、ディープラーニングの包含関係として、最も適切なものはどれ?

Q5. ある企業では、請求書の合計金額に消費税率を適用して税込金額を計算したい。税率と計算方法は明確に決まっている。この場合、最も適切な選択はどれ?


基本から復習したい人へ

ここまでで、AIと機械学習の違い、ルールベースAIの仕組み、学習と推論の関係、ディープラーニングの位置づけを詳しく学んだよ。

「ちょっと難しかったな」「もう一度、基本を整理したいな」と思ったら、3分版に戻って伴菜と美月の会話を読み返してみよう!

← 3 Minutes AI 第1話へ


カテゴリー
2026年 3 Minutes AI AI コンピューター 伴菜と美月のAI教室

3 mins AI 第1話|AIって、そもそも何?

伴菜と美月のAI教室 — 3 Minutes AI

1. 電卓もAIなの?

休日の午後。伴菜と美月は、ダイニングテーブルでお茶を飲んでいた。

美月:「ねえ、ハンナ。最近、何でもAIって言うじゃない?」

伴菜:「そうだね。スマホの顔認証とか、ChatGPTとか」

美月:「でもさ、電卓だって人間より計算が速いでしょ? あれもAIなの?」

伴菜:「普通の電卓はAIとは呼ばないよ」

美月:「なんで? 私よりずっと頭いいじゃん」

伴菜:「計算が速いことと、知的な処理をすることは違うんだよ」

美月:「知的な処理?」

伴菜:「例えば、写真を見て犬か猫かを判断したり、文章を読んで質問に答えたりすること。そういう処理をコンピューターで実現する技術を、まとめてAI、人工知能って呼ぶんだよ」

美月:「なるほど。単に計算するだけじゃないんだね」

2. 普通のプログラムとは何が違う?

美月:「でもハンナ、普通のプログラムだって判断するよね?」

伴菜:「するよ。例えば迷惑メールを判定するプログラムを考えてみようか」

美月:「『当選しました!』って書いてあったら迷惑メール!」

伴菜:「それも一つの方法だね。人間が条件を決めて、その条件に従って判定する方法をルールベースというの」

美月:「じゃあ、AIは?」

伴菜:「AIの一分野である機械学習なら、過去のメールをたくさん使って、迷惑メールに共通する特徴を学習できるんだよ」

美月:「あ、そういうことか! 機械学習は、全部の条件を人間が書かなくてもいいんだね」

伴菜:「そう。でも、学習に使うデータが悪ければ、間違った判断をすることもあるよ」

美月:「AIだからって万能じゃないんだ」

美月:「ねえ、ハンナ。過去のメールから学習するのは分かったけど、新しいメールが届いたときはどうするの?」

伴菜:「いい質問だね。実は、機械学習には『学習』と『推論』という二つの大切な処理があるんだよ」

美月:「推論? また難しい言葉が出てきた!」

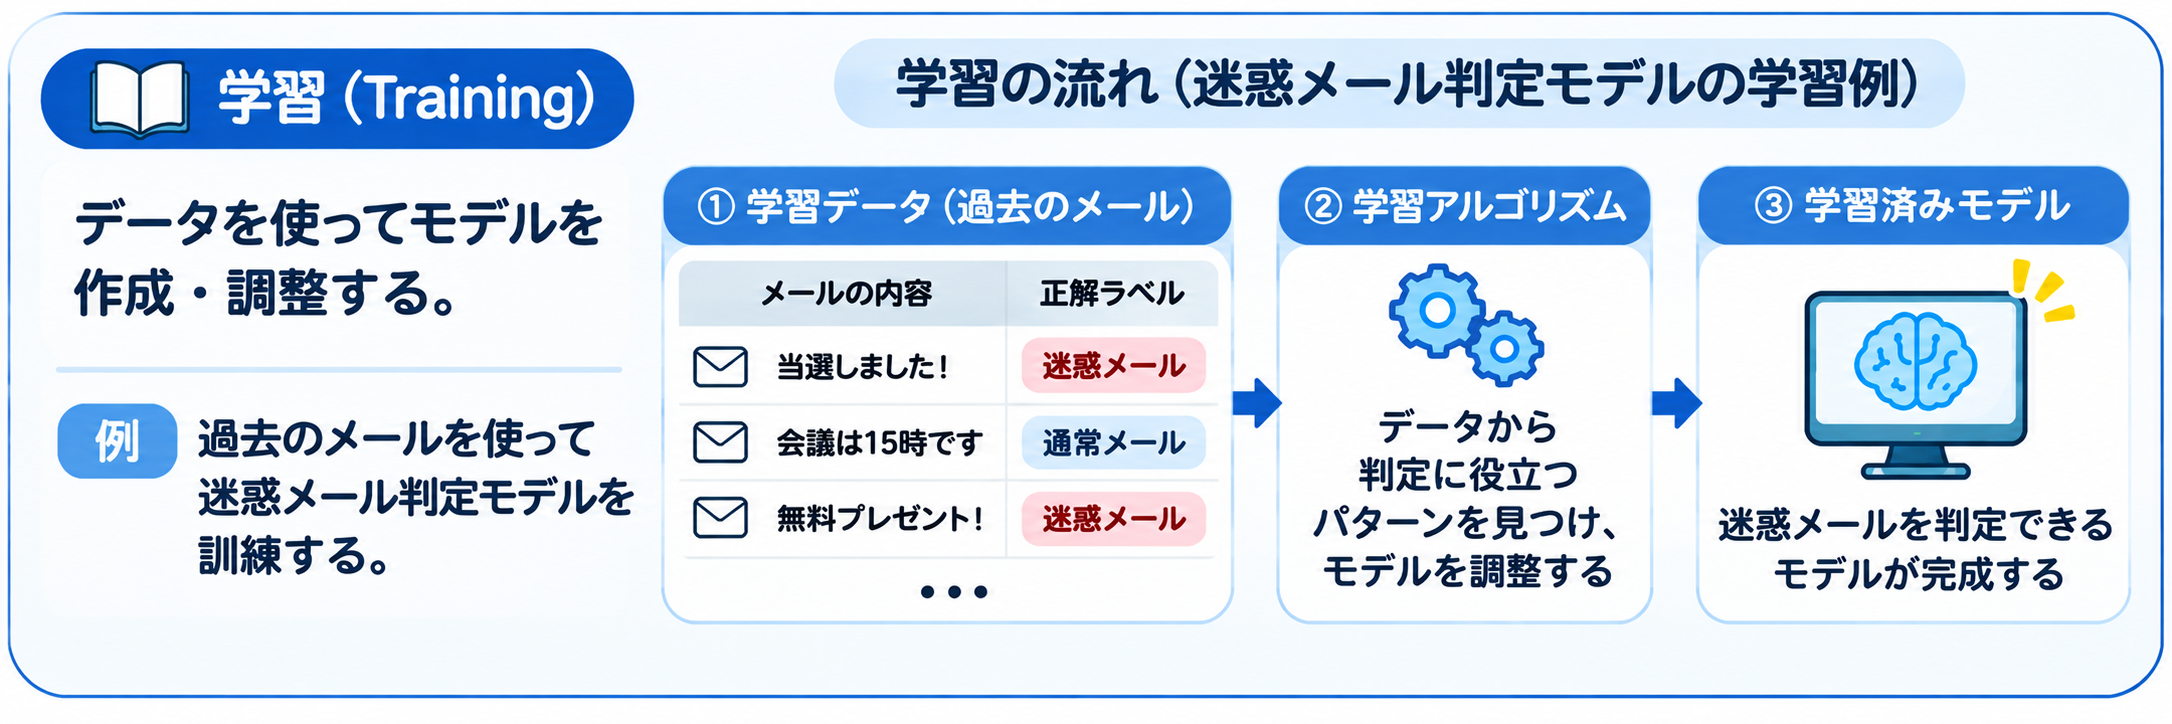
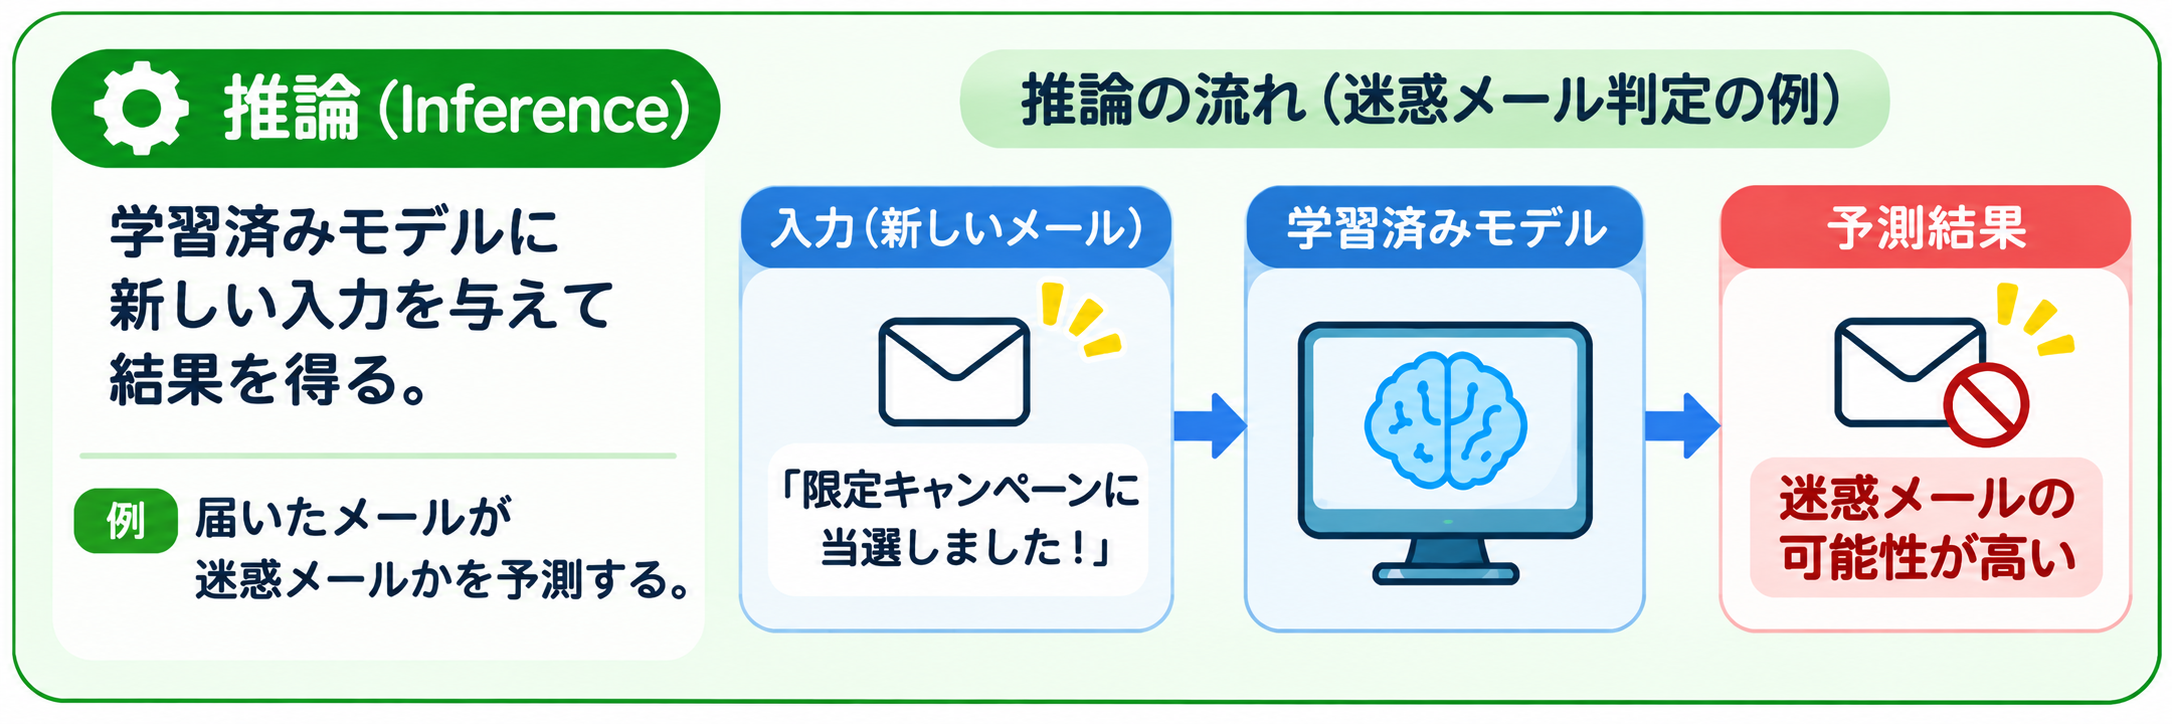
伴菜:「難しく考えなくていいよ。学習は、過去のデータからパターンを見つけてモデルを作ること。推論は、その学習済みモデルを使って、新しいデータに対する答えを出すことなの」

美月:「つまり、過去の迷惑メールで勉強するのが学習で、新しく届いたメールを迷惑メールかどうか判断するのが推論?」

伴菜:「そのとおり! 図で見ると分かりやすいよ」

美月:「なるほど! 学習と推論って、別々の処理なんだね」

伴菜:「そう。しかも、推論するたびに必ず学習し直すわけじゃないんだよ。学習済みモデルをそのまま使って、何度も新しいメールを判定できるの」

美月:「分かった! これなら『推論』って言葉も覚えられそう!」

3. AIと機械学習はどういう関係?

美月:「じゃあ、AIって全部が機械学習なの?」

伴菜:「実は違うんだよ。昔から、人間の専門知識をルールとして登録するエキスパートシステムのようなAIもあるの」

美月:「えっ! ルールを使うAIもあるの?」

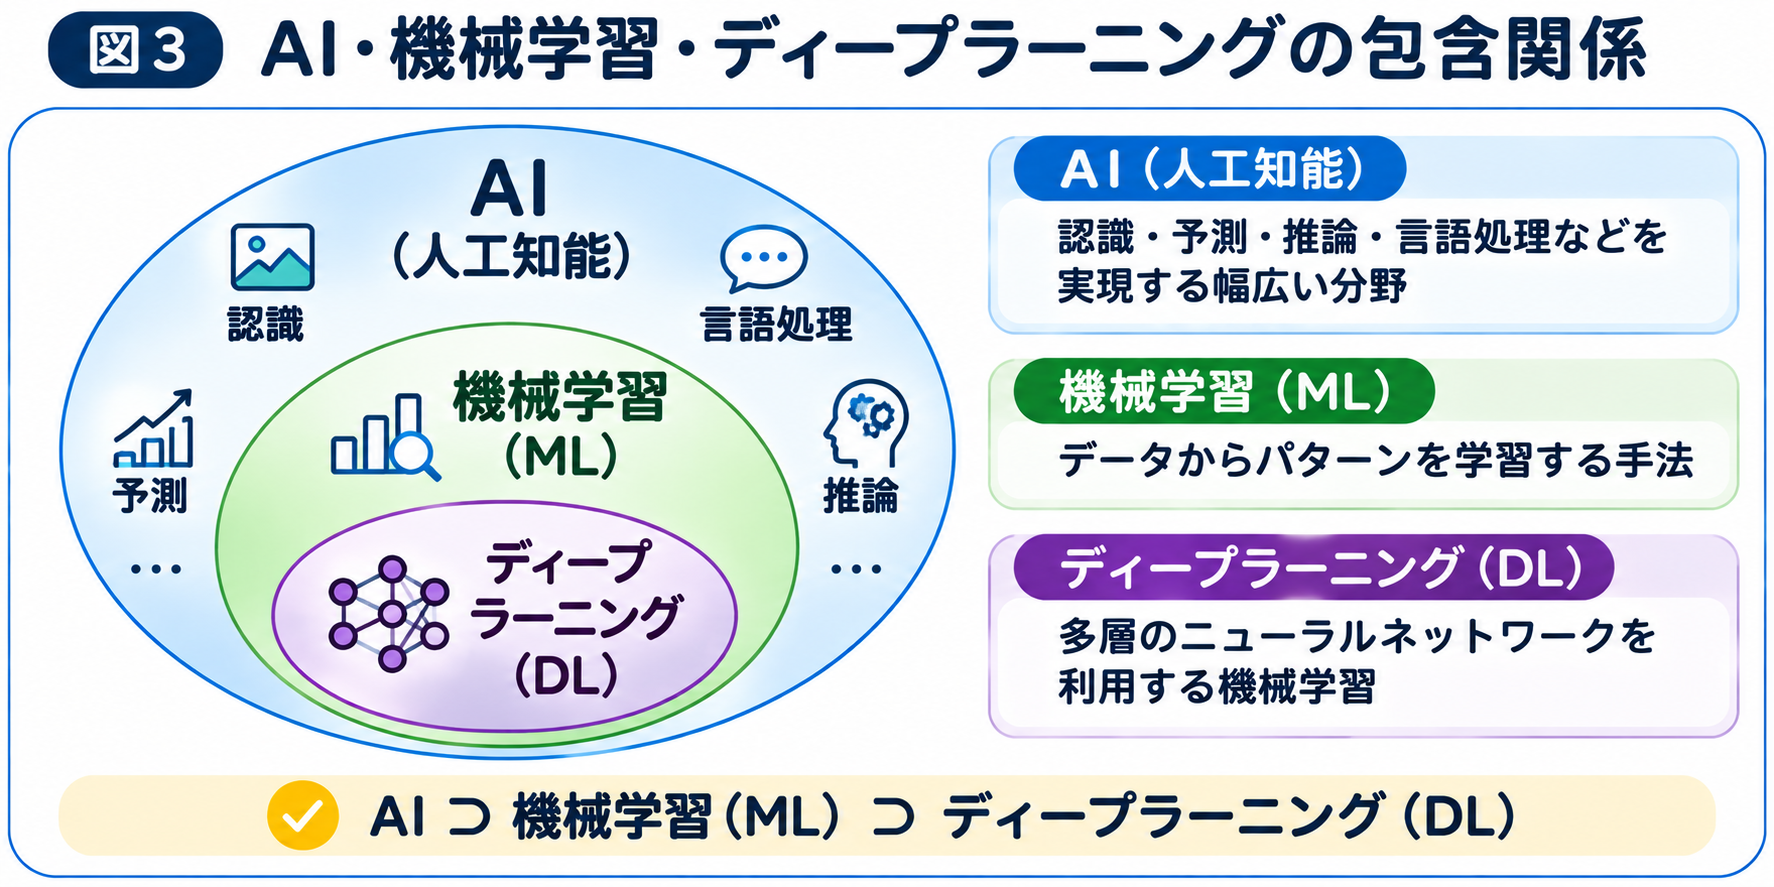
伴菜:「あるよ。だからAIと機械学習は同じ意味じゃないんだ。図で見てみよう」

美月:「なるほど。AIという大きなグループの中に機械学習があって、さらにその中にディープラーニングがあるんだ!」

伴菜:「そのとおり。今日はこの関係を覚えれば十分だよ」

美月:「ところで、ハンナ。ディープラーニングって何?」

伴菜:「それは第5話で詳しく説明するね」

美月:「えー、ずいぶん先じゃない!」

伴菜:「まずは順番に覚えようよ!」

4. 今日のまとめ

伴菜:「じゃあ、美月。今日の復習ね。AIって何?」

美月:「コンピューターで知的な処理を実現する技術のこと!」

伴菜:「機械学習は?」

美月:「AIの一分野で、データからパターンを学習する方法!」

伴菜:「完璧! じゃあ、ディープラーニングは?」

美月:「機械学習の一分野! 詳しくは第5話!」

伴菜:「あはは、ちゃんと覚えてるね」

もっと知りたい! AI用語集

美月:「ハンナ、今回も新しい言葉がたくさん出てきたね!」

伴菜:「分からない言葉があったら、AI用語集で復習してみてね。図解や具体例でもっと詳しく説明しているわよ」

今回の関連用語

  • AI(人工知能)
  • 機械学習(Machine Learning)
  • ディープラーニング(Deep Learning)
  • モデル(Model)
  • 学習(Training)
  • 推論(Inference)

→ 伴菜と美月のAI用語集を見る

理解度チェック(3 Minutes AI 第1話)

伴菜と美月のAI教室へようこそ!

3 Mins AI 第1話「AIって、そもそも何?」の理解度チェックです。

全3問のクイズで、今回学んだ内容を振り返ってみましょう。

回答後には、正解と詳しい解説を確認できます。

準備ができたら「理解度チェックを始める」を押してください。

Q1. AIと機械学習の関係として、正しいものはどれ?

Q2. 学習済みモデルに新しいメールを入力して、迷惑メールかどうかを判定する処理を何という?

Q3. ルールベースと機械学習の違いとして、最も適切なのはどれ?


もっと詳しく学びたい人へ

ここまでで、AIとは何か、機械学習との違い、ディープラーニングとの関係を学んだよ。

→ 30 Minutes AI 第1話へ


次回予告

第2話「AIはどうやって勉強するの?」

機械学習では、データからどうやってパターンを学ぶのか? 犬と猫の写真を例に、学習の基本を見ていこう!

カテゴリー
VIrutalBox コンピューター 仮想化 技術一般

VirtualBox インストールエラーの解決法


にほんブログ村

ミニPC(SkyBarium N1 Pro ミニPC Intel N150)を購入してWindows を動かしているのですが、そこに VIrtual Box をインストールしてみたいなと試したところ、エラーに遭遇しました。その時の対応メモです。

Virtual Box自体はインストールできたのですが、仮想マシンを起動しようとすると、こんなエラーが出力されました。

NtcreateFile(\Device\VNoxDrvStub) failed: 0xc0000034
STATUS_OBJECT_NAME_NOT_FOUND (0 reties) (rc = 101)

エラー内容を見ていても意味が分からなかったので、ChatGPTでエラーを調べてみると、「管理者権限で再インストールを試してみる」と言われました。

そして、一度アンインストールしてから、再度インストールする時に、無視していたメッセージに気づきました。

Missing Dependencies Python Core / Win32api

無視して Yes を押して進んでいましたが、Python が必要と書いてあります。Virtual Boxって、いつの間にか、Python を使うようになっていたのですね。

つまり結論から言うと、Virtual Box のインストールの前に、Python と pywin32 をインストールすると解決します。

対応方法

Pythonのダウンロードページへ移動します。

Pythonは、最新版をインストールしれば良いです。

インストーラーをダブルクリックして、インストールを開始します。

インストールする時に気をつけないといけないのが、「Add p ython.exe to PATH」のチェックボックスを必ず有効にしてからインストールすることです。

これにチェックを入れずにPythonをインストールすると、最初と同じエラーが出続けてしまい、仮想マシンが起動しません。

最後に、「Disable path length limit」というのが表示されますが、これは無視して良いみたいです。

Closeで、インストーラーを終了させます。

Pythonのインストールが完了したら、最後に1つコマンドを投入します。コマンドプロンプトは、管理者権限で起動する必要があります。

pip install pywin32

インストールできたら完了です。

この後に、VIrtual Boxをインストールしましょう。

関連するブログ:

最近の人気ブログ TOP 10:

最近の記事:

カテゴリー
2025年 Linux LPIC Ubuntu トラブルシューティング 技術一般 管理

複数の宛先に ping を打つことができる「fping」


にほんブログ村

Windows には「Exping」という便利なツールがあるのですが、ExpingはLinuxでは使えません。でも、Linuxには「fping」があります。今回は、「fping」の使い方をまとめてみました。

fping のインストール

「apt install」でインストールできます。

$ sudo apt update
$ sudo apt install fping

ping の使い方

基本的な使い方は、1つの宛先に対して ICMP Echo Request を送ります。通常の ping と同じです。

ICMP Echo Reply が返ってこれば「xxxx is alive」、返ってこなければ「xxx is unreachable」と表示されます。

KKIntt@jackson:~$ fping 172.16.26.1
172.16.26.1 is alive
KKInt@jackson:~$ fping 172.16.26.5
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.5
172.16.26.5 is unreachable

もちろん、IPアドレスだけでなく、ホスト名を指定することもできます。

KKInt@jackson:~$ fping www.yahoo.co.jp
www.yahoo.co.jp is alive

宛先の複数指定

単純に、ICMP Echo Request を送信したい宛先を並べて指定します。

KKInt@jackson:~$ fping 172.16.26.1 172.16.26.2 172.16.26.4
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive

範囲を指定しての宛先指定

-g オプションを使うことで、指定した範囲の IPアドレスに対して ICMP Echo Request を送信することが出来ます。

以下の例では、172.16.26.1から172.16.26.5までを範囲として指定しています。そのうち、4オクテッド目が3と5のIPアドレスからはICMP Echo Reply が返ってていません。

KKInt@jackson:~$ fping -g 172.16.26.1 172.16.26.5
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.3
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.5
172.16.26.3 is unreachable
172.16.26.5 is unreachable

サブネットマスクを指定しての宛先指定

-g オプションを使用すると、サブネットマスク単位で ICMP Echo Request を送信する範囲を指定することも出来ます。

「172.16.26.0/29」を指定する場合は、以下のように指定します。

最初の 172.16.26.0 はネットワークアドレス、最後の172.16.26.7 はブロードキャストアドレスになるため、「172.16.26.0/29」の場合、172.16.26.1 – 172.16.26.6 がPing の対象となります。

KKInt@jackson:~$ fping -g 172.16.26.0/29
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.6
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.5
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.3
172.16.26.3 is unreachable
172.16.26.5 is unreachable
172.16.26.6 is unreachable
kanta@jackson:~$ 

ファイルから読み込んで範囲指定

-f オプションを使用すると、ファイル読み込んでfpingを実行することが出来ます。

まず、ping-list というファイルを作成し、 以下のように宛先IPアドレスを記述しました。

KKInt@jackson:~$ cat ping-list 
172.16.26.1
172.16.26.2
172.16.26.4
172.16.26.7
172.16.26.8

-f オプションで対象のファイルを読み込んで fping を実行することで、ファイルに記載されている宛先 IPアドレスに対して ICMP Echo Request を送信することが出来ます。

KKInt@jackson:~$ fping -f ping-list
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
172.16.26.7 is alive
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.8
172.16.26.8 is unreachable

結局はLinux上での操作ですので、ファイルの読み込ませ方は、いろいろできます。

「<」でファイルを fping に渡せますし、

$ fping < ping_list.txt 

cat で表示させたファイルの内容を fping に渡すことも可能です。

$ cat ping_list.txt | fping

送信回数指定

-c オプションを使用すると、ICMP Echo Request を送信する回数を指定することが出来ます。

3回送信したい場合は、以下のように実行します。

KKInt@jackson:~$ fping -c3 172.16.26.1
172.16.26.1 : [0], 64 bytes, 0.203 ms (0.203 avg, 0% loss)
172.16.26.1 : [1], 64 bytes, 0.234 ms (0.218 avg, 0% loss)
172.16.26.1 : [2], 64 bytes, 0.150 ms (0.195 avg, 0% loss)

172.16.26.1 : xmt/rcv/%loss = 3/3/0%, min/avg/max = 0.150/0.195/0.234

送信し続ける

ICMP Echo Request を送信し続けたい場合は -l オプションを使用します。

「Ctrl + C」で、Echo Request の送信を停止することができます。

KKInt@jackson:~$ fping -l 172.16.26.1
172.16.26.1 : [0], 64 bytes, 0.226 ms (0.226 avg, 0% loss)
172.16.26.1 : [1], 64 bytes, 0.132 ms (0.179 avg, 0% loss)
172.16.26.1 : [2], 64 bytes, 0.125 ms (0.161 avg, 0% loss)
172.16.26.1 : [3], 64 bytes, 0.195 ms (0.169 avg, 0% loss)
172.16.26.1 : [4], 64 bytes, 0.205 ms (0.176 avg, 0% loss)
172.16.26.1 : [5], 64 bytes, 0.223 ms (0.184 avg, 0% loss)
^C <<< Ctl + c で終了
172.16.26.1 : xmt/rcv/%loss = 6/6/0%, min/avg/max = 0.125/0.184/0.226

送信間隔(ミリ秒)

-i オプションを使用すると、ICMP Echo Request を送信する間隔を指定することが出来ます。

指定する時間の単位はミリ秒なので、3秒間隔ならば「3000」と指定します。

KKInt@jackson:~$ fping -c3 -i 3000 172.16.26.1
172.16.26.1 : [0], 64 bytes, 0.185 ms (0.185 avg, 0% loss)
172.16.26.1 : [1], 64 bytes, 0.138 ms (0.162 avg, 0% loss)
172.16.26.1 : [2], 64 bytes, 0.186 ms (0.170 avg, 0% loss)

172.16.26.1 : xmt/rcv/%loss = 3/3/0%, min/avg/max = 0.138/0.170/0.186

ICMP Host Unreachableを表示させたくない

ICMP Echo Request が失敗した際に表示される「ICMP Host Unreachable 〜」というメッセージを表示させたくない場合の方法です。

「ICMP Host Unreachable 〜」は標準エラー出力なので、「2>」を指定してエラー出力を /dev/null に送ることで、メッセージの表示を抑えることができます。

KKInt@jackson:~$ fping -f ping-list 2> /dev/null 
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
172.16.26.7 is alive
172.16.26.8 is unreachable

alive なホストのみ表示

-a オプションを使用すると、ICMP Echo Replyを返す(Alive)ホストのみを表示することができます。

以下の例では「ICMP Host Unreachable 〜」のメッセージを/dev/null に送って表示させないようにしています。

KKInt@jackson:~$ fping -a  -f ping-list 2> /dev/null 
172.16.26.1
172.16.26.2
172.16.26.4
172.16.26.7

-a オプションを使わなくても、以下のように grep で抽出することもできます。

KKInt@jackson:~$ fping -f ping-list 2> /dev/null | grep alive
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
172.16.26.7 is alive

unreachable だけ表示

-u オプションを使用すると、ICMP Echo Reply を返さないホスト(unreachable)のみを表示することができます。

KKInt@jackson:~$ fping -u -f ping-list 2> /dev/null 
172.16.26.8

unreachable のメッセージも合わせて表示させたい場合は、fping の結果を grepに渡すことで unreachable のみ表示させることもできますね。

KKInt@jackson:~$ fping -f ping-list 2> /dev/null | grep unreachable
172.16.26.8 is unreachable

統計情報表示

-s オプションを使用すると、実行結果の統計情報を表示します。

KKInt@jackson:~$ fping -f ping-list -s
172.16.26.1 is alive
172.16.26.2 is alive
172.16.26.4 is alive
172.16.26.7 is alive
ICMP Host Unreachable from 172.16.26.11 for ICMP Echo sent to 172.16.26.8
172.16.26.8 is unreachable

       5 targets
       4 alive
       1 unreachable
       0 unknown addresses

       4 timeouts (waiting for response)
       8 ICMP Echos sent
       4 ICMP Echo Replies received
       4 other ICMP received

 0.207 ms (min round trip time)
 0.229 ms (avg round trip time)
 0.249 ms (max round trip time)
        4.107 sec (elapsed real time)

関連するブログ:

最近の人気ブログ TOP 10:

最近の記事:

カテゴリー
2024年 Azure Microsoft MS Azure Administrator MS Azure Fundamentals クラウド コンピューター 技術一般 認定資格

MS Azure を学ぶ (3) リソースグループの作成と管理 2


にほんブログ村

合格した Azure Administrator (AZ-104)の更新日がだんだんと近づいてきましたので、復習を兼ねて少しずつアウトプットしていきたいと思います。

私が勉強に使った教材は、こちらでブログで紹介しています。

リソースグループのメリット

リソースグループにリソースをまとめておくことで、次のようなメリットがあります。

  • リソースの閲覧がしやすくなる
  • リソースグループごとに課金情報を整理することで、各グループの費用を明確把握できる
  • 不要になったリソースを複数まとめて削除できる
  • リソースグループを対象としたテンプレートを活用することで、複数のリソースを一括してデプロイできる
  • 権限やポリシーを複数のリソースに対してまとめて付与できる
  • リソースへのアクセス権限を集中管理し、セキュリティーを強化できる

パソコンに例えると、テキストや Excel、Word などのファイルを「フォルダに格納して整理」することに似ています。

パソコンで、フォルダごと削除、フォルダに権限を付与するといったことが可能なように、Azure ではリソースグループを使って、まとめて管理が可能となります。

リソースグループの一般的な使われ方

ライフサイクルの異なるリソースごとで分類するのが一般的な使い方となります。

  • 開発環境
  • 検証環境
  • 本番環境 など

特に、一時的にテストや検証で利用したい環境などを作成し、後からまとめて削除する場合は、一つのリソースグループにまとめておくと便利です。

リソースグループの注意点

リソースグループを使う上で、いろいろと注意点があります。

  • リソースグループは入れ子にできない
  • リソースグループに所属するリソースのリージョンは別々でもOK(別リージョンにある各リソースを、同じリソースグループに入れることが可能)
  • リソースは、複数のリソースグループに所属できない(どれか一つのリソースグループにのみ所属)
  • 後から別のリソースグループに移動させることもできる

リソースグループの移動

移動操作の間は、ソース グループとターゲット グループの両方がロックされます。

つまり、これらのリソース グループに対する書き込み操作および削除操作は、移動が完了するまでブロックされます。 このロックはリソース グループでリソースを追加、更新、削除できなくなることを意味します。 リソースは停止されません。

たとえば、Azure SQL 論理サーバー、そのサーバーのデータベース、そのサーバーに依存している他のリソースを新しいリソースグループやサブスクリプションに移動しても、そのデータベースを使用するアプリケーションにダウンタイムは発生しません。 引き続きデータベースの読み取りと書き込みを行うことができます。

ロックは最大 4 時間継続できますが、ほとんどの移動は短い時間で完了します。

リソースを移動しても、新しいリソース グループまたはサブスクリプションに移動されるだけです。 リソースの場所は変わりません。

仮想マシンの作成

それでは、今後は移動対象となるリソースを作成したいと思います。

「作成」ボタンを押します。

リソースの作成

マーケットプレースの画面が表示されます。

Fedora Linux を起動させてみましょう。

インスタンスの起動

「作成」ボタンを押します。

インスタンスの作成

Fedora 向けに、以下の項目を指定してきます。

  • サブスクリプション
  • リソースグループ
  • 仮想マシン名(Fedora Linux の名前)

ここで指定するリソースグループは、デフォルトの名前を使用します。これにより、その名前のリソースグループが新規で作成され、リソースがそこに作成されます。

管理アカウントの認証の種類では、今回はパスワードを指定します。

ログインの際に使用するユーザー名とそのパスワードを指定します。

「次:ディスク」を押して次に進みます。

インスタンスの作成

テストで動かすだけの仮想マシンなので、最小の構成にしておきます。

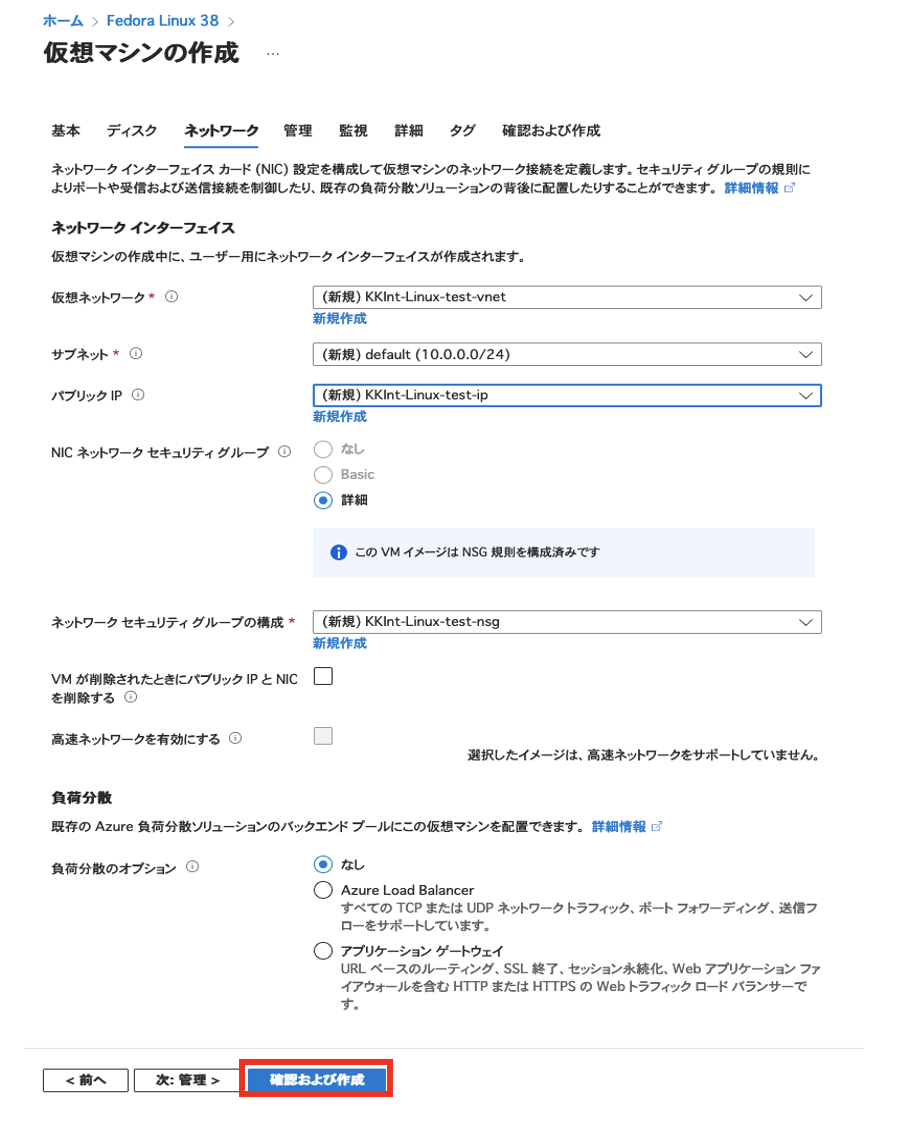
「次:ネットワーク」を押して、次に進みます。

インスタンスの作成

テストなので、ここも基本的にはそのままで良いでしょう。

「確認および作成」をクリックして、次に進みます。

ネットワークの作成

最終確認をして「作成」ボタンを押します。

インスタンスの作成

仮想マシンの作成が始まりました。これには少し時間がかかります。

インスタンスのディプロイ

作成が完了しました。

ディプロイ完了

リソースグループの作成

Azure ポータルにログインして、サービス一覧を表示しますと、「リソースグループ」が見えます。それをクリックします。

リソースグループの表示

上部メニューから「作成」をクリックして、新規でリソースグループを作成します。

リソースグループの作成開始

以下の項目を指定していきます。

  • サブスクリプション
  • リソースグループ(新規リソースグループの名前)
  • リージョン

移動先のリソースグループとして、「KKInternational-test」という名のリソースグループを新規作成します。

リソースグループの名前とリージョンを指定

「作成」ボタンを押します。

リソースグループの作成

リソースグループが新規作成されました。

リソースグループ作成完了

リソースグループの移動

それでは、作成した仮想マシン(Fedora)を、別のリソースグループに移動させてみたいと思います。

ただいま、この仮想マシンのリソースは、KKInternationa-Linux-test_group という名前のリソースグループ内にあります。

移動元になるリソースグループ名をクリックして、リソース一覧を表示させます。

移動させる対象となるリソースをクリックします。今回は全てのリソースを移動させます。

上部メニューにある「移動」ボタンを押します。

プルダウンメニューが表示されるので、「別のリソースグループに移動する」を選択します。

インスタンスを別のリソースグループへ移動

リソースの移動画面が表示されます。

「リソース」のところで、移動先になるリソース名(先ほど作成したもの)をプルダウンメニューから選択します。

「次へ」を押して進みます。

移動先のリソースグループを指定

検証保留中となり、対象のリソースが移動できるかのチェックが開始されます。

移動の確認中

検証が終わり、全てのリソースが「成功」と表示されました。全てのリソースの移動ができるみたいですね。

「次へ」を押して進みます。

確認完了

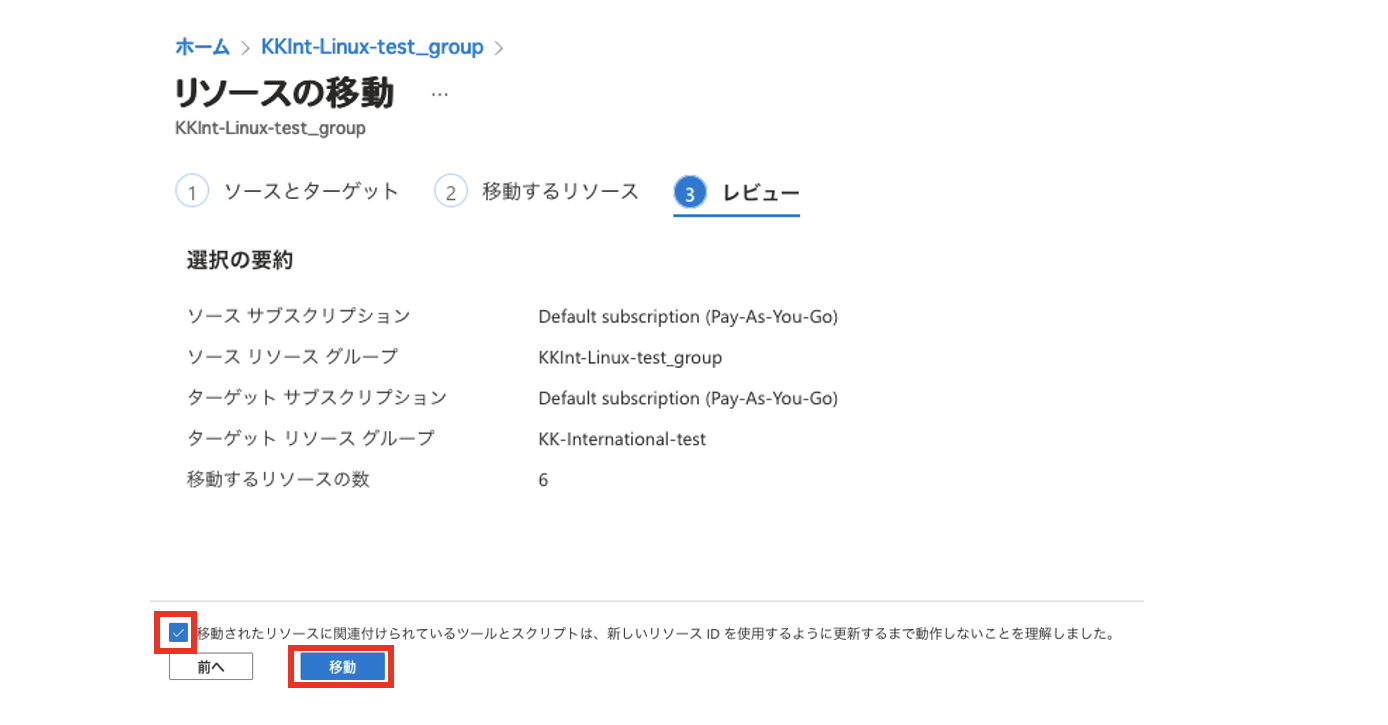
「リソースの移動」画面が表示されます。

チェックボックスにチェックを入れ、「移動」ボタンを押します。

さあ、リソースの移動が始まります。

リソース移動の開始

リソースの移動が始まりました。

この移動には、結構時間がかかります。

リソースの移動完了

リソースの移動が完了したら、元のリソースグループ名(KKInt -Linux-test_group)をクリックして、中を見てみましょう。

仮想マシンの作成時に見えていたリソースの一覧がなくなっています。

古いリソースグループの内容(リソースが無くなっている)

今度は、移動先のリソースグループ名(KKInternational-test)をクリックしてみます。

選択した全てのリソースが見えていますね。

新しいリソースグループの内容(リソースが移動して表示されている)

リソースの移動が完了しました。

合格対策Microsoft認定試験AZ-104:Microsoft Azure Administratorテキスト&演習問題

posted with カエレバ

(模擬試験付き)徹底攻略 Microsoft Azure Administrator 教科書 [AZ-104] 対応

posted with カエレバ

関連するブログ:

最近の人気ブログ TOP 10:

最近の記事:

カテゴリー
2024年 DNS Linux Raspberry Pi Ubuntu ガジェット コンピューター 広告ブロック

Raspberry PiでのPi-Hole設定ガイド


にほんブログ村

Pi-Hole の動作環境

Pi-Hole の動作環境は、以下の通りとなります。

1台目は、Raspberry Pi 4 (4GB) に Raspberry Pi OS 64ビット版をインストールし、そこに Pi-Hole をインストールしました。

2台目は、VMWare のハイパーバイザー(ESXi)の上で動かしている Ubuntu デスクトップにインストールしました。

どちらも快適に動作しています。

Pi-Hole のインストール手順

Curl を使って、Pi-Hole をインストールします。

curl -sSL https://install.pi-hole.net | bash

このような画面が表示され、

インストールが始まります。

インストーラーが動き出します。

「OK」で進みます。

「Pi-HoleはOpen Source Software です」のお知らせです。

「OK」で進みます。

「スタティックIPアドレスが必要です」と出ています。

Pi-Hole は DNS サーバーとなりますので、IPアドレスは固定にする必要があります。

「Continue」を選択して進みます。

通常は、Raspberry Pi のオンボードのイーサネットポートである「eth0」を選択でしょう。

私の環境では、ブリッジインターフェース(br0)を作っていて、そこに IP アドレスを設定していますので、 br0 を選択しています。

選択して、「Select」を押して決定します。

サーバーなので、スタティック IP アドレスを使いましょう。

「Yes」を選択して「Continue」で次に数みます。

ネットワーク上に、IPアドレスの重複がないかを確認します。

重複がなければ「OK」を押して、次に進みます。

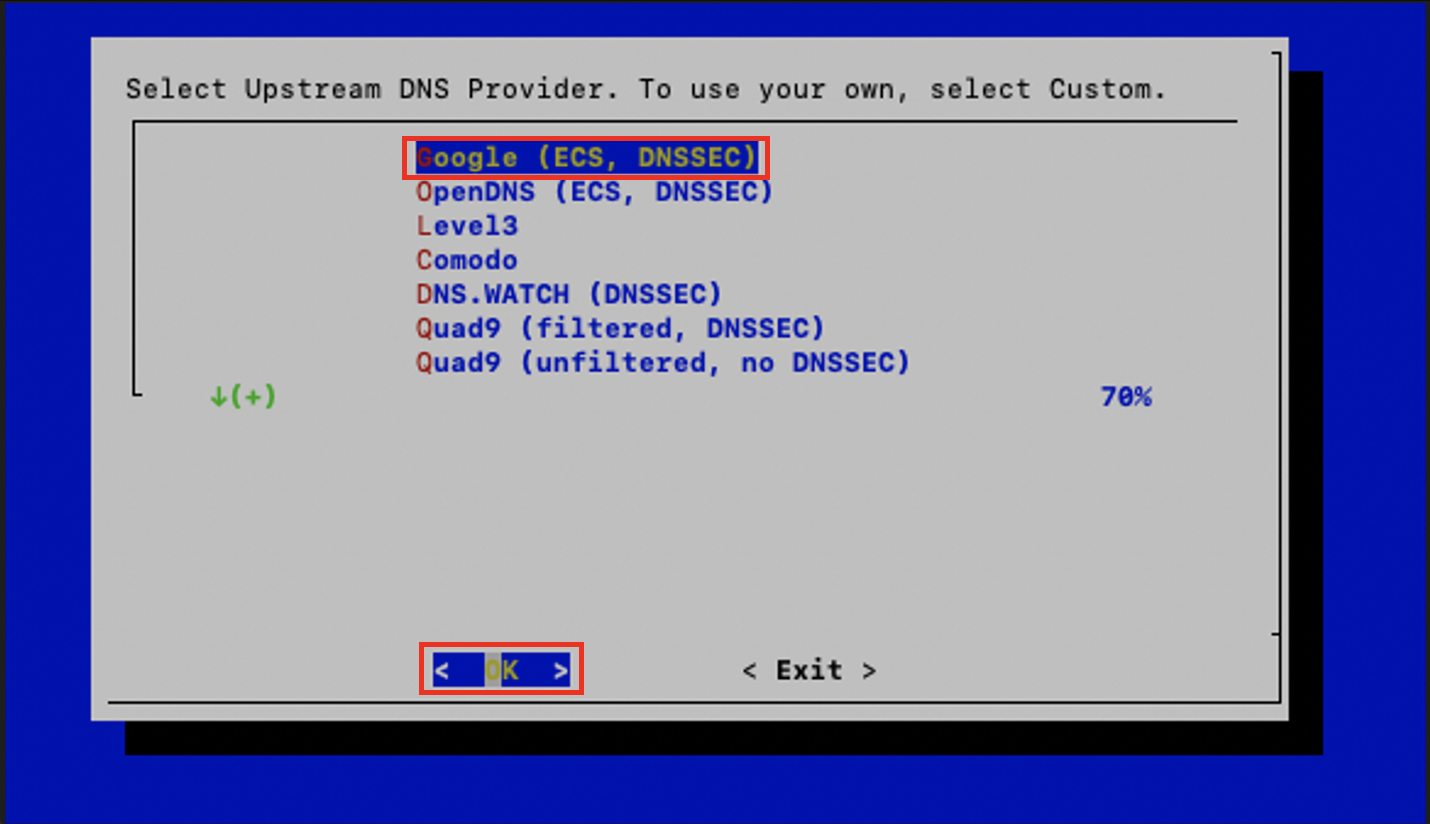
Upstream DNS プロバイダーを選択します。

私は Google を使っています。「OK」を押して、次に進みます。

「サードパーティーのブロックリストを使ってますよ」とのことです。

「OK」を押して、次に進みます。

ウェブベースの管理インターフェースです。

今後、Pi-Hole を管理する上で便利なのでインストールしておきましょう。

「Yes」を押して、次に進みます。

管理インターフェースがウェブベースですので、ウェブサーバーが必要となります。インストールしましょう。

Lighthttpd と PHP のモジュールを使っているようですね。

「Yes」を押して、次に進みます。

運用が始まってからの管理で、ログも必要になるはずです。ロギングも有効にします。

「Yes」を押して、次に進みます。

FTL の説明はこちらにあります。

「Show everything」を選択し、「Continue」を押します。

モジュールのインストールが始まります。

これには、結構時間がかかります。

私の環境では、20分くらいかかったと思います。Raspberry Pi はそれほどマシンパワーがないからでしょう。仮想マシンのLinuxにインストールした時は、数分で完了しました。

「Installation Complete!」のメッセージが表示されたら、インストールは無事完了です。

「OK」を押す前に、管理インターフェースのURLと、ログインパスワードが表示されていますので、メモしておきます。

「OK」を押して次に進むと、インストールの完了です。

早速、先ほどメモした内容で、管理インターフェースにログインしてみましょう。

フィルターカウンターが上がらない時の対応

最初にPi-Hole をインストールした時に遭遇した事象です。

テスト PC の DNS を Pi-Hole に向けてあるのですが、何もカウントが上がっていないようでした。

おかしいなあと悩んだ結果分かったのですが、Pi-Hole 側でもDNS の設定できるみたいです。

Settings > DNS  の画面に進み、「Upstream DNS Servers」のところに、Pi-Hole が問い合わせるNDS サーバーのIP アドレスを指定します。

ブロックカウンターが上がり、グラフも表示されるようになりました。

広告リストの追加

デフォルトで登録されている広告リストだけでは足りないので、さらに広告をブロックできるように、広告リストを追加します。

ウェブ管理画面にて、Adlists >> Adlist Group Management の順にアクセスして、広告リストを追加していきます。

The Firedog

緑色で表示されているものがお勧めのようです。

Setup Pihole To Block TikTok

pihole-block-tiktok

ポルノ系ブロックリスト

広告リストを追加したら、Update を行って適用しないといけません。忘れないようにUpdate しておきましょう。

Tools >> Update Gravity のページの Update ボタンです。

面白かったら、フォローしてください!

関連するブログ:

最近の人気ブログ TOP 10:

最近の記事: